

MySQL 高可用架构方案全解析:从基础复制到自动化集群

在构建 MySQL 数据库架构时,如何平衡数据安全、性能与运维复杂度是核心挑战。本文详解 MySQL 常见的十种高可用解决方案,涵盖标准主从复制、半同步机制、MGR 组复制、InnoDB 系列工具、MMM/MHA 脚本管理以及 Galera 和 NDB 分布式集群,助你精准选型。
1. MySQL Replication(标准主从复制)
这是最基础且应用最广泛的 MySQL 容灾方案,通过官方提供的复制技术实现单点写入、多点读取的架构,有效将读请求分散到多个从库,降低主库负载并提升资源利用率。
第 1 步:理解主从复制的工作原理
Master(主库):接收客户端写请求,执行更新操作并生成 binlog。
Slave(从库):通过三个关键线程完成数据同步:
IO Thread:连接主库,请求 binlog 日志并保存到本地的relay-log。Dump Thread:在主库端运行,响应从库请求并推送 binlog。SQL Thread:读取本地 relay-log,重放 SQL 语句以更新数据。
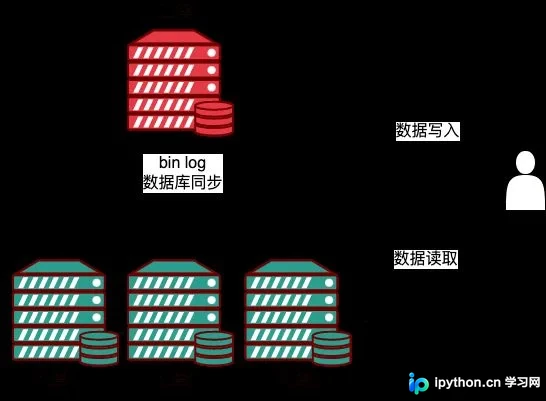
上述流程实现了数据的异步传播。虽然配置简单且支持备份与数据分析不干扰主库性能,但默认情况下存在明显的数据同步延迟风险。
第 2 步:解决主从延迟问题
主从延迟通常由以下因素引发,可针对性采取优化策略:
- 网络或 IO 瓶颈: 从库性能低于主库或在大量查询下 CPU 占用过高。解决方法包括升级硬件、减小节点压力,并在关键路径上采用半同步复制 (Semi-sync)。
- 大事务处理: 超大型 INSERT/UPDATE 导致传输时间长。建议拆分大事务或优化业务逻辑。
- 并发冲突: 对于无法忍受延迟的业务,可采用强行读主库的补偿机制。
第 3 步:演进同步模式
为平衡性能与数据一致性,MySQL 提供了多种同步模式:
- 异步复制 (Async): 默认模式,主库提交后不等从库 ACK,性能最好但有丢数据风险。
- 半同步复制 (Semi-sync): 自 5.5 引入插件支持。主库至少等待一个从库写入
Relay-Log即返回确认。这解决了部分数据不一致问题,但需防范主库在收到 ACK 后宕机导致的“已传未落盘”风险。 - 增强半同步复制: MySQL 5.7 改进版,要求从库不仅接收还要落盘后返回 ACK,主库才会 commit,安全性更高。
- 全同步复制: 等待所有从库完成才返回,极致安全但严重拖累性能,极少使用。
2. MySQL Group Replication (MGR 组复制)
MGR 是 Oracle 官方推出的高可用高扩展方案,旨在彻底解决传统主从复制中可能产生的数据不一致问题。
第 1 步:掌握核心特性
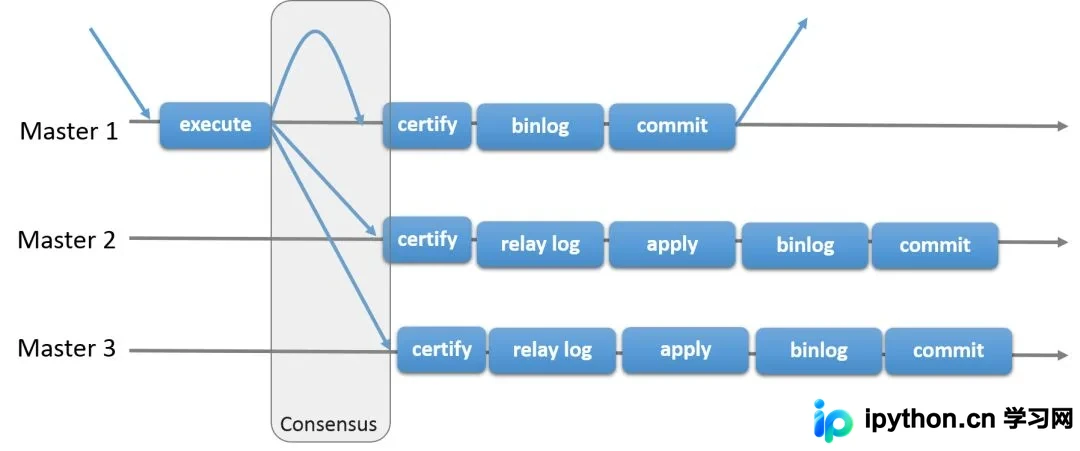
MGR 由多个节点组成一个复制组,任何事务的提交必须经过组内多数节点 (N / 2 + 1) 决议并广播成功方可生效,从而保证强一致性。
- 无脑裂: 通过内置共识协议自动隔离异常节点。
- 多节点写入: 支持多主(Multi-Primary)模式,所有节点均可处理写请求;也可设为单主模式以获得更稳定的写入体验。
- 防数据丢失: 只要同时宕机的节点不超过半数,且
Binlog Event未过半数传输,就不会发生数据丢失。
第 2 步:识别适用场景
- 弹性扩容: 云环境中动态增减数据库节点。
- 替代主从架构: 需要高性能并行读写及自动故障转移的场景。
- 自治系统: 利用其内置的原子广播和故障转移机制实现自动化运维。
3. InnoDB Cluster(官方集成集群)
InnoDB Cluster 是官方的一站式高可用解决方案,它将底层复杂的 MGR 技术封装,并提供自动化管理工具,极大降低了部署门槛。
第 1 步:组件构成与功能
一套标准的 InnoDB Cluster 包含三大组件:
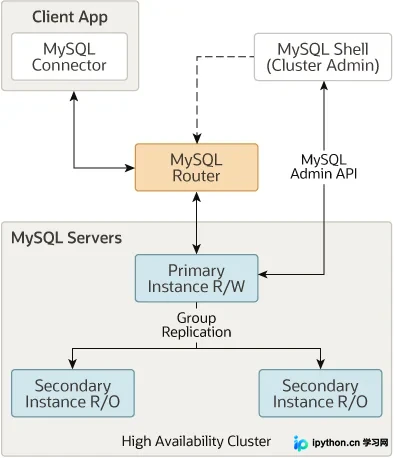
MySQL Shell:高级管理客户端,用于通过 AdminAPI 创建和维护集群。MySQL Server + MGR:基于 MGR 引擎构建的实际数据存储层,负责数据复制与容错。MySQL Router:轻量级中间件,负责将客户端连接智能路由至后端合适的实例(自动区分主从或分片)。
第 2 步:优缺点评估
优点: 具备全自动故障转移能力,管理员界面简洁,易于实施高可用架构。
局限: 对运维人员技术要求较高;由于强制的一致性检查,可能会引入一定的性能开销;且相比简单的复制结构更为复杂。
4. InnoDB ClusterSet(跨机房容灾)
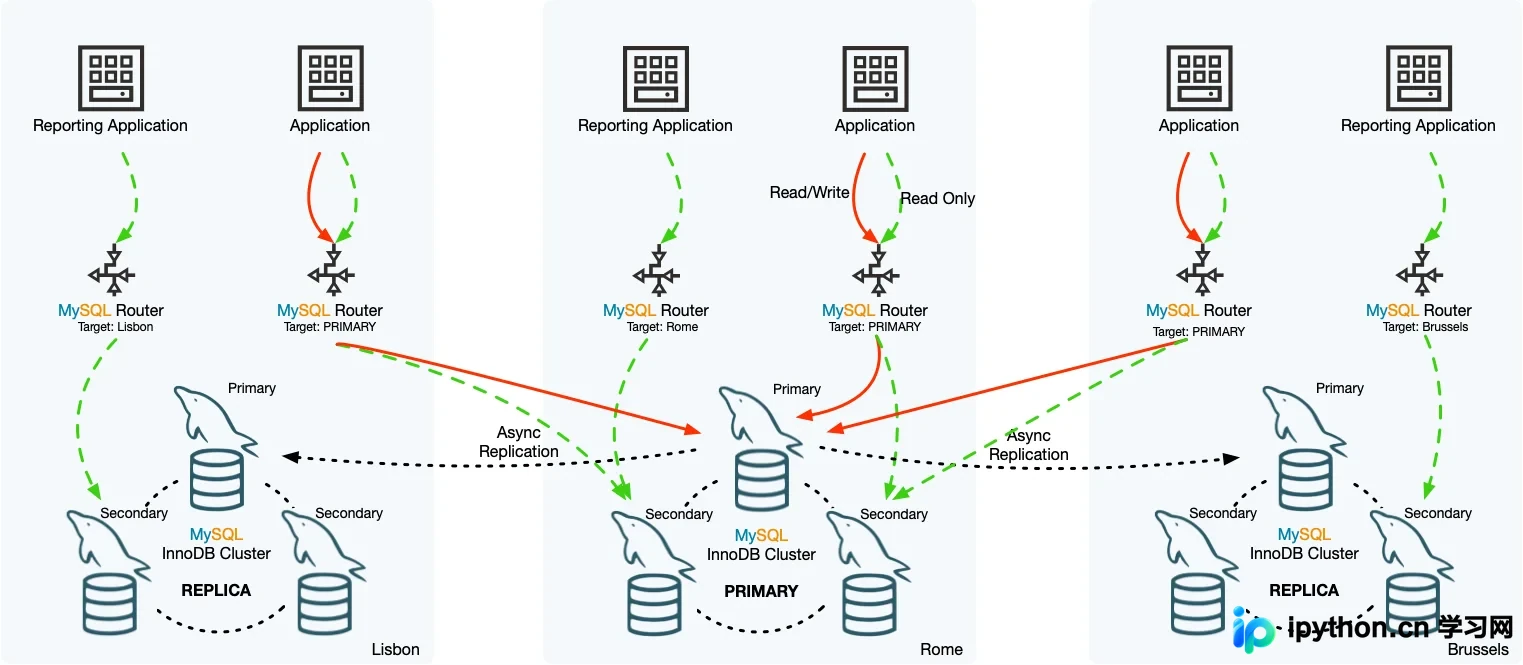
作为 InnoDB Cluster 的升级版,ClusterSet 提供了类似异地灾备的能力,将一个生产环境的 Cluster 与其备用位置的副本集群连接起来。
第 1 步:工作机制
主集群与副本集群之间通过专用的 clusterset_replication 异步通道进行数据同步。当主数据中心发生灾难时,管理员可通过 MySQL Shell 触发手动故障转移,激活备用副本集群以恢复服务。
第 2 步:限制与注意事项
- 仅支持异步复制: 这意味着它继承了一半同步和异步复制的缺陷(即数据延迟),无法做到绝对零丢失。
- 仅支持单主模式: 不能配置双活架构,因为跨中心保证双写一致性极难控制。
- 版本要求: 目前仅支持 MySQL 8.0。
5. InnoDB ReplicaSet(易用的读写分离套件)
InnoDB ReplicaSet 由 MySQL 团队于 2020 年推出,主要面向对高可用性要求不高、但强烈追求读取扩展性和写入性能的用户。
第 1 步:设计初衷
它底层依然使用的是经典的主从复制技术,而非 MGR。借助 MySQL Router 自动引导,用户可以快速建立主从拓扑,非常适合在不稳定或延迟较高的网络环境下部署,因为异步复制不会像 MGR 那样受限于网络 RTT。
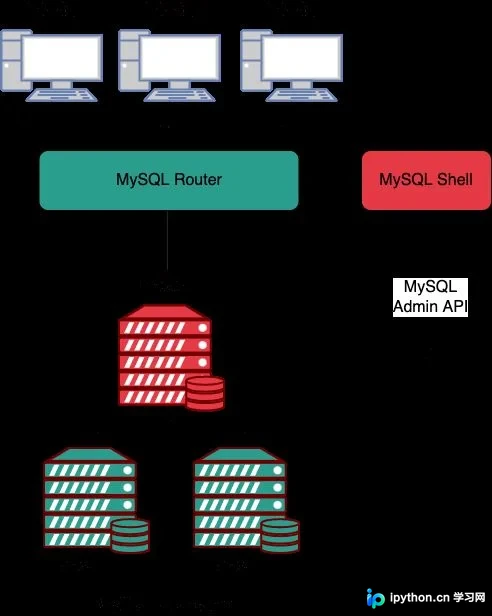
第 2 步:重要限制说明
- 无自动故障转移: 如果主节点挂掉,
Router会切断写入口,需要管理员手动介入切换角色,否则该集群停止接受写入(只读实例仍可提供读取)。 - 不支持多主: 只能有一台实例能写入,所有辅助节点均为只读。
- 监控压力: Router 需要对每个辅助实例进行健康检测,节点增多会导致管理负载上升。
6. MMM (Master-Master replication manager)
MMM 是一个基于 Perl 开发的开源脚本网关,专门用于管理 Master-Master(双主)复制环境中的故障切换与负载均衡。
第 1 步:高可用机制
MMM 引入了虚拟 IP (VIP) 的概念。通常情况下,集群中只有一个 VIP 指向活跃的主库供业务读写;一旦活跃主库宕机,VIP 会自动漂移到另一个主库上。
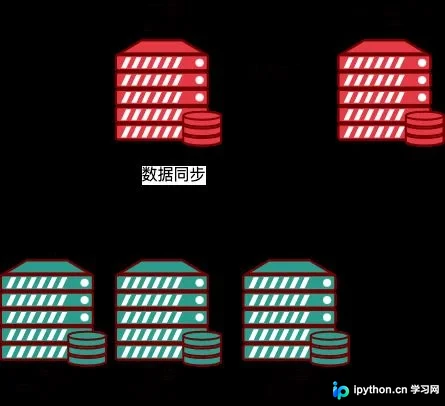
第 2 步:评价与现状
优势: 能实现双主的日常管理和平滑切换,适合业务增长快、读压力大的场景。
劣势:
- 本质上仍是主从复制,无法百分之百保证数据一致性(可能出现数据覆盖)。
- 维护停滞: 目前 MMM 社区维护已经几乎停止,且原生不支持基于 GTID 的复制模式,新项目不建议首选。
7. MHA (Master High Availability Manager)
MHA 是目前非常成熟的一款 MySQL 高可用软件。它的核心作用是监控主库状态,在发现主节点故障后,能在约 30 秒内自动将拥有最新数据的 Slave 提升为新 Master。
第 1 步:工作流程
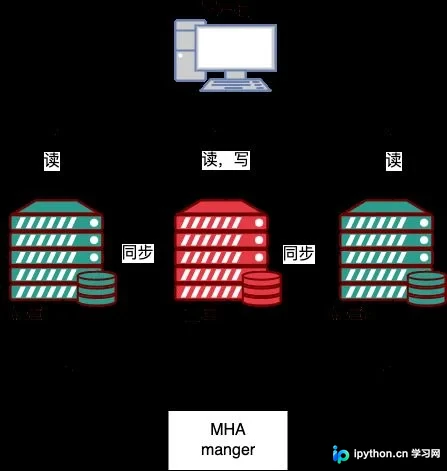
MHA Manager:独立部署或放在某台 Slave 上,负责定时探测并执行切换决策。MHA Node:安装在每台 MySQL 服务器上,协助保存二进制日志(Binlog events)。
最大亮点: 在自动切换前,MHA 会尝试从宕机主机获取尚未同步到任何其他 Slave 的 Binlog 日志,并人工补发给其他 Slave,以此最大程度减少数据丢失。
第 2 步:架构与配置须知
为了保证切换时的数据准确性,MHA 推荐一主二从(最少三台服务器)的架构。虽然它支持 GTID 复制且不产生数据不一致,但由于依赖 SSH 免密认证,存在一定安全隐患,且同样需要通过编写脚本或使用第三方工具配合实现 VIP 漂移。
8. Galera Cluster(多方写入集群)
Galera Cluster 是由 Codership 开发的同步复制方案(也是 MariaDB 的核心组件之一)。它最大的特点是真正的 Multi-Master(多主)模式,所有节点地位平等,均支持读写。
第 1 步:同步复制与冲突验证
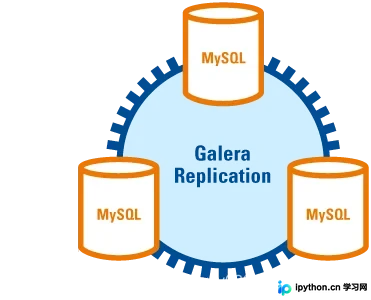
与传统复制不同,Galera 采用同步复制:当一个节点的客户端发出 commit 时,该事务的变更集(Write Set)会立即广播到所有其他节点。所有节点必须在本地执行校验(检查是否与未提交事务有行级冲突),全部成功后才算提交。
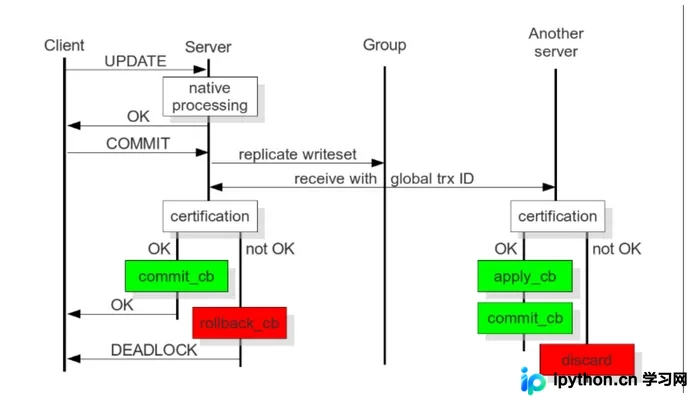
结果: 要么所有节点都成功提交,要么全部回滚。这保证了极高的数据一致性,但也带来了性能损耗——节点越多,协调事务顺序的开销越大,并发冲突死锁概率随之增加。
9. MySQL Cluster (NDB 存储引擎)
这是一种完全不同的分布式数据库架构,使用内存级的 NDB 存储引擎,支持 ACID 事务且不存在单点故障。它适用于对毫秒级低延迟和超高吞吐量有严苛要求的实时业务。
第 1 步:独特的节点划分
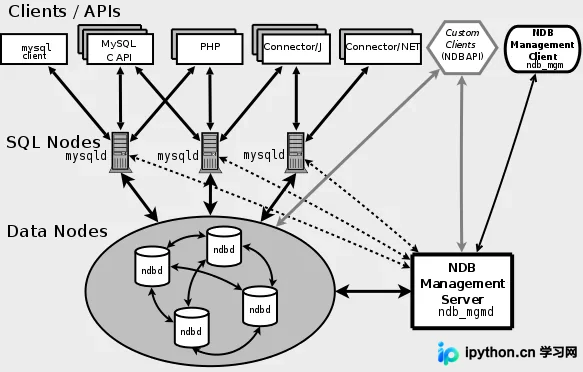
整个集群分为三类节点:
NDB Management Server:管理集群配置与健康。Data Nodes:真正存放数据分区和副本的地方(数据常驻内存)。SQL Nodes:提供对外 SQL 接口,类似于普通的 mysqld。
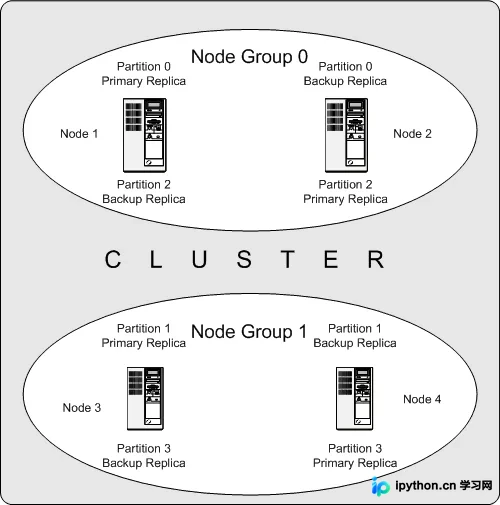
数据分片机制: 系统将数据打散为多个 Partition,并在不同的 Data Node 上进行交叉备份(Primary Replica & Backup Replica)。只要任一节点组内保留一台机器可用,集群数据就能保持完整。
第 2 步:硬性限制警告
尽管具有 99.999% 高可用性,但 NDB 引擎存在诸多制约:
- 不支持外键。
- 数据行大小受限(普通列不超过 8KB)。
- 重启 Data Node 时,需要将全量数据加载到内存,耗时极长。
- 运维配置极为复杂,不适合中小规模项目。
10. MySQL Fabric(数据分片框架)
Fabric 主要解决超大规模数据的水平切分(Sharding)问题,并结合了主从复制来保障每个分片的可用性。
第 1 步:运作模式
它将逻辑上的大表物理切割到多个数据库中。每个物理分片内部采用主从架构,Fabric 负责选出分片内的主库。当主库失效时,Fabric 会在该分片组内进行重新选举。
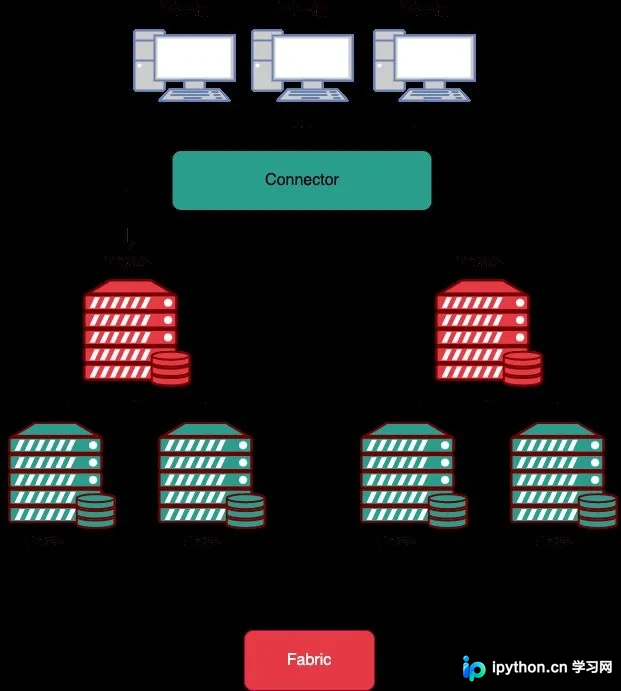
第 2 步:痛点
Fabric 最大的弊端在于无法跨分片操作。事务更新或 SQL 查询的数据必须限定在同一个分片内,这使得应用程序端的开发逻辑变得极其复杂。在实际工程落地中,它的使用频率远低于前几种方案。
总结
针对不同的业务阶段和核心诉求,推荐以下选型方向:
- 基础读写分离与成本敏感: 选择经典的
MySQL Replication(配合半同步防丢失)或轻量级的InnoDB ReplicaSet。 - 严格的高可用与数据一致性: 强烈推荐 Oracle 官方的
InnoDB Cluster(底层基于 MGR),它能自动化处理故障转移和路由,是目前企业级主流方案。 - 异地灾备: 在 8.0 版本基础上考虑
InnoDB ClusterSet。 - 特殊的多主写入或实时低延迟: 如果业务确实需要同构的多点写入,评估
Galera Cluster;若是海量高并发且可承受内存成本和开发限制,研究MySQL Cluster (NDB)。
以上就是 MySQL 中常见的几种高可用架构部署方案解析的详细内容,更多关于 MySQL 高可用部署的技术资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









