

C/C++程序链接原理与objdump反汇编实战:从目标文件到可执行文件的地址解析

C/C++程序构建的最后阶段是链接,旨在将独立的目标文件合并并解析所有符号引用。本文深入剖析链接过程中的重定位与引用解析机制,并通过使用objdump工具对目标文件与最终可执行文件进行反汇编对比,直观揭示内存地址从占位伪地址到绝对地址的转化逻辑,辅以完整的C代码示例与操作步骤,帮助开发者掌握底层链接原理。
链接阶段核心机制
在程序构建过程中,链接(Linking)接收一组目标文件作为输入。每个目标文件本质上是对单个源代码文件的二进制存储,内部包含多种节(Sections),如用于指令的代码段(.text)、已初始化全局数据段(.data)、未初始化的BSS段(.bss)以及只读数据段(.rdata)等。
链接器的核心任务是将这些分散的节组合成最终的程序内存映射,并在此过程中解决所有跨文件的符号引用问题。这一过程主要包含两个关键步骤:重定位与引用解析。
第1步:重定位(Relocation)
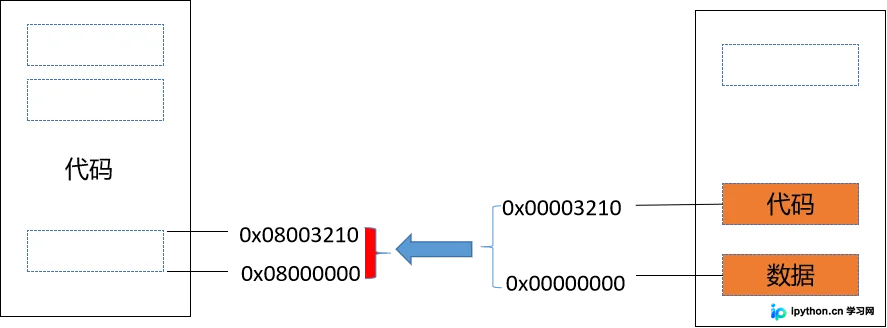
链接过程首先进行的是物理层面的拼接。系统将不同目标文件中相同类型的节合并到统一的程序内存映射中。例如,所有的代码段会被集中到一起,所有数据段也会被归类。
由于各个目标文件在编译时是基于其自身起始地址(通常假定为0)生成代码的,因此在拼接时需要调整相对偏移。这一阶段主要负责处理那些可以在链接时确定相对位置的结构,如图形所示,系统需要将原本预留的空间和基于0的相对地址范围,转换为更具体的程序内存映射中的绝对范围。
第2步:解析引用(Symbol Resolution)
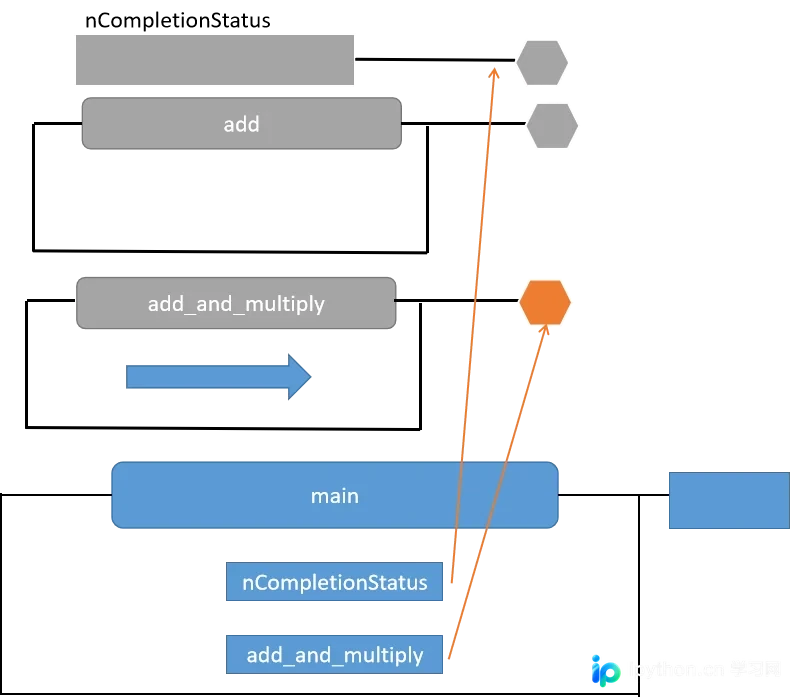
相较于简单的拼接,解析引用是链接中最具挑战性的部分。这涉及到建立不同部分代码之间的关联,确保整个程序能够作为一个统一的整体运行。
代码示例与场景分析
为了清晰说明,我们构建一个包含头文件、实现文件和主程序的简单案例:
1. 头文件 function.h
#pragma once
#define FIRST_OPTION
#ifdef FIRST_OPTION
#define MULTIPLIER (3.0)
#else
#define MULTIPLIER (2.0)
#endif
float add_and_multiply(float x, float y);
2. 实现文件 function.c
// #include "function.h"
int nCompletionStatus = 0;

float add(float x, float y) {
   float z = x + y;
   return z;
}

float add_and_multiply(float x, float y) {
   float z = add(x, y);
   z *= 3;
   return z;
}
3. 主文件 main.c
#include "function.h"
extern int nCompletionStatus;

int main(int argc, char* argv[]) {
    float x = 1.0;
    float y = 5.0;
    float z;

    // 调用同一源文件中的函数
    // z = add_and_multiply(x, y); // 注意:此处若直接调用add_and_multiply需extern声明或前置定义,但为演示引用解析,我们假设结构如下
    // 原文逻辑中 main 调用 add_and_multiply,且 引用 nCompletionStatus
    // 这里根据原文修正:main.c 应调用 add_and_multiply,而 add_and_multiply 内部调用 add

    // 模拟原文意图:main 调用另一个模块的函数并引用变量
    // 假设 add_and_multiply 被 extern 引入,或者结构微调
    // 按照原文描述重点在于 cross-file referencing:
    // 1. add_and_multiply (in function.c) calls add (in function.c) -> Resolved at compile time relative to .text base.
    // 2. main (in main.c) calls add_and_multiply and references nCompletionStatus -> Unresolved until link time.

    return 0;
}
在上述结构中,存在两种不同性质的引用:
- 内部引用:
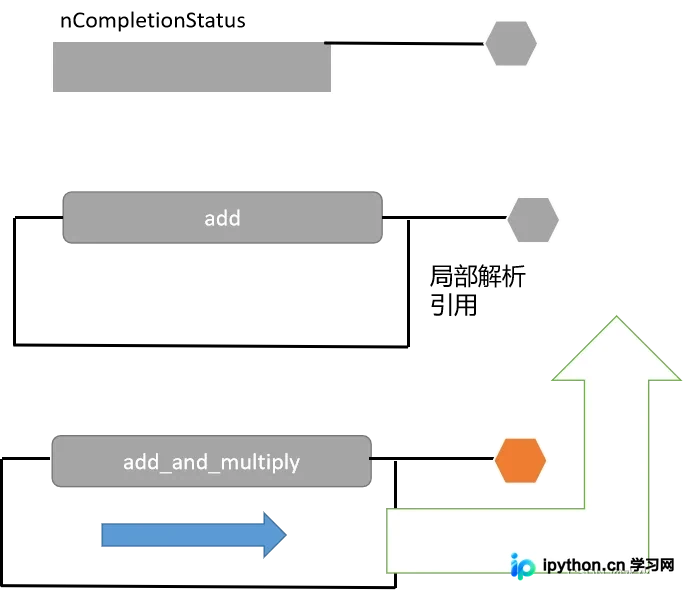
add_and_multiply函数内部调用了add函数。由于两者位于同一个源代码文件,编译器在编译时即可知道add函数相对于当前代码段起始地址的偏移量。因此,这被视为已知量,指令中会直接扩展为该相对偏移。 - 外部引用:
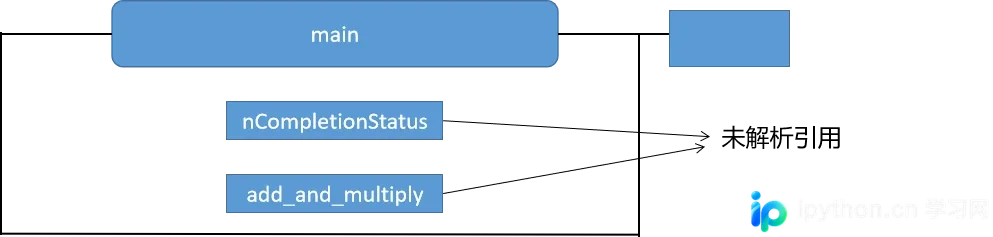
main函数需要调用add_and_multiply(位于function.c)并访问全局变量nCompletionStatus。此时,编译器无法知道这些符号在最终进程内存中的确切位置。编译器会假定它们未来存在,但在生成完整内存映射之前,这些引用被称为“未解析引用”,需要使用占位符。
这种未解析状态在目标文件中体现为指向特定符号表的入口,具体见下方图示:
function.o 内部结构示意:
main.o 外部引用示意:
引用解析的具体动作
链接器在最终阶段必须解决这些问题,具体流程包括:
- 检查已拼接至程序内存映射中的所有节,建立统一的命名空间。
- 识别出哪些机器指令涉及外部符号调用或数据引用。
- 计算该引用的精确绝对地址(即在最终内存映射中的地址)。
- 将指令中原本的占位伪地址(Pseudo-address)替换为真实的绝对地址,从而完成引用的解析。
objdump反汇编实战
理论概念可以通过实际操作验证。下面我们将使用 GCC 编译上述代码,并利用 objdump 工具查看汇编指令的差异,以观察链接器的工作成果。
准备环境与编译
首先,编译源文件生成目标文件,并将它们链接成可执行程序:
gcc -c function.c main.c
gcc function.o main.o -o demoApp
目标文件阶段的反汇编分析
在未链接之前,查看 main.o 的反汇编代码:
objdump -D -M intel main.o
在反汇编结果中,寻找指向 add_and_multiply 或相关外部符号的跳转指令。你会注意到这些跳转往往指向一个特定的偏移量或是一个看起来像是“自身”的地址。这是因为链接器尚未介入,编译器不知道函数的实际加载地址,只能先用伪地址(Placeholder)代替。
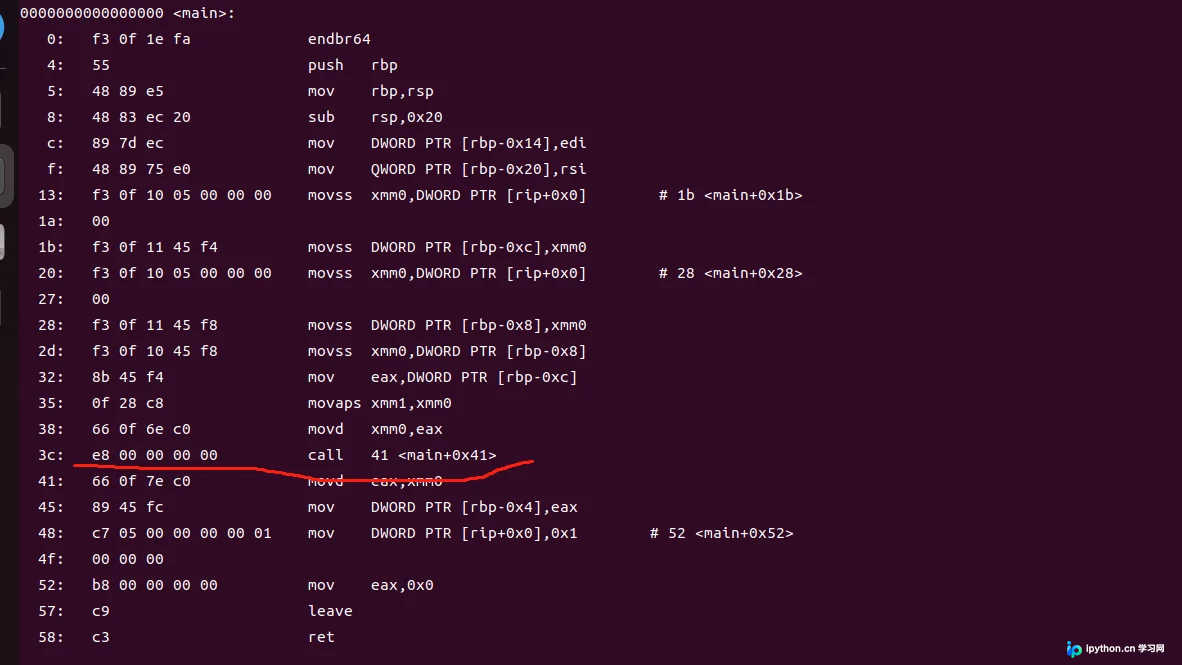
注:图中红线标注处显示跳转至自身或特定偏移,这正是未解析引用的典型特征——链接器介入前,这部分内容是不确定的。
可执行文件阶段的反汇编分析
现在,对比链接后的可执行文件 demoApp:
objdump -D -M intel demoApp
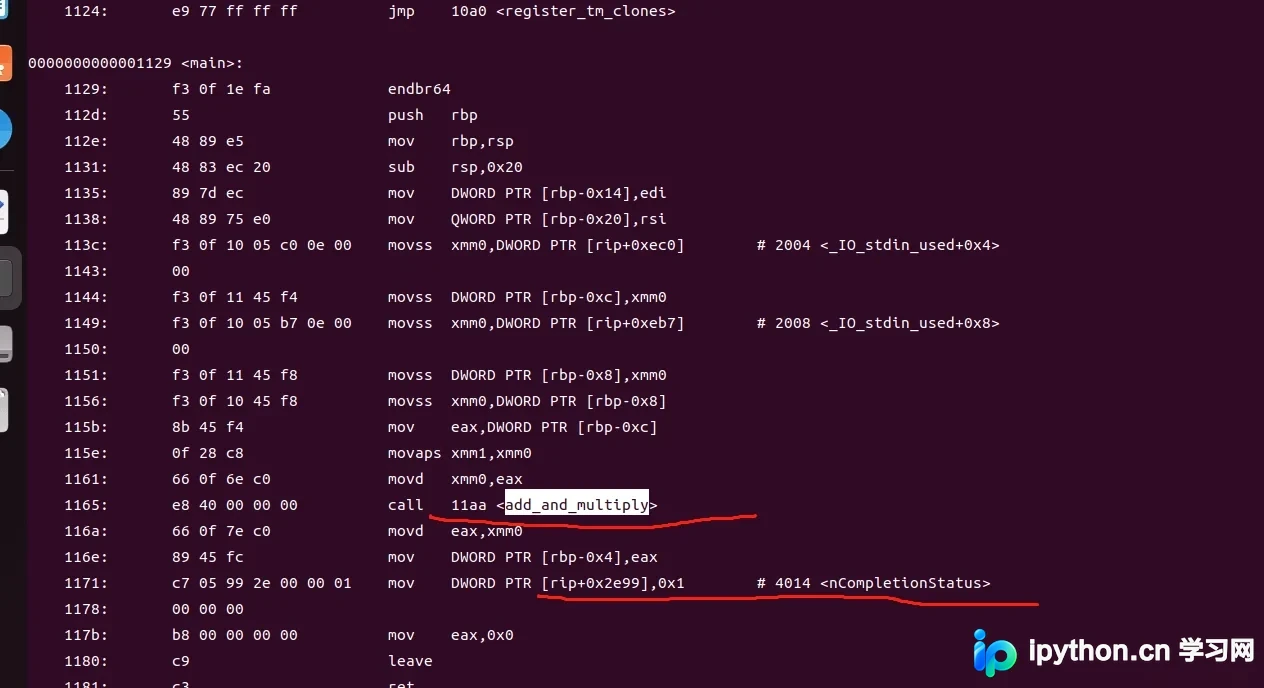
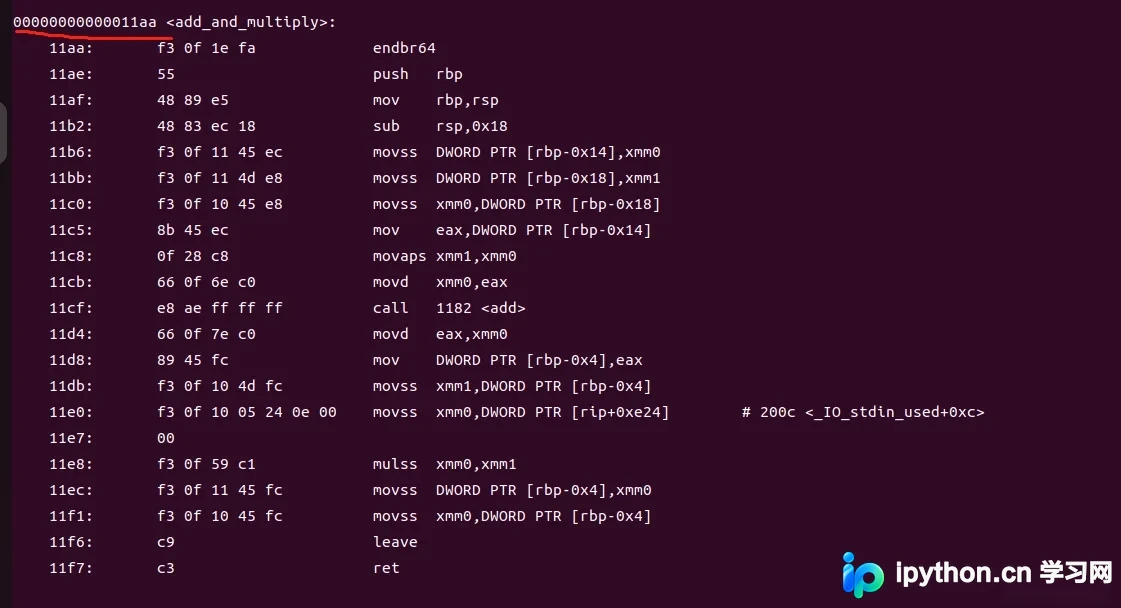
仔细观察画红线的区域,你会发现之前的“伪地址”已经消失了。取而代之的是具体的十六进制地址,例如 11aa 或 40xx 这样的绝对地址。这就是链接器完成了“重定位表”处理后,将所有分散的代码和数据映射到连续内存空间的结果。
查看特定段的信息
如果我们想专门查看未初始化全局变量 nCompletionStatus 在 BSS 段中的位置及其地址,可以使用 -x 参数配合节名筛选:
objdump -x -j .bss demoApp
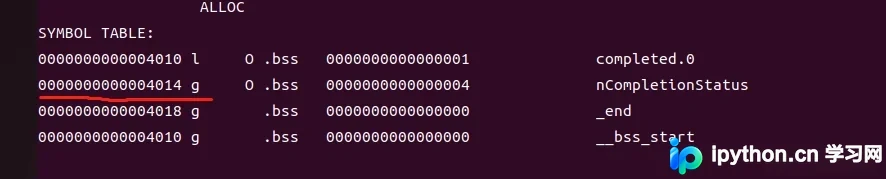
执行此命令后,可以看到 nCompletionStatus 被分配到了具体的内存地址(如示例中的 4014... 地址附近)。这证实了链接器不仅解析了指令调用,还正确地为全局变量划分了内存空间。
简要总结
通过上述步骤可以看出,C/C++程序的构建不仅仅是简单的代码堆砌,而是一个精密的地址映射过程。objdump 作为强大的反汇编工具,能够让我们窥探编译器和链接器的内部工作:从目标文件中的占位符(Unresolved Relocations),到最终可执行文件中指向真实内存位置的绝对跳转,清晰地展示了程序从“片段”到“整体”的蜕变。
掌握这一原理,对于调试复杂的链接错误、理解动态库加载以及进行性能优化具有重要意义。以上就是关于C/C++程序链接原理与objdump反汇编实战的详细内容,更多关于C++编译链接优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









