

MySQL utf8 与 utf8mb4 的区别及设置指南

在 MySQL 数据库中,utf8 并非标准的 UTF-8,而是最大只支持 3 字节字符的内部实现。这导致 Emoji 等 4 字节 Unicode 字符无法写入并引发乱码。本文将解释两者差异,并提供从字符集设置到连接配置的完整解决方案。
一、为什么需要区分 utf8 和 utf8mb4
许多开发者误以为 MySQL 的 utf8 等同于标准 UTF-8,但实际上它在 MySQL 内部仅支持最多 3 个字节 per character。这意味着它无法处理占 4 个字节的 Unicode 字符(如大部分 Emoji 表情符号)。
为解决这个问题,MySQL 5.5.3 版本后引入了 utf8mb4。其中 mb4 代表 most bytes 4,即兼容四字节的 UTF-8 编码。它是标准 UTF-8 的超集,除了命名不同外,存储和读取行为与真正的 UTF-8 一致。
此外,MySQL 对 varchar 类型的长度是按字符数计算而非字节数。如果字段定义为 varchar(10),表示最多容纳 10 个字符。在使用 utf8 时,由于每个字符最大 3 字节,数据库需要解析字符串来确定字符数量;若遇到 4 字节字符且配置错误,解析逻辑会出错从而拒绝写入。
二、如何正确设置 utf8mb4
要彻底支持 Emoji 等特殊字符,必须确保数据从存储到传输链路全程使用 utf8mb4。操作分为以下几个层面:
第 1 步:检查当前系统状态
首先确认当前的字符集设置。执行以下 SQL 命令查看服务端、数据库及连接层的编码:
mysql> show variables like '%char%';重点关注 character_set_server 和 character_set_database。如果显示为 utf8,则需要逐步修改。
第 2 步:修改目标字段或表的字符集
根据需求精度,可以选择修改字段、表或整个数据库:
- 针对单个字段:将特定列改为 utf8mb4,不影响其他列。
ALTER TABLE table_name MODIFY COLUMN column_name VARCHAR(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci; - 针对整张表:修改默认字符集。注意,已存在的字段不会自动改变,新建的字段才会应用新默认值。必须先手动转换存量字段:
ALTER TABLE table_name CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci; - 针对整个数据库:
ALTER DATABASE database_name CHARACTER SET = utf8mb4 COLLATE = utf8mb4_unicode_ci;
第 3 步:配置客户端连接
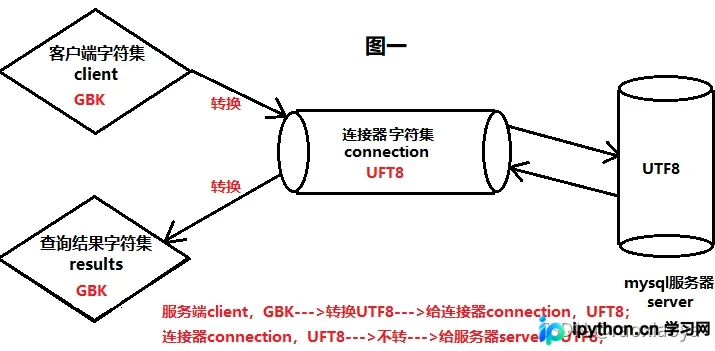
即使服务器端是 utf8mb4,如果客户端连接时未指定相应编码,依然会发生乱码或写入失败。因为 MySQL 有一个“连接器组件”,负责在客户端和服务端之间进行字符集转换。如果客户端声明使用的是 utf8(仅限 3 字节),而传入的是 4 字节数据,转换器可能会报错或截断。
建立连接时必须显式指明编码方式:
# 命令行示例
mysql -u username -p --default-character-set=utf8mb4

# 或者在执行查询前运行
SET NAMES utf8mb4;
SET NAMES utf8mb4 会同时设置 character_set_client、character_set_connection 和 character_set_results。对于应用程序代码(如 PHP, Python, Java 等),需要在数据库连接字符串中添加 charset=utf8mb4 参数。
第 4 步:处理可视化工具(Navicat)的情况
在使用 Navicat 等工具导入或导出数据时,容易忽略编码一致性导致的问题。例如,如果在 utf8 环境下先将包含 Emoji 的数据同步到本地测试库,再切换为 utf8mb4,原本受损的数据无法恢复,仍显示为问号。
注:图示展示了 MySQL 支持的多种字符集列表,其中 utf8mb4 的最大长度为 4。
排错建议:如果发现表情显示异常,请先备份数据。确保在导入数据前,目标表的字符集已经是 utf8mb4,并且在 Navicat 的属性选项中将连接编码设置为 utf8mb4,重新拉取一次数据即可正常显示。
三、原理解析:连接器的转码机制
为了理解为何乱码会发生,需要了解 MySQL 客户端与服务端的交互流程:
- 请求阶段:客户端发送数据时,按
character_set_client编码发送给服务端。服务端通过character_set_connection转换为内部的二进制格式,并根据目标字段的character_set_server(如果是不同字符集还会做二次转换)存入数据。 - 响应阶段:服务端取出数据,按
character_set_connection转换回标准格式,最后按character_set_results编码返回给客户端展示。
如果字段存的是 utf8mb4 的 4 字节数据,但客户端连接的 character_set_results 是 utf8,连接器会将 4 字节尝试强转为 3 字节体系,必然产生乱码。反之,如果写入时用的是 utf8 链接,4 字节字符在发送阶段就会被拦截报错。
四、总结
在处理多语言混合文本及表情符号时,务必统一使用 utf8mb4。这不仅涉及建表时的字符集定义,更关乎连接链路的每一环节。检查并修改服务器配置、表结构属性以及程序连接的参数,是避免此类问题的关键。
以上就是 MySQL 中 utf8 与 utf8mb4 的存储及区别的详细内容,更多关于 MySQL 字符集优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









