

详解C/C++高精度(加减乘除)算法中的压位优化

传统C/C++高精度算法通常采用数组元素存储1位十进制数字,这种方式虽然简单,但在处理大数运算时效率较低且浪费内存空间。为了提高性能,可以采用“压位优化”策略,即在32位整型数组中每个元素存储多位数字(通常为8到9位)。本文将深入解析这一原理,并提供可直接用于项目的完整C++代码实现,以及基于真实硬件的性能对比测试数据。
基本原理与存储机制
压位优化的核心在于改变数据存储密度。以32位有符号整数为例,其最大值约为 $2 \times 10^9$,因此每个数组元素最多可以安全存储9位十进制数字。这种存储方式大幅减少了数组长度,从而降低了循环次数和内存访问开销。
1、数据结构示意
假设我们采用存储4位的模式进行演示,原本需要存储5个元素的数值,现在只需2个元素即可表示。高位在前还是低位在前取决于实现逻辑,通常在内部计算中,a[0] 用于记录当前数组的有效长度(位数),而 a[1]~a[n] 从低位到高位存储具体的数值块。例如: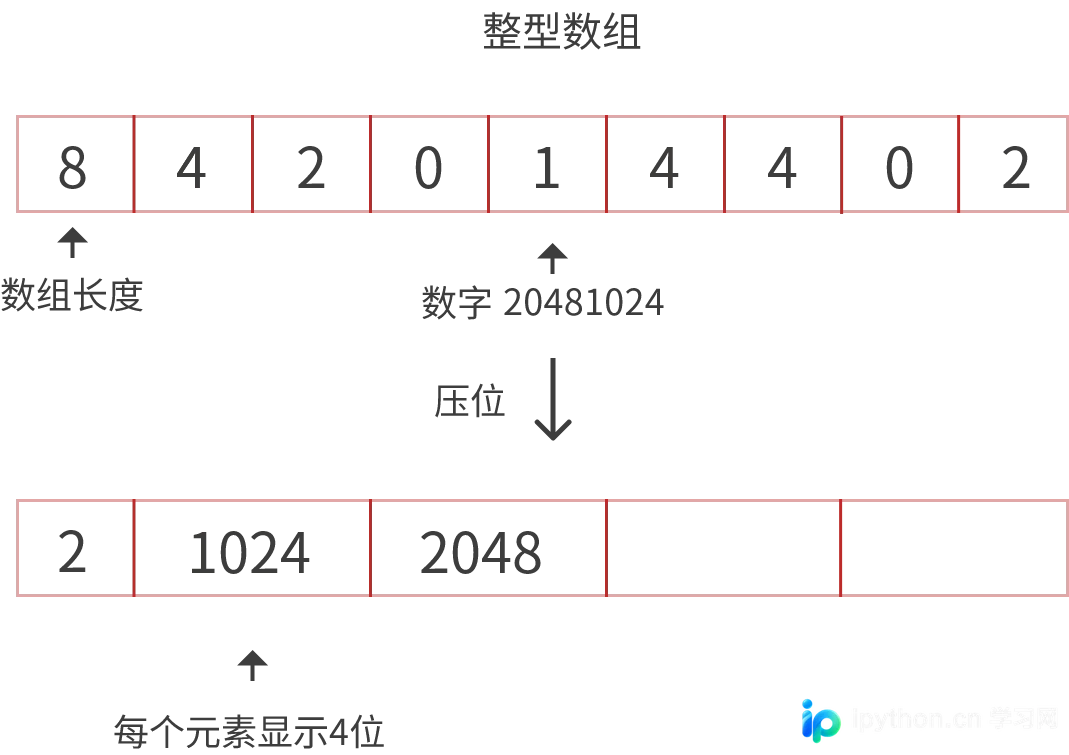
2、竖式计算原理
运算逻辑与传统竖式一致,但基数变为 $10^k$(如 $10^9$)而非 $10$。以加法为例,将两个数的对应块相加,若结果超过基值(如大于等于 $1000000000$),则向高位进位。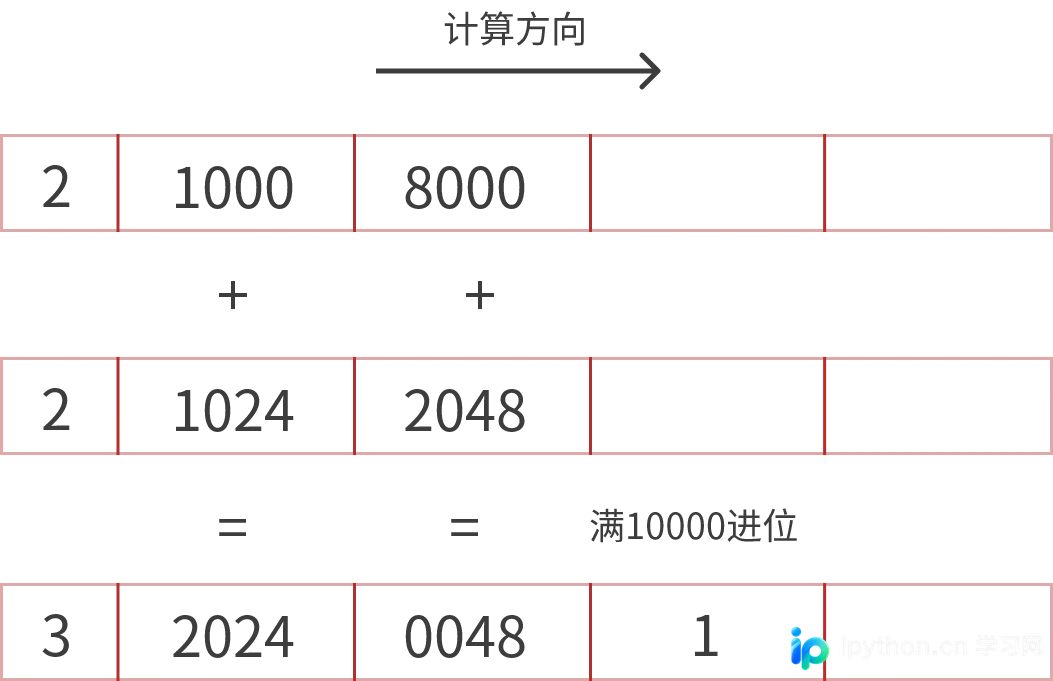
完整代码实现
以下代码实现了基于压9位优化的高精度算法,包含加减乘除及取余等常用操作。接口设计兼容普通整型与字符串输入,方便迁移使用。
第1步:初始化与转换
目的:将外部输入的字符串或64位整型转换为内部压位数组格式,确保低位对齐以便计算。
#include <stdio.h>
#include <string.h>
#include <math.h>
#include <stdint.h>

// 辅助宏定义
#define BASE 1000000000

/// 通过字符串初始化高精度数组
static void loadStr(int* a, const char* value) {
	int len = strlen(value);
	int left = len % 9;
	char s[8], * p = (char*)value + left;
	a[0] = ceil(len / 9.0);
	len = len / 9.0;
	for (int i = 1; i <= len; i++)
		sscanf(p + (len - i ) * 9, "%09d", &a[i]);
	if (left){
		sprintf(s, "%%0%dd", left);
		sscanf(value, s, &a[a[0]]);
	}
}

/// 通过无符号整型初始化
static void loadInt(int* a, uint64_t value) {
	a[0] = 0;
	while (value)a[++a[0]] = value % BASE, value /= BASE;
}

/// 高精度数组转字符串输出
static void toStr(int* a, char* str) {
	if (!a[0]) {
		sprintf(str, "0");
		return;
	}
	sprintf(str, "%d", a[a[0]]);
	str += strlen(str);
	for (int i = a[0]-1; i > 0; i--)
		sprintf(str +( a[0] -i-1)*9, "%09d", a[i]);
	str[(a[0]-1)*9] = '\0';
}

/// 打印输出结果(简化版)
static void print(int* a) {
	int i = a[0];
	printf("%d", a[i--]);
	for (; i > 0; i--)printf("%09d", a[i]);
	printf("\n");
}
第2步:比较与赋值操作
目的:建立高精度数之间的大小比较机制,支持拷贝操作,为后续算术运算做准备。
// 比较两个高精度数的大小: 返回 1(a>b), 0(a==b), -1(a<b)
static int compare(int* a, int* b) {
	if (a[0] > b[0]) return 1;
	if (a[0] < b[0]) return -1;
	for (int i = a[0]; i > 0; i--)
		if (a[i] > b[i]) return 1;
		else if (a[i] < b[i]) return -1;
	return 0;
}

// 复制高精度数
static void copy(int* a, int* b) {
	memcpy(b, a, (a[0] + 1) * sizeof(int));
}
第3步:加法与减法实现
目的:实现带进位/借位的基础加减法逻辑。需注意减法中需保证被减数不小于减数(或需自行处理负号逻辑)。
/// 加法: c = a + b
static void plus(int* a, int* b, int* c) {
	int* p;
	if (a[0] < b[0]) p = a, a = b, b = p; // 确保 a 是较长的数
	int i = 1, alen = a[0], blen = b[0];
	c[0] = c[alen + 1] = 0;
	// 直接拷贝多出的高位部分
	if (a != c) memcpy(c + blen + 1, a + blen + 1, (alen - blen) * sizeof(int));

	for (; i <= blen; i++) {
		c[i] = a[i] + b[i];
		if (c[i - 1] >= BASE) c[i - 1] -= BASE, c[i]++;
	}
	i--;
	while (c[i++] >= BASE) c[i - 1] -= BASE, c[i]++;
	c[0] = c[alen + 1] ? alen + 1 : alen;
}

/// 减法: c = a - b (要求 a >= b)
static void sub(int* a, int* b, int* c) {
	int i = 1, alen = a[0];
	if (a != c) memcpy(c + b[0] + 1, a + b[0] + 1, (a[0] - b[0]) * sizeof(int));
	c[0] = 1;
	for (; i <= b[0]; i++) {
		c[i] = a[i] - b[i];
		if (c[i - 1] < 0) c[i - 1] += BASE, c[i]--;
	}
	i--;
	while (c[i++] < 0) c[i - 1] += BASE, c[i]--;
	while (!c[alen--]);
	c[0] = alen + 1;
}
第4步:乘法实现
目的:模拟竖式乘法,累加部分积并处理进位。注意中间变量需使用 int64_t 防止溢出。
/// 乘法: c = a * b
static void mul(int* a, int* b, int* c) {
	int len = a[0] + b[0], d = 0;
	memset(c, 0, sizeof(int) * (len + 1));
	b[b[0] + 1] = 0; c[0] = 1;

	for (int i = 1; i <= a[0]; i++)
		for (int j = 1; j <= b[0] + 1; j++){
			int64_t t = (int64_t)a[i] * b[j] + c[j + i - 1] + d;
			c[j + i - 1] = t % BASE;
			d = t / BASE;
		}
	while (!c[len]) len--;
	c[0] = len;
}
第5步:除法实现
目的:实现商和余数计算。采用试商法,利用高位估算商的初始值以提高效率。
/// 除法: c = a / b, mod = a % b
static void div(int* a, int* b, int* c, int* mod) {
	int len = a[0] - b[0] + 1, times, hTimes[32], * temp = c + a[0] + 1;
	if (!mod) mod = temp + 2*(a[0] + 1)+1;

	memcpy(mod, a, (a[0] + 1) * sizeof(int));
	memset(c, 0, sizeof(int) * (len + 1));
	memset(temp, 0, sizeof(int) * len);
	c[0] = 1;

	for (int i = len; i > 0; i--) {
		memcpy(temp + i, b + 1, sizeof(int) * b[0]);
		temp[0] = b[0] + i - 1;
		while (compare(mod, temp) != -1) {
			// 估算倍数
			if (times = (mod[mod[0]] * ((mod[0] - temp[0]) ? BASE : 1)) / (temp[temp[0]] + (temp[0] == 1 ? 0 : 1))) {
				loadInt(hTimes, times);
				mulq(temp, hTimes);
			} else { times = 1; }

			while (compare(mod, temp) != -1) subq(mod, temp), c[i] += times;
			memcpy(temp + i, b + 1, sizeof(int) * b[0]);
			temp[0] = b[0] + i - 1;
		}
	}
	while (!c[len]) len--;
	c[0] = len;
}

// 简单的自更新辅助函数
static void plusq(int* a, int* b) { plus(a, b, a); }
static void subq(int* a, int* b) { sub(a, b, a); }
static void mulq(int* a, int* b) {
    int* c = a + a[0] + b[0] + 1;
    memcpy(c, a, (a[0] + 1) * sizeof(int));
    mul(c, b, a);
}
static void divq(int* a, int* b, int* mod) { div(a, b, a, mod); }
性能对比分析
为了量化压位优化的效果,我们在 Windows 11 系统(Intel Core i7-8750H)上进行了对比测试。测试对象分别为传统的“1位1存”实现和本次的“9位压位”实现。所有测试均为5次运行取平均值。
测试环境与用例
- 测试平台:Windows 11, Intel Core i7 8750H
- 测试方法:执行特定操作 500,000 次(乘法和除法部分子集取 1,000 次),计算总耗时均值。
- 测试用例:
- 用例1:整型范围小数字计算(约5万以内)。
- 用例2:超长数字与较小整数计算(约40位长数 vs 短整型)。
- 用例3:超长数字与超长数字相互计算(两个约40位长数运算)。
耗时测试结果对比
下表展示了不同运算在不同用例下的耗时表现,可见9位压位在所有场景下均具有绝对的速度优势。
| 运算类型 | 测试用例 | 1位实现耗时 (s) | 9位压位耗时 (s) |
|---|---|---|---|
| 加法 | 用例1 | 0.003926 | 0.002620 |
| 加法 | 用例2 | 0.026735 | 0.005711 |
| 加法 | 用例3 | 0.029378 | 0.005384 |
| 累加(+=) | 用例1 | 0.003255 | 0.002536 |
| 累加(+=) | 用例2 | 0.017843 | 0.002592 |
| 累加(+=) | 用例3 | 0.034025 | 0.006474 |
| 减法 | 用例1 | 0.004237 | 0.002078 |
| 减法 | 用例2 | 0.024775 | 0.004939 |
| 减法 | 用例3 | 0.027634 | 0.004929 |
| 累减(-=) | 用例1 | 0.004272 | 0.002034 |
| 累减(-=) | 用例2 | 0.005407 | 0.001942 |
| 累减(-=) | 用例3 | 0.019363 | 0.004282 |
| 乘法 (*) | 用例1 | 0.043608 | 0.004751 |
| 乘法 (*) | 用例2 | 0.479071 | 0.028358 |
| 乘法 (*) | 用例3 | 3.375447 | 0.064259 |
| 累乘(*=) | 用例1 (1k次) | 0.001237 | 0.000137 |
| 累乘(*=) | 用例2 (1k次) | 0.001577 | 0.000187 |
| 累乘(*=) | 用例3 (1k次) | 5.792887 | 0.081988 |
| 除法 (/) | 用例1 | 0.025391 | 0.024763 |
| 除法 (/) | 用例2 | 5.292809 | 0.516090 |
| 除法 (/) | 用例3 | 0.395773 | 0.073812 |
| 累除(/=) | 用例1 (1k次) | 0.059054 | 0.035722 |
| 累除(/=) | 用例2 (1k次) | 0.103727 | 0.060936 |
| 累除(/=) | 用例3 (1k次) | 89.748837 | 25.126072 |
速度提升总结
根据上述数据分类汇总,可以直观地看到压位带来的巨大性能红利。特别是在涉及大量数据的乘法和除法运算中,9位压位方案的速度提升了数倍甚至数十倍。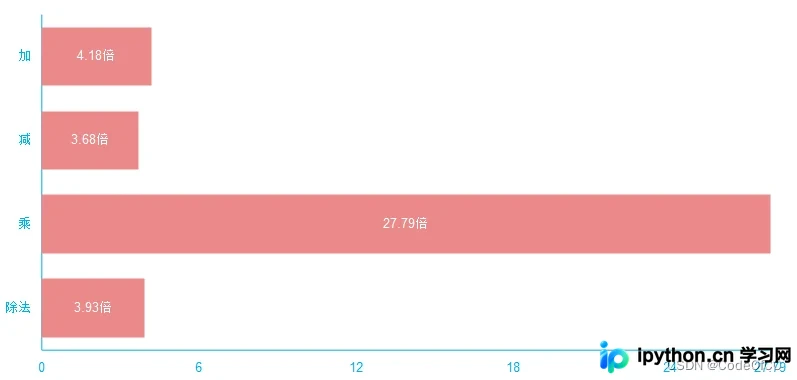
总结
通过对 C/C++ 高精度算法引入压位优化(每位存储 9 位十进制数),我们能够显著降低内存占用并大幅提升计算吞吐量。实现逻辑上仅需调整进位基数和格式化输出细节,原有算法框架依然适用。
从性能测试结果来看,压位优化带来的提升是显而易见的,对于时间和空间要求苛刻的应用场景非常适用。以上就是对 C/C++ 高精度算法压位优化的详细解析,更多关于底层算法优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









