

Python自动将文本文件转换为Excel表格

本文详细讲解如何使用Python的openpyxl库,将逗号或中文逗号分隔的纯文本文件自动转换为规范的Excel工作簿。通过统一分隔符替换、按行解析结构与精准写入单元格,快速实现非结构化文本到表格数据的批量迁移,附带完整代码与常见异常排查方案。
转换目标与环境准备
在实际工作中,经常需要借助表格工具分析数据。当原始数据为纯文本(如名单、日志或报表片段)时,手动复制粘贴不仅耗时且极易错位。本文提供一套基于openpyxl的自动化方案,专门处理具有固定换行与分隔规律的文本数据。
第1步:安装依赖库
打开系统终端或命令行工具,执行以下指令获取核心组件:
pip install openpyxl安装成功后,在Python文件中引入工作簿对象即可进入编码阶段:
from openpyxl import Workbook
wb = Workbook()
ws = wb.active
第2步:分析源文件结构规律
自动化转换的成功率取决于对原始数据的结构认知。以典型的逗号分隔名单为例,规范格式如下:
姓名,性别,年龄
zack,男,21
rudy,男,22
alice,女,20
atom,男, 23
此类文件通常具备三个显性特征:首行为字段表头,后续每一行代表一条独立记录,单元格值由英文逗号或中文逗号分隔,且部分字段会混杂前后空格。锁定这些规律后,脚本只需执行“统一分隔符 → 按行拆分 → 注入序列号 → 写入单元格”的标准流程。
第3步:编写转换逻辑并执行
将上述规律转化为实际代码,重点处理中英标点差异,并在每行起始位置插入序号列以保证列宽对齐。完整脚本如下:
from openpyxl import Workbook

wb = Workbook()
ws = wb.active

# 读取并清洗原始文本内容
with open("test.txt", "r", encoding="utf-8") as f:
    # 将英文逗号与中文逗号统一映射为制表符,确保后续切片能精准对应Excel列
    content = f.read().replace(",", "\t").replace(",", "\t")
    lines = content.split("\n")

    # 提取首行作为表头,首列预留空白占位以匹配后续序号列
    titles = lines[0].split("\t")
    titles.insert(0, "")
    ws.append(titles)

    # 逐行解析数据并写入工作表
    for i, line in enumerate(lines[1:], start=1):
        item = line.split("\t")
        # 过滤因源文件末尾换行符产生的无效空行
        if not item or len(item) == 1 and item[0] == "":
            continue
        # 在行首插入递增序号,保持单元格总数与表头一致
        item.insert(0, i)
        ws.append(item)

# 导出最终结果
wb.save("output.xlsx")
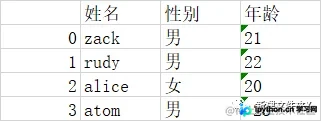
完成状态确认与常见问题排查
代码运行完毕后可直接打开output.xlsx,核对以下指标即可判定转换达标:
- 行列严格对应:表头行数与数据区域列数完全匹配,无跨列溢出或缺失现象。
- 标点彻底清洗:单元格内不存在未替换的中英文逗号或残留空格,数值与文本可被Excel公式(如SUM、VLOOKUP)直接计算。
- 文件零报错:双击无格式损坏警告,内存占用处于正常范围。
若转换后仍出现大量空白行,通常是因为源文本文件末尾保留了换行符。可在enumerate循环内追加if not line.strip(): continue进行硬性过滤。若未来需处理其他定界符(如分号、竖线),仅需修改.replace()的映射字符与.split()的参数即可平滑扩展。
简要总结
依托openpyxl的基础API配合轻量级字符串操作,能够稳定解决常规分隔文本向Excel工作表的格式迁移需求。掌握统一字符替换策略与行列容量对齐原则,即可快速适配各类规则明确的原始数据,彻底告别低效的人工排版。
以上就是利用Python将文本文件转换为Excel工作表的详细内容,更多关于Python数据处理与openpyxl模块应用资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









