

MySQL 回表、覆盖索引与索引下推原理及实践

深入理解 MySQL 二级索引查询中的回表现象与覆盖索引优化。文章重点解析 MySQL 5.6 引入的索引下推(ICP)机制,通过关闭/开启优化器开关的实验,直观展示其如何减少不必要的回表操作,从而提升数据检索性能。
回表与覆盖索引
在使用 MySQL(InnoDB 引擎)进行查询时,如果使用的不是主键索引(即聚簇索引),而是普通索引或联合索引(二级索引),往往会出现“回表”现象。
什么是回表?
在二级索引树中,通常只保存了索引字段的值以及对应的主键 ID。当查询条件能匹配到二级索引,但 SELECT 列表中包含非索引字段时,数据库无法直接从二级索引中获取全部所需数据,必须拿着这些主键 ID 回到主键索引树(聚簇索引)中去查找完整的行记录。这一过程就是回表。
SELECT * FROM INNODB_USER WHERE AGE = 18 AND USER_NAME LIKE '模糊查%';
在上述示例中,假如 age 和 user_name 建立了联合索引。由于 LIKE '%...' 可能导致索引失效或部分失效,优化器可能先通过 age=18 找到二级索引中的一页数据。此时,因为还需要获取其他列的数据,数据库需要通过页内的主键 ID 逐一回到主键索引树查询,产生多次回表操作。
覆盖索引(Covering Index):
如果查询的所有字段都已经包含在某个二级索引中,则可以直接从该二级索引中提取数据并返回,无需访问主键索引。这种完全依靠索引完成查询而无需回表的技术称为覆盖索引。
索引下推 (ICP) 简介
索引下推(Index Condition Pushdown,简称 ICP)是 MySQL 5.6 版本引入的一项重要优化技术,旨在优化使用非主键索引(二级索引)时的查询效率。
- 传统方式(无 ICP): 存储引擎根据索引找到满足条件的记录后,将整条记录(包括主键和其他字段)传递给服务器层。服务器层再进行过滤判断,符合 WHERE 条件的才会被返回。
- ICP 优化: 存储引擎在拿到索引对应的记录后,先在存储引擎层内判断是否满足部分 WHERE 条件。只有当索引本身支持该条件的过滤时,才将记录提取出来;否则直接丢弃。这减少了回表的次数,也减少了存储引擎向服务器层传递数据的开销。
实验验证
第1步:准备测试数据
创建一个测试表,包含复合索引以演示差异:
DROP TABLE IF EXISTS `t_user`;
CREATE TABLE `t_user` (
  id bigint NOT NULL AUTO_INCREMENT COMMENT '主键',
  name varchar(64) NOT NULL COMMENT '用户名 ',
  age int(8) NOT NULL COMMENT '年纪',
  address varchar(255) DEFAULT NULL COMMENT '地址',
  is_delete tinyint NOT NULL DEFAULT '0' COMMENT '是否删除 默认否',
  create_time datetime DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
  PRIMARY KEY (id),
  KEY idx_name_age (name,age)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci COMMENT='用户信息表';
-- 初始化测试数据
INSERT INTO t_user(name, age, address) VALUES ('李四', 22, '中国');
INSERT INTO t_user(name, age, address) VALUES ('李五', 22, '中国');
INSERT INTO t_user(name, age, address) VALUES ('李六', 23, '中国');
INSERT INTO t_user(name, age, address) VALUES ('张三', 24, '中国');
INSERT INTO t_user(name, age, address) VALUES ('李期', 24, '中国');
第2步:查看当前优化器状态
检查是否开启了索引下推功能:
show VARIABLES like '%optimizer_switch%';
-------------------------------------------------------
optimizer_switch index_merge=on,index_merge_union=on,...,index_condition_pushdown=on,...
第3步:关闭索引下推进行测试
手动关闭 ICP 模拟旧版行为:
set optimizer_switch='index_condition_pushdown=off';
执行 SQL 并通过 EXPLAIN 分析:
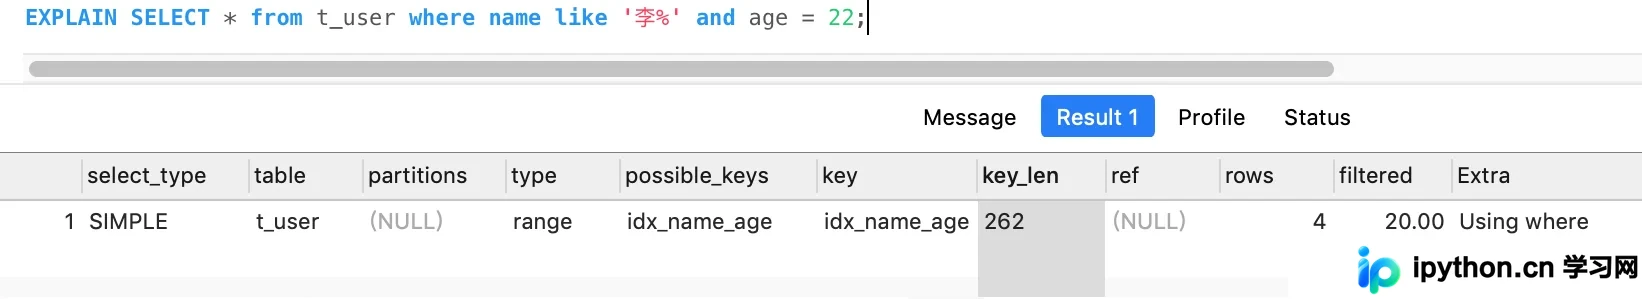
EXPLAIN SELECT * from t_user where name like '李%' and age = 22;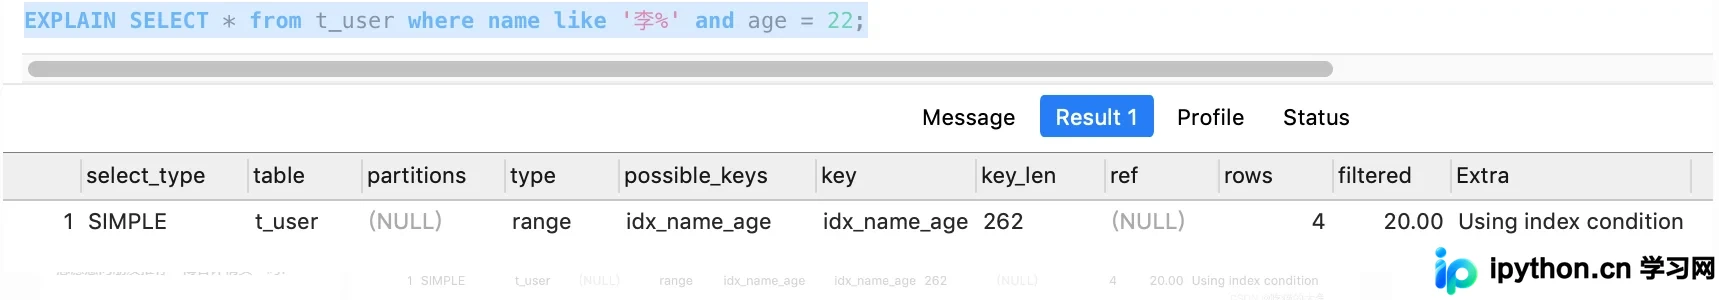
过程分析:
name使用范围查询(LIKE '李%'),导致复合索引idx_name_age在age字段上停止匹配,只能用到name索引。- 首先在
name索引中找到所有符合条件的记录及其主键 ID。 - 回表:** 通过主键 ID 去聚簇索引中读取完整数据(此时还未进行
age的判断,因为没开 ICP)。 - 服务器过滤:** MySQL 服务器层对取回来的数据进行
age = 22的筛选。
结果:Extra 显示 Using where。扫描并回表的行数较多。
第4步:开启索引下推进行对比
set optimizer_switch='index_condition_pushdown=on';
再次执行相同的查询:
EXPLAIN SELECT * from t_user where name like '李%' and age = 22;过程分析:
- 存储引擎在遍历
name索引的过程中,发现索引本身就包含了age字段。 - 索引下推:** 直接在存储引擎层利用索引中的
age进行过滤(age = 22)。只有age符合条件的记录,才会触发一次回表操作。
结果:Extra 显示 Using index condition。显著降低了无效的回表次数和磁盘 IO 负载。
总结
1. **索引下推仅降低回表频率**:它通过提前过滤减少查询次数,但并不改变底层需要扫描的基础行数。
2. **版本要求**:ICP 为 MySQL 5.6+ 特性,低版本不可用。
3. **适用场景**:当查询条件涉及二级索引后面的字段时(如复合索引中前面的字段用于定位,后面的字段用于过滤),ICP 效果最明显。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









