

C语言数据类型与内存存储机制详解:大小端、补码与浮点数

C语言中,所有数据在内存中均以二进制形式存储,不同类型的存放方式决定了程序的运行逻辑与结果。本文详细解析C语言的五大基本数据类型,重点剖析整形的补码存储、大小端模式检测方法,以及浮点数遵循IEEE754标准的编码规则,揭示同一段代码在不同编译版本下行为差异的根本原因。
数据的类型与分类
类型的基本归类
理解数据在内存中的存储,首先需要明确C语言中的数据类型划分。以下代码展示了整形数组越界访问时的现象,这直接关联到Debug与Release版本下的内存分配策略:
int i = 0;
int arr[] = { 1,2,3,4,5,6,7,8,9,10 };
for (i = 0; i <= 12; i++)
{
    arr[i] = 0;
    printf("hehe\n");
}
在VS环境中编译运行这段代码,Debug版本与Release版本的结果截然不同:
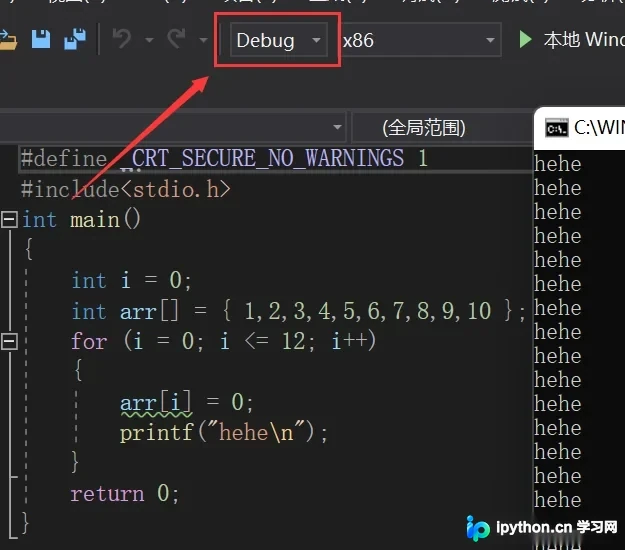
Debug版本结果:程序陷入死循环,不断输出 "hehe"。这是因为Debug模式下,编译器会在数组周围填充特殊字节以辅助调试,导致越界写入时意外修改了循环变量 i 的值。
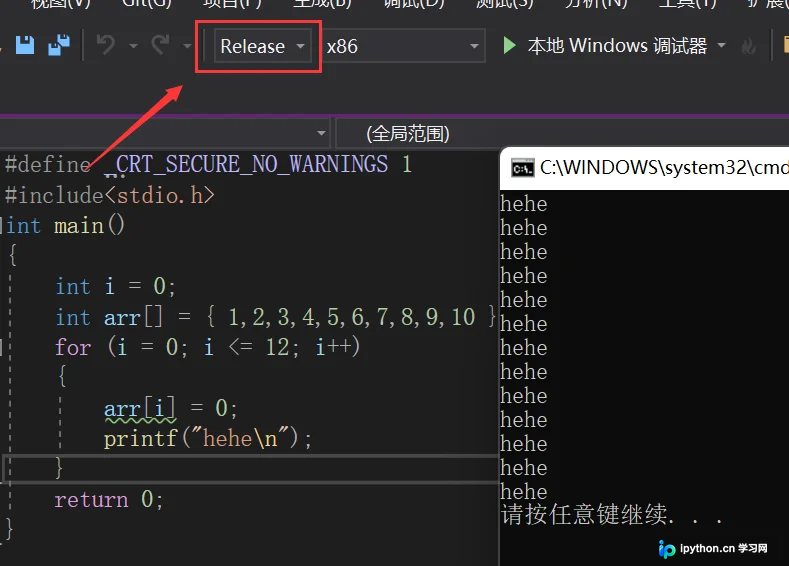
Release版本结果:程序正常执行13次后退出。Release模式去除了调试辅助信息,数组尾部不会覆盖 i 的值,因此循环条件 i <= 12 最终会变为假。
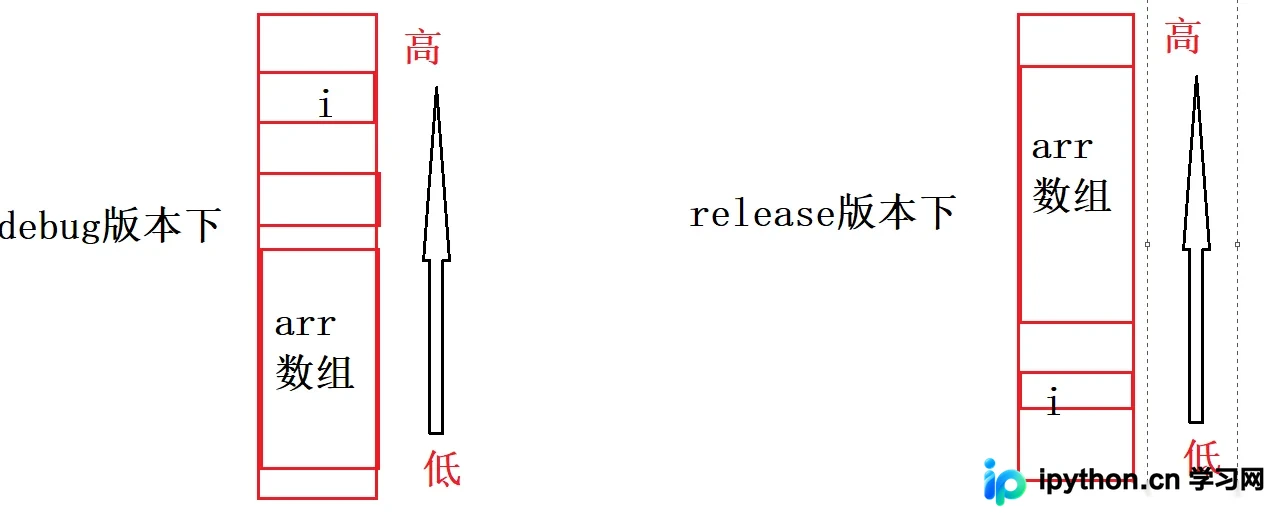
这张对比图揭示了不同优化级别下局部变量在栈上的布局差异。当编译器从高地址向低地址分配栈空间时,Debug环境下数组 arr 与变量 i 之间的填充区域使得越界写操作能够触及 i,将其重置为0或特定调试值;而Release环境下两者间隔较远或顺序不同,越界写入的是无效内存而非 i。
C语言的数据家族
C语言的数据类型主要分为以下五大家族:
- 整形家族:
char:本质是整数(ASCII码),分为有符号signed char和无符号unsigned char。short:分为signed short和unsigned short。int:分为signed int和unsigned int。long:分为signed long和unsigned long。
注意:除
char外,其他类型默认均为有符号。char的符号性取决于具体编译器的实现。 - 浮点数家族:
float:单精度,占用4字节,精度较低。double:双精度,占用8字节,精度更高,范围更大。
- 构造类型(自定义类型):
- 数组类型
[] - 结构体类型
struct - 枚举类型
enum - 联合类型
union
- 数组类型
- 指针类型:
如int *pi,char *pc,float* pf,void* pv等。 - 空类型:
通常指void,应用于函数返回值为空、参数无限制或作为通用指针类型。
整形在内存中的存储
源码、反码与补码
C语言中的整数在内存中统一以补码(Two's Complement)形式存储。这种设计解决了负数参与运算的问题,同时消除了+0和-0的二进制表示冲突。
- 原码:直接将数值转换为带符号的二进制。最高位为符号位(0为正,1为负)。
- 反码:正数的反码同原码;负数的反码是将原码的符号位不变,其余位按位取反。
- 补码:正数的补码同原码;负数的补码是其反码加1。
计算机进行算术运算时直接使用补码,例如减法被转换为加法运算,从而简化了CPU硬件设计。
大端与小端存储模式
多字节数据(如 int, float, double)在内存中存放时,存在两种顺序:
- 大端模式(Big-endian):数据的低位字节存放在高地址,高位字节存放在低地址。
- 小端模式(Little-endian):数据的低位字节存放在低地址,高位字节存放在高地址。
判断当前系统是大端还是小端,可以利用联合体(Union)或指针强制转换的特性。由于联合体成员共享内存空间,且低地址存放的是第一个成员的低位字节,代码如下:
#include <stdio.h>

int check_sys()
{
    int i = 1;
    // 将int指针强制转换为char指针,只读取最低地址的一个字节
    // 如果系统是Little-Endian,最低地址存的是1,返回1
    return (*(char*)&i);
}

int main()
{
    int ret = check_sys();
    if (ret == 1)
    {
        printf("小端\n");
    }
    else
    {
        printf("大端\n");
    }
    return 0;
}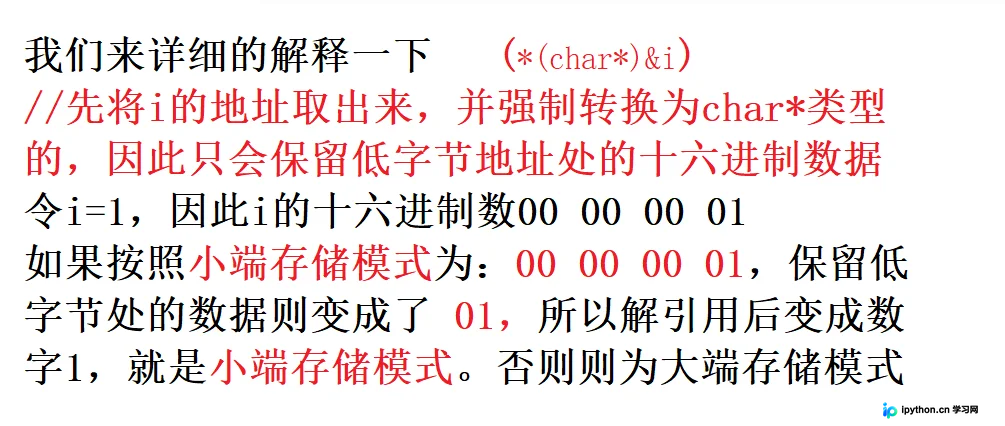
图示解释:在Little-Endian模式下,int i = 1 的十六进制表示为 0x00000001。低地址存放 01,高地址存放 00。通过 *(char*)&i 读取低地址字节,结果为1,从而确认为小端模式。目前绝大多数PC机(x86/x64架构)均采用小端模式。
浮点型在内存中的存储
浮点数在内存中的存储远比整数复杂,它严格遵循国际标准 IEEE 754。任意一个二进制浮点数可以表示为公式:
V = (-1)^S × M × 2^E- S(Sign):符号位。
S=0表示正数,S=1表示负数。 - M(Mantissa):有效数字(尾数)。取值范围为
[1, 2)或[0, 1),实际存储时通常归一化处理。 - E(Exponent):指数位。用于决定小数点的移动位置。
存储规则详解
1. 有效数字 M 的存储
在二进制科学计数法中,例如 101.0 (十进制5),可以写成 1.01 × 2^2 。无论数值多大,其规格化后的有效数字第一位总是1。因此,为了节省一位存储空间,IEEE 754规定在内存中隐藏这一位1,只存储小数点后的部分。读取时再恢复。
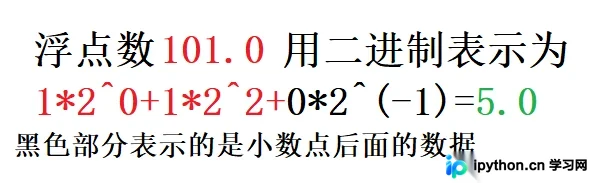
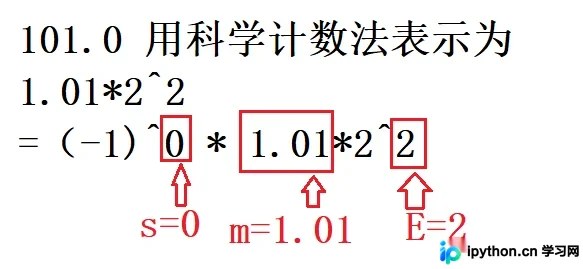
例如,对于 9.6,其二进制无法精确有限表示,会导致舍入误差,这也解释了为什么直接使用 == 比较两个浮点数往往会得到 false。
2. S、M、E 的空间分配
根据IEEE 754标准,不同精度的浮点数在内存中占用的位数不同:
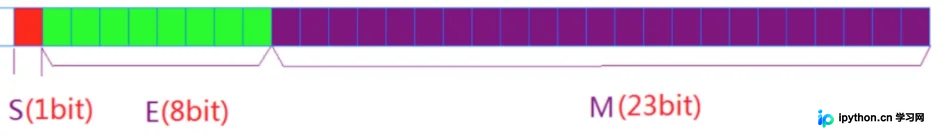
- Float(32位):
- 第1位:符号位 S
- 第2-9位(共8位):指数 E
- 第10-32位(共23位):有效数字 M(存储小数部分)
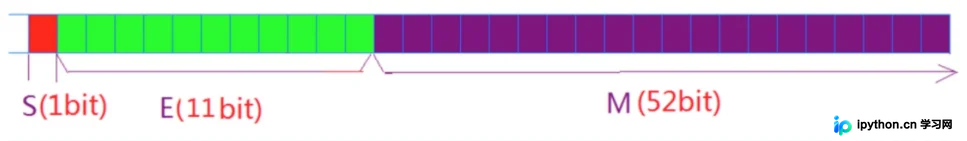
- Double(64位):
- 第1位:符号位 S
- 第2-12位(共11位):指数 E
- 第13-64位(共52位):有效数字 M
3. 指数 E 的特殊处理
指数 E 在进行科学计数法换算时可能是负数,但内存中存储必须是无符号整数。因此引入了偏移量(Bias)概念:
- 对于
float(8位E),真实值需加上中间数 127。 - 对于
double(11位E),真实值需加上中间数 1023。
例如,若要存储 2^10,真实指数为10。存储在 float 中则为 10 + 127 = 137(二进制 10001001)。
此外,IEEE 754还定义了 E=0 和 E=全1 的特殊情况,分别用于表示非规约浮点数(Denormalized Numbers)、零、无穷大(Infinity)和非数(NaN)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









