

C# Linq去重Distinct详解:原理与自定义比较器实现

在C#数据处理的批量导入等场景中,去除重复数据是常见需求。本文将深入解析Linq的Distinct方法,揭示其底层基于引用和哈希值的比较逻辑,并通过实现IEqualityComparer接口自定义去重规则,确保不同对象实例但属性相同的数据能被正确合并。
结果或目标
在使用List<T>进行数据清洗时,简单的.Distinct()往往无法按照业务字段(如姓名、年龄)去重,而是依赖于对象的内存地址。我们需要一种机制,让Distinct能够识别属性相同的不同对象实例,并正确过滤掉它们。
准备条件
1. C# Console Application项目环境。
2. 定义一个包含名称和年龄属性的Person类,用于测试数据。
using System;
using System.Collections.Generic;
using System.Linq;

namespace Compare
{
    public class Person
    {
        public string Name { get; set; }
        public int Age { get; set; }

        public Person(string name, int age)
        {
            this.Name = name;
            this.Age = age;
        }
    }
}
3. 构造包含重复数据的列表:
Person person = new Person("ZhangSan", 26);
List<Person> personList = new List<Person>() {
    person,
    new Person("XiaoMing", 25),
    new Person("CuiYanWei", 25),
    new Person("XiaoMing", 26),
    new Person("XiaoMing", 25), // 重复项1
    new Person("LaoWang", 26),
    new Person("XiaoMing", 26), // 重复项2
    person // 引用完全相同的项
};
真实操作顺序
第1步:使用默认Distinct进行尝试
目的:观察Distinct在未指定比较器时的默认行为,即基于对象引用进行比较。
入口:调用.Distinct().ToList<Person>()。
List<Person> defaultDistinctPersons = personList.Distinct().ToList<Person>();
foreach (Person p in defaultDistinctPersons)
{
    Console.WriteLine($"Name:{p.Name}    Age:{p.Age}");
}
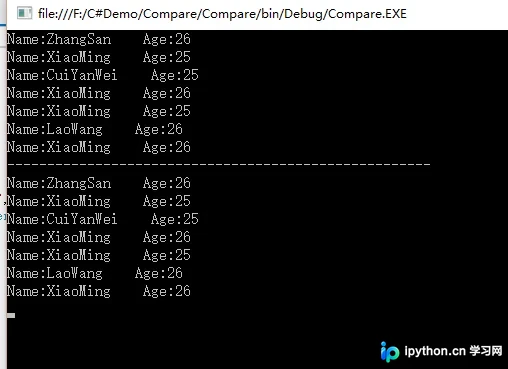
结果分析:执行结果会保留两个“XiaoMing, 26”和一个“XiaoMing, 25”。这是因为虽然它们的Name和Age属性相同,但在内存中是不同的对象实例(除非是引用的同一个ZhangSan变量)。这解释了为什么简单的Distinct无法满足按内容去重的需求。
第2步:创建自定义比较器
目的:告诉Distinct如何通过属性(Name和Age)来判定两个对象是否相等。
动作:实现IEqualityComparer<Person>接口,重写Equals和GetHashCode方法。
public class PersonCompare : IEqualityComparer<Person>
{
    public bool Equals(Person x, Person y)
    {
        if (x == null || y == null) return false;
        // 核心业务逻辑:只要姓名和年龄相同,即视为相同对象
        return x.Name.Equals(y.Name) && x.Age == y.Age;
    }

    public int GetHashCode(Person obj)
    {
        // 初始实现:直接返回对象默认哈希码(效果不佳)
        return obj.GetHashCode();
    }
}
调用方式:
List<Person> comparePersons = personList.Distinct(new PersonCompare()).ToList<Person>();第3步:诊断比较器的执行流程
目的:通过打印调试信息,理解GetHashCode与Equals的协作机制。
动作:在比较器中加入日志输出,观察触发次数。
public class PersonCompare : IEqualityComparer<Person>
{
    public bool Equals(Person x, Person y)
    {
        if (x == null || y == null) return false;
        Console.WriteLine($"Called Equals: X[{x.Name},{x.Age}] vs Y[{y.Name},{y.Age}]");
        return x.Name.Equals(y.Name) && x.Age == y.Age;
    }

    public int GetHashCode(Person obj)
    {
        Console.WriteLine($"Called GetHashCode: [{obj.Name},{obj.Age}] -> {obj.GetHashCode()}" );
        return obj.GetHashCode();
    }
}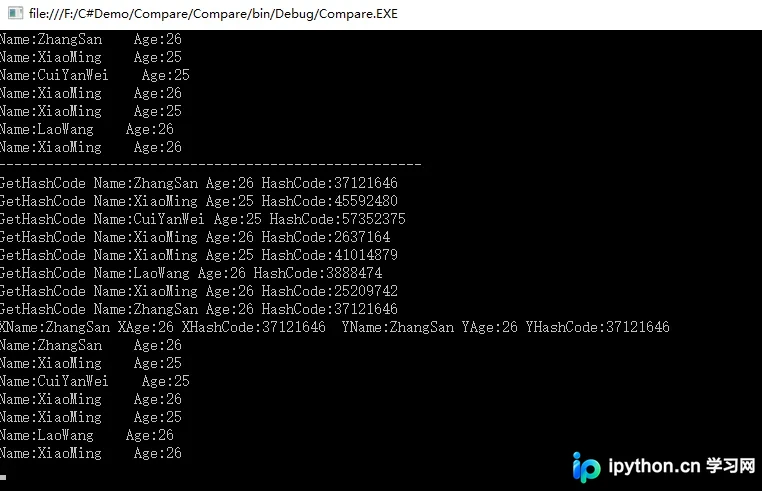
观察结论:
- GetHashCode优先级更高:
Distinct首先调用GetHashCode筛选潜在相等的项。如果哈希值不同,则直接判定为不相等,不再调用Equals。 - Equals兜底:仅当哈希值相同时,才会调用
Equals确认两者是否真的相同。 - 问题所在:由于示例代码中每个不同的
Person实例默认GetHashCode都不同(基于地址),导致所有的比较都落在了Equals上或者哈希冲突极多,性能低下且逻辑未达预期。
第4步:优化哈希码生成(关键修正)
目的:为了让“XiaoMing, 25”这样的不同实例被迅速识别为同一哈希桶,必须基于业务字段生成哈希码。
动作:修改GetHashCode,将属性组合成字符串计算哈希。
public class PersonCompare : IEqualityComparer<Person>
{
    public bool Equals(Person x, Person y)
    {
        if (x == null || y == null) return false;
        Console.WriteLine($"Comparing: X[{x.Name},{x.Age}] and Y[{y.Name},{y.Age}]" );
        return x.Name.Equals(y.Name) && x.Age == y.Age;
    }

    public int GetHashCode(Person obj)
    {
        // 改进:基于内容生成哈希码
        string s = string.Format("{0}_{1}", obj.Name, obj.Age);
        Console.WriteLine($"Generated Hash for [{obj.Name},{obj.Age}] is {s.GetHashCode()}" );
        return s.GetHashCode();
    }
}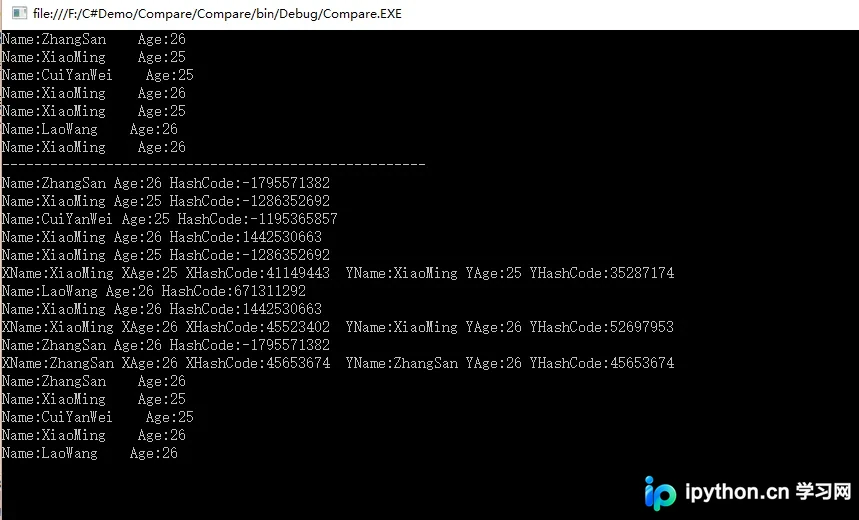
最终验证:
在执行去重时:
- 遇到第一个“XiaoMing, 25”,生成哈希并记录。
- 遇到第二个“XiaoMing, 25”,生成的哈希码与前一个完全一致。
- 触发
Equals方法进行精确比对,结果一致,判定为重复项丢弃。
这种方式显著减少了无效的比较消耗,且成功将所有属性相同的重复对象剔除。
完成判断
当控制台中调用的GetHashCode主要依赖Name和Age组合,且Distinct输出的列表中不再包含同名同龄的不同实例时,自定义去重机制即告成功。相比默认的引用比较,这是符合大多数业务场景的正确解法。
简要总结
以上就是C# Linq去重Distinct详解:原理与自定义比较器实现的详细内容。Linq的Distinct在涉及引用类型时默认只比较地址。若需按内容去重,必须实现IEqualityComparer<T>接口,并重点注意GetHashCode需要基于内容(而非默认Object哈希)生成,以确保Equals能收到正确的候选对进行校验。更多关于C#进阶编程的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









