

为什么不建议使用Java自定义Object作为HashMap的Key

在使用Java自定义对象作为HashMap的Key时,若未正确处理equals()和hashCode()方法,极易引发内存泄漏。本文将深入解析这一常见陷阱的成因,提供安全的代码实现方案,并介绍如何结合LinkedHashMap构建具备数据淘汰机制的稳健缓存系统。
踩坑历程回顾:隐形的内存泄漏
在实际项目排查中,常遇到内存无限制增长甚至OOM的情况。当发现异常堆积在全局HashMap中且作为Key的对象数量远超预期时,首要怀疑点往往是Key类没有正确重写equals()和hashCode()方法。然而,即便IDE自动生成了这两个方法,如果逻辑不严谨,依然可能埋下隐患。
第1步:分析错误案例的代码结构
以一个典型的用户发帖缓存场景为例。我们定义了一个User对象用于存储用户信息,并将其作为Map的Key:
@Data
public class User {
    // 用户名称
    private String userName;
    // 账号ID
    private String accountId;
    // 用户上次登录时间,每次登录的时候会自动更新DB对应时间
    private long lastLoginTime;

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;
        User user = (User) o;
        // 错误点:将易变的lastLoginTime纳入了比较逻辑
        return lastLoginTime == user.lastLoginTime &&
                Objects.equals(userName, user.userName) &&
                Objects.equals(accountId, user.accountId);
    }

    @Override
    public int hashCode() {
        // 错误点:将易变的lastLoginTime纳入了哈希计算
        return Objects.hash(userName, accountId, lastLoginTime);
    }
}
第2步:观察异常行为的触发过程
在业务逻辑中,每次用户发帖都会调用如下方法:
public void addCache(User currentUser, Post postContent) {
    cache.computeIfAbsent(currentUser, k -> new ArrayList<>()).add(postContent);
}看似正常的操作,实际上潜藏危机。当用户重新登录后,lastLoginTime被更新为当前时间戳。由于该字段参与了equals和hashCode的计算:
- 哈希碰撞变化:新的登录时间导致hashCode值改变,HashMap无法在原位置找到该用户,而是将其视为一个全新的Key插入新位置。
- 逻辑断裂:旧时间的用户记录无法再通过新时间的对象访问,形成“僵尸”数据。
- 结果:随着用户反复登录发帖,Map中充斥着同一用户的多个副本,导致内存迅速耗尽。
hashCode覆写的核心讲究
理解HashMap的底层运作机制是避免此类问题的前提。在JDK 1.8+版本中,HashMap采用数组加链表(或红黑树)的结构:
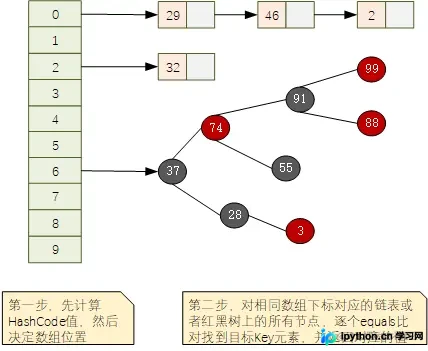
查找逻辑分解
- 定位片区(hashCode):调用key对象的hashCode()获取散列码,映射到数组索引。这决定了元素的大致存储区域。
- 精确定位(equals):若索引处存在多个元素(Hash碰撞),则通过equals()逐个比对,直到找到目标对象。
字段选择的平衡艺术
在重写hashCode时,需在选择参与计算的字段数量上取得平衡:
- 过多字段:增加计算开销,影响频繁的哈希查询性能。
- 过少字段:导致哈希冲突激增,退化为链表遍历,降低效率。
- 关键原则:必须选择不可变(Immutable)或极少变更的业务主键字段,严禁包含如时间戳、自增ID等随生命周期变化的状态字段。
数据退出机制的兜底方案
除了修正equals/hashCode逻辑,全局缓存容器自身也需具备防御性设计。与Redis等中间件类似,单机内存缓存必须设定容量上限及淘汰策略,防止单个业务逻辑失控拖垮整个进程。
第3步:实现基于LRU的受限Map
通过继承LinkedHashMap并重写removeEldestEntry方法,可以优雅地实现固定大小缓存:
public class FixedLengthLinkedHashMap<K, V> extends LinkedHashMap<K, V> {
    private static final long serialVersionUID = 1287190405215174569L;
    private int maxEntries;

    public FixedLengthLinkedHashMap(int maxEntries, boolean accessOrder) {
        super(16, 0.75f, accessOrder);
        this.maxEntries = maxEntries;
    }

    /**
     * 自定义数据淘汰触发条件,在每次put操作时会调用此方法来判断
     */
    protected boolean removeEldestEntry(Map.Entry<K, V> eldest) {
        return size() > maxEntries;
    }
}构造器中的accessOrder=true参数开启了按访问顺序排序的功能,配合上述重写方法,即可实现标准的LRU(最近最少使用)淘汰算法。这样即使业务代码中出现异常堆积,也能保证内存占用不超过预设阈值。
总结
在Java开发中规避HashMap Key相关的风险,需遵循以下规范:
- 首选String或基本类型:尽量避免使用复杂的自定义对象作为Key。
- 严格重写equals/hashCode:若必须使用自定义对象,请确保仅依赖不可变的业务标识字段(如账号ID、UUID),剔除所有易变状态字段。
- 引入淘汰机制:对于全局缓存场景,优先选用带有容量限制的容器(如FixedLengthLinkedHashMap),确保系统的鲁棒性。
以上就是为什么不建议使用Java自定义Object作为HashMap的key的详细内容,更多关于Java HashMap的key内容的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









