

Java实现宽度优先爬虫:从基础抓取到BFS算法实战

本文详解如何使用Java语言开发宽度优先(BFS)网络爬虫。通过整合Apache HttpClient进行页面请求与保存,结合HtmlParser解析HTML链接,并设计SpiderQueue管理待抓取和已访问URL队列。文章提供完整代码结构,涵盖种子节点初始化、URL去重、深度控制及反爬基础处理,帮助开发者快速掌握网络数据抓取的核心逻辑。
BFS爬虫核心原理与架构
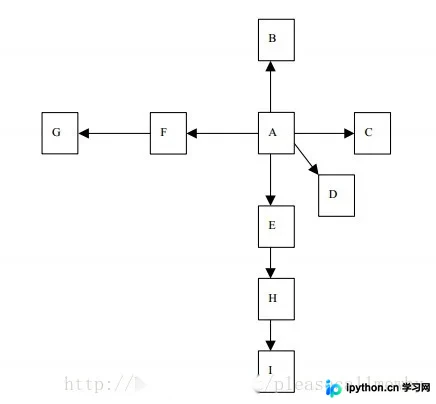
将互联网视为一张巨大的有向图,网页是节点,超链接是有向边。宽度优先搜索(Breadth-First Search, BFS)是爬虫最常用的策略之一。它从一组种子URL开始,逐层向外扩展:
- 顶点入队:将种子URL加入待处理队列。
- 循环处理:只要队列非空,取出队头URL进行处理。
- 访问与标记:下载该页面,提取新链接,并将当前URL标记为已访问。
- 邻接点入队:将发现的新链接(若未访问且符合规则)加入队列尾部。
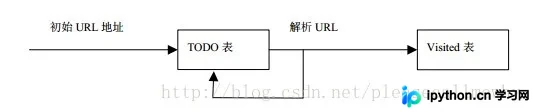
这种“一层一层”的遍历方式能保证在短时间内获取最接近种子页面的丰富内容。其数据结构核心在于两个表:Visited Table(记录已抓取的URL)和 TODO Table(待抓取的URL队列)。
环境依赖与工具类封装
Java原生URLConnection功能有限,建议引入第三方库增强稳定性。本方案主要依赖:
org.apache.commons.httpclient:处理HTTP连接、超时设置、重试机制及流读取。org.htmlparser:专门用于解析HTML DOM树,提取<a>和<frame>标签中的链接。
第一步:构建自定义队列(TODO表)
为了实现BFS的先进先出(FIFO)特性,使用LinkedList封装一个简单的Queue类。虽然Java标准库提供了Queue接口,但为了演示清晰,这里提供基础实现供参考:
import java.util.LinkedList;

public class Queue {
    private LinkedList<Object> queue = new LinkedList<>();

    public void enQueue(Object t) {
        queue.addLast(t);
    }

    public Object deQueue() {
        return queue.removeFirst();
    }

    public boolean isQueueEmpty() {
        return queue.isEmpty();
    }

    public boolean contains(Object t) {
        return queue.contains(t);
    }
}
第二步:管理URL状态(Visited表与SpiderQueue)
为了防止死循环和重复抓取,需要高效地判断URL是否已存在。HashSet提供了O(1)时间的查找性能,适合存储已访问的URL集合。SpiderQueue类统一管理这两个状态:
import java.util.HashSet;
import java.util.Set;

public class SpiderQueue {
    // 已访问的URL集合
    private static Set<String> visitedUrl = new HashSet<>;
    // 待抓取的URL队列
    private static Queue unVisitedUrl = new Queue();

    public static void addVisitedUrl(String url) {
        visitedUrl.add(url);
    }

    public static int getVisitedUrlNum() {
        return visitedUrl.size();
    }

    public static Queue getUnVisitedUrl() {
        return unVisitedUrl;
    }

    public static Object unVisitedUrlDeQueue() {
        return unVisitedUrl.deQueue();
    }

    /**
     * 添加未访问URL,确保不重复且不包含空值
     */
    public static void addUnvisitedUrl(String url) {
        if (url != null && !url.trim().equals("")
            && !visitedUrl.contains(url)
            && !unVisitedUrl.contains(url)) {
            unVisitedUrl.enQueue(url);
        }
    }

    public static boolean unVisitedUrlsEmpty() {
        return unVisitedUrl.isQueueEmpty();
    }
}
第三步:网页下载器(DownTool)
此工具负责执行HTTP GET请求,配置超时时间以防阻塞,并将响应体保存为本地文件。文件名通过URL生成,需替换非法字符。
import org.apache.commons.httpclient.*;
import org.apache.commons.httpclient.methods.*;
import org.apache.commons.httpclient.params.*;
import java.io.*;

public class DownTool {
    /**
     * 根据URL生成安全的文件名
     */
    private String getFileNameByUrl(String url, String contentType) {
        // 移除协议头
        if (url.startsWith("http://")) {
            url = url.substring(7);
        } else if (url.startsWith("https://")) {
            url = url.substring(8);
        }

        String extension = "html";
        if (contentType != null && contentType.contains("html")) {
            extension = "html";
        } else {
             // 尝试从Content-Type提取后缀,如 image/jpeg -> jpg
             int idx = contentType.lastIndexOf("/");
             if (idx != -1) extension = contentType.substring(idx + 1);
        }

        // 替换路径中的非法文件名字符
        String safeUrl = url.replaceAll("[\\?/:*|<>\"]", "_");
        return safeUrl + "." + extension;
    }

    private void saveToLocal(byte[] data, String filePath) throws IOException {
        File dir = new File(filePath.substring(0, filePath.lastIndexOf('/')));
        if (!dir.exists()) dir.mkdirs();

        try (DataOutputStream out = new DataOutputStream(new FileOutputStream(filePath))) {
            out.write(data);
            out.flush();
        }
    }

    public String downloadFile(String url) throws Exception {
        HttpClient httpClient = new HttpClient();
        httpClient.getHttpConnectionManager().getParams()
                .setConnectionTimeout(5000);

        GetMethod getMethod = new GetMethod(url);
        getMethod.getParams().setParameter(HttpMethodParams.SO_TIMEOUT, 5000);
        getMethod.getParams().setParameter(HttpMethodParams.RETRY_HANDLER,
                new DefaultHttpMethodRetryHandler());

        try {
            int statusCode = httpClient.executeMethod(getMethod);
            if (statusCode != HttpStatus.SC_OK) {
                System.err.println("Failed: " + getMethod.getStatusLine());
                return null;
            }

            byte[] responseBody = getMethod.getResponseBody();
            String fileName = getFileNameByUrl(url,
                    getMethod.getResponseHeader("Content-Type").getValue());
            String filePath = "temp/" + fileName;

            saveToLocal(responseBody, filePath);
            return filePath;
        } finally {
            getMethod.releaseConnection();
        }
    }
}
第四步:HTML解析器(HtmlParserTool)
使用HtmlParser库解析页面DOM。我们需要提取两种链接:<a>标签的href属性和<frame>标签的src属性。同时应用一个过滤器(LinkFilter)来排除不符合域名规则的链接,防止爬虫跳出目标站点。
import org.htmlparser.*;
import org.htmlparser.filters.*;
import org.htmlparser.tags.LinkTag;
import org.htmlparser.util.NodeList;
import model.LinkFilter; // 假定的接口,定义accept方法
import java.util.HashSet;
import java.util.Set;

public class HtmlParserTool {

    public static Set<String> extracLinks(String url, LinkFilter filter) {
        Set<String> links = new HashSet<>;
        try {
            Parser parser = new Parser(url);
            parser.setEncoding("UTF-8"); // 建议动态检测编码

            // 过滤 <a> 标签
            NodeFilter aFilter = new NodeClassFilter(LinkTag.class);
            // 过滤 <frame> 标签及其相关文本
            NodeFilter frameFilter = new NodeFilter() {
                @Override
                public boolean accept(Node node) {
                    return node.toPlainTextString().startsWith("frame src=");
                }
            };

            // 组合过滤器:取A标签或Frame标签
            OrFilter linkFilter = new OrFilter(aFilter, frameFilter);
            NodeList list = parser.extractAllNodesThatMatch(linkFilter);

            for (int i = 0; i < list.size(); i++) {
                Node tag = list.elementAt(i);
                if (tag instanceof LinkTag) {
                    LinkTag link = (LinkTag) tag;
                    String linkUrl = link.getLink();
                    if (filter != null && filter.accept(linkUrl)) {
                        links.add(linkUrl);
                    }
                } else {
                    // 处理Frame标签,手动解析src属性
                    String text = tag.toPlainTextString();
                    int start = text.indexOf("src=");
                    if (start != -1) {
                        String framePart = text.substring(start + 4);
                        int end = framePart.indexOf(""); // 假设结束符
                        if (end == -1) end = framePart.indexOf("> ");
                        if (end > 4) {
                            String frameUrl = framePart.substring(0, end - 1);
                            if (filter != null && filter.accept(frameUrl)) {
                                links.add(frameUrl);
                            }
                        }
                    }
                }
            }
        } catch (ParserException e) {
            e.printStackTrace();
        }
        return links;
    }
}
BFS爬虫主逻辑实现
最后,将所有组件串联起来。BfsSpider类负责调度:初始化种子、循环抓取、解析新链接并加入队列。为了控制资源占用,设置最大抓取数量限制(例如1000页)。
import controller.DownTool;
import controller.HtmlParserTool;
import model.LinkFilter;
import model.SpiderQueue;
import java.util.Set;

public class BfsSpider {

    private void initCrawlerWithSeeds(String[] seeds) {
        for (String seed : seeds) {
            SpiderQueue.addUnvisitedUrl(seed);
        }
    }

    public void crawling(String[] seeds) {
        // 定义域名过滤器,仅抓取百度域名的链接
        LinkFilter filter = new LinkFilter() {
            @Override
            public boolean accept(String url) {
                return url.startsWith("http://www.baidu.com");
            }
        };

        initCrawlerWithSeeds(seeds);

        // BFS主循环
        while (!SpiderQueue.unVisitedUrlsEmpty()
               && SpiderQueue.getVisitedUrlNum() <= 1000) {

            String visitUrl = (String) SpiderQueue.unVisitedUrlDeQueue();
            if (visitUrl == null) continue;

            // 1. 下载页面
            DownTool downLoader = new DownTool();
            try {
                downLoader.downloadFile(visitUrl);
            } catch (Exception e) {
                System.out.println("Download failed for: " + visitUrl);
                continue;
            }

            // 2. 标记已访问
            SpiderQueue.addVisitedUrl(visitUrl);

            // 3. 提取链接
            Set<String> links = HtmlParserTool.extracLinks(visitUrl, filter);

            // 4. 新链接入队
            for (String link : links) {
                SpiderQueue.addUnvisitedUrl(link);
            }

            // 可选:打印进度
            System.out.println("Processed: " + SpiderQueue.getVisitedUrlNum());
        }
    }

    public static void main(String[] args) {
        BfsSpider crawler = new BfsSpider();
        crawler.crawling(new String[]{"http://www.baidu.com"});
    }
}
运行结果与注意事项
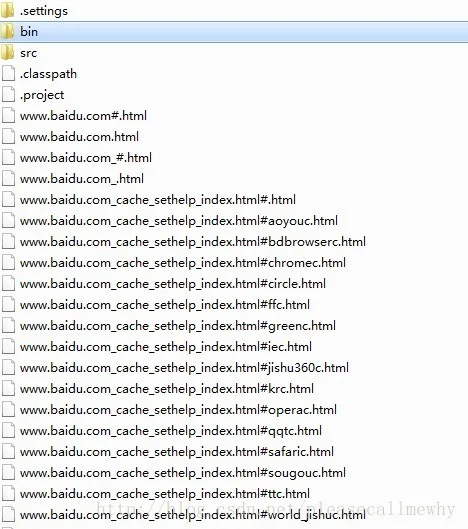
成功运行后,程序会在当前目录的temp文件夹下生成对应的HTML文件或图片文件。随着程序运行,控制台会输出已处理的页面计数,直到达到设定的上限或队列为空。
进阶优化建议:
- 并发控制:单线程效率较低,实际项目中建议使用线程池并发抓取,并配合
ConcurrentHashMap保证URL去重的线程安全。 - Robots协议:正式爬虫应检查
robots.txt,遵守网站的抓取规范,避免被封禁IP。 - 异常处理:增加对DNS解析失败、连接重置等网络异常的指数退避重试机制。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









