

C语言链表实现通讯录管理系统

通过C语言单链表结构设计通讯录管理系统,实现联系人信息的持久化存储与增删改查操作。文章解析了基于strcmp的模糊查找逻辑、冒泡排序对数据域的独立交换策略以及防重名sign机制,并附带完整源代码与流程图说明。
系统设计概览
本通讯录系统采用单链表作为底层数据结构,旨在平衡插入与删除操作的效率。虽然单链表在随机访问上存在局限,但能高效支持动态内存分配。系统核心围绕主菜单交互展开,包含新建、浏览、修改、查找、添加、保存、读取、排序等功能模块。
数据结构与核心变量
系统定义了包含六个字段的结构体以存储联系人信息:
- name: 姓名(用于精确或模糊查找)
- home: 籍贯
- phone1 / phone2: 两个电话号码槽位
- email: 电子邮箱
- sign: 整数型标记,专门用于区分同名联系人的唯一序号
全局头指针 head 指向链表首节点。由于未引入额外的子结构体包装数据域,在执行排序等操作时,需逐个字段交换内容而非直接移动节点指针,以防next指针断裂。
功能模块实现逻辑
第1步:初始化与文件读取
程序启动时调用 readfile()。尝试以只读模式打开 通讯录 文件。若文件不存在,提示用户执行新建;若存在,则遍历文件内容,利用尾插法重建内存中的链表,确保会话状态不丢失。
第2步:新建联系人批量录入
在 Inputdata() 中,系统采用循环输入模式。用户在“姓名”栏输入关键字 over 即可结束当前批次录入。输入过程中,每个新节点均进行内存分配(malloc),并通过 p2->next=p1 链接至链表尾部。此阶段重点在于处理输入缓冲区残留字符(getchar()),防止后续 scanf 读取异常。
第3步:查找联系人(精确与模糊)
Seek() 模块提供两种查找模式:
- 按姓名精确查找:直接使用
strcmp(name, p->name)比对。 - 按姓氏查找:针对中文姓名的复杂性(单姓或复姓),根据输入字符串长度自动分支。若长度为2(单姓),截取前2个字节比较;若长度为4(复姓如欧阳),截取前4个字节比较。这确保了多字节编码下的模糊搜索可行性。
第4步:添加联系人与防重名处理
在 Insertdata() 中,为避免重复名字导致的冲突,系统遍历现有链表,寻找与待插入者同名的最大 sign 值,并将新节点的 sign 设为该最大值加一。插入位置支持头部、尾部或指定姓名前插入。需注意在链表中间插入时,需正确更新前驱节点的 next 指针及新节点的 next 指针。
第5步:字典序排序
Sort() 函数采用冒泡排序思想。因链表无索引,算法通过双重指针 p1 和 p2 遍历所有节点组合。当发现逆序时,仅交换各数据域(如 strcpy(p1->name, temp_name)),而保持物理节点连接不变。同姓名节点依据 sign 小在前原则排列。
操作流程与注意事项
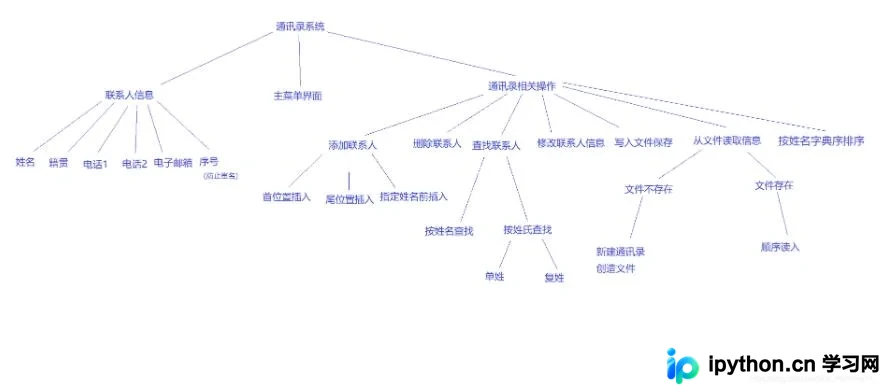
系统在每次关键数据变更后(如增加、修改、删除),均需手动调用“保存”功能将链表数据序列化写入磁盘(fprintf)。这符合课程设计的基础存储模型,但在实际应用中通常会引入自动保存机制或事务回滚。
已知问题与限制
代码中存在一个潜在逻辑缺陷:在只有单个联系人(即链表仅含头节点且后接NULL,或特定条件下判断失效)时,执行“浏览所有联系人”函数可能因指针判空条件 p2!=NULL 结合特定的内部迭代逻辑出现死循环或溢出。在实际编译运行测试中发现该Bug,建议在复杂化数据结构后引入更严格的边界检查。
以上便是C语言链表通讯录系统的设计解析与代码实现。对于需要深入了解指针操作与数据结构应用的读者,建议配合源码在本地环境中逐步调试每一步操作的结果。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









