

JavaScript 尾递归实现原理与蹦床函数优化

JavaScript 递归若缺乏优化极易引发栈溢出,尽管引擎未全面支持尾调用优化,开发者仍可通过将递归转化为尾递归形式并结合蹦床(Trampoline)函数来规避堆栈深度限制。本文将深入解析尾递归的执行逻辑,并提供完整代码示例演示如何在 JavaScript 中安全处理深层递归场景。
传统递归的性能瓶颈
递归是解决分治问题和数学序列计算的常用手段,但在计算量较大时,函数调用会层层压入堆栈。由于每次调用都需要保存当前的执行上下文(变量、指针等),当递归层级过深时,主线程的栈空间会被耗尽,从而触发 Maximum call stack size exceeded 错误。这种非尾递归的方式不仅消耗大量内存,还显著降低程序性能。
以经典的“跳楼梯”问题为例:假设一次只能走 1 步或 2 步,求跳上 n 级台阶的方法总数。最直观的递归解法如下:
// 基础递归实现
function jump(countOfStep) {
    if (countOfStep <= 0) return 0;
    function jumpRecursive(innerCountOfStep) {
        if (innerCountOfStep <= 0) return 0;
        if (innerCountOfStep === 1 || innerCountOfStep === 0) return 1;
        // 此处为非尾递归:需要等待两个子递归的结果相加
        return jumpRecursive(innerCountOfStep - 1) + jumpRecursive(innerCountOfStep - 2);
    }
    return jumpRecursive(countOfStep);
}上述代码逻辑清晰,但存在明显的性能缺陷:jumpRecursive 的返回值依赖于两个子调用的结果之和,这意味着当前帧必须保持活跃直到子调用返回,导致堆栈线性增长。
优化方案对比:记忆化、迭代与尾递归
第一种思路:空间换时间的迭代
为了消除递归带来的栈压力,最直接的方法是将其转换为循环(迭代)。通过维护中间状态变量,可以避免额外的函数调用开销。同时,可以使用数组缓存历史结果(记忆化),进一步减少重复计算:
// 记忆化+迭代实现
function jumpDynamic(countOfStep) {
    if (countOfStep <= 0) return 0;
    const saves = new Array(countOfStep + 1).fill(0);
    saves[0] = 1;
    saves[1] = 1;
    for (let i = 2; i <= countOfStep; i++) {
        saves[i] = saves[i - 1] + saves[i - 2];
    }
    return saves[countOfStep];
}
该方案解决了栈溢出问题,但若仅需 O(1) 空间复杂度,我们甚至不需要整个数组,只需保留前两项即可:
// 纯迭代实现(空间复杂度 O(1))
function jumpIterative(countOfStep) {
    if (countOfStep <= 0) return 0;
    let [prev, curr] = [0, 1];
    for (let i = 1; i <= countOfStep; i++) {
        [prev, curr] = [curr, prev + curr];
    }
    return curr;
}
第二种思路:尾递归(Tail Recursion)
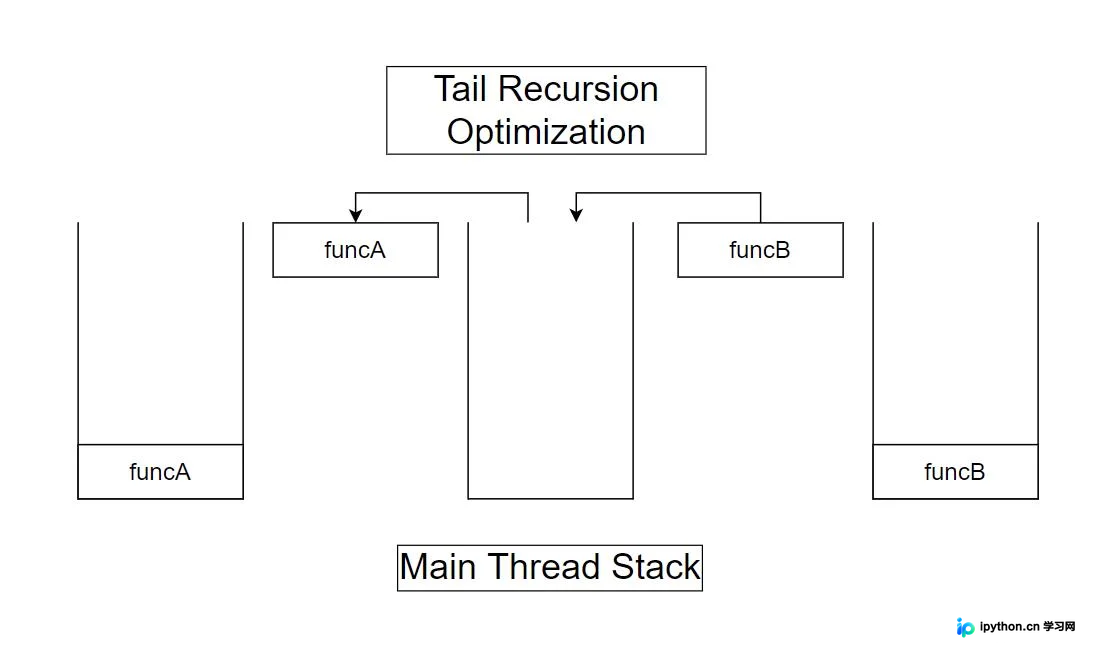
尾递归的核心思想是:函数的最后一个动作直接返回递归调用的结果,不再进行任何操作。这样理论上编译器或引擎可以复用当前栈帧,而非创建新的栈帧。
我们将跳楼梯的逻辑重构为尾递归形式。通过将累计值作为参数传递,消除对上一层栈帧的依赖:
// 尾递归实现
function jumpTailRecursive(count, prev = 0, curr = 1) {
    if (count <= 0) return prev;
    if (count === 1) return curr;
    // 最后一个操作是直接返回递归调用
    return jumpTailRecursive(count - 1, curr, prev + curr);
}
尾递归代码保留了递归的简洁性和可读性,避免了显式的循环结构。其执行过程如下图所示:
JavaScript 中的现实困境:未实现的 TCO
在 ES6 标准中,规范明确定义了尾调用优化(Tail Call Optimization, TCO),要求 JavaScript 引擎在不新增栈帧的情况下执行尾调用。然而,由于历史原因、实现复杂性以及不同厂商间的分歧,主流引擎(如 V8、SpiderMonkey)并未在生产环境中默认开启严格的 TCO 支持。因此,在大多数浏览器中运行深层尾递归依然会导致栈溢出。
要真正在用户层面实现“无栈溢出”的递归体验,我们需要手动模拟这一优化过程,最常用的技术是蹦床函数(Trampoline)。
使用蹦床函数实现真正的尾递归优化
蹦床模式是一种高阶函数技术。它不直接执行递归,而是让递归函数只返回一个描述下一步操作的“ thunk ”(惰性求值的函数),再由蹦床函数负责在一个循环中不断调用这些 thunk,直到得到最终结果。
结合之前的跳楼梯问题,以下是完整的蹦床实现方案:
// 1. 修改递归函数,使其返回一个匿名函数而非直接结果
function jumpTailRecursiveTrampolined(count, prev = 0, curr = 1) {
    if (count <= 0) return prev;
    if (count === 1) return curr;
    // 关键改动:返回一个函数,延迟下一次递归的执行
    return () => jumpTailRecursiveTrampolined(count - 1, curr, prev + curr);
}

// 2. 定义蹦床控制器
function trampoline(fn) {
    return function(...args) {
        let result = fn.apply(null, args);
        // 只要结果是函数,就继续执行(模拟循环)
        while (typeof result === 'function') {
            result = result();
        }
        return result;
    };
}

// 3. 测试用例
const optimizedJump = trampoline(jumpTailRecursiveTrampolined);
console.log(optimizedJump(10)); // 输出 89
console.log(optimizedJump(1000)); // 不会报栈溢出错误
原理解析
- 惰性化递归:内部的
jumpTailRecursiveTrampolined不再直接调用自身,而是返回一个箭头函数。这相当于把下一次递归挂起,而不是压入新栈。 - 循环驱动:
trampoline函数接收外部传入的参数启动流程。它在 `while` 循环中检查返回值是否为函数类型。如果是,则立即执行该函数获取下一个状态;如果不是,说明递归结束,直接返回最终数值。 - 栈深度恒定:整个过程实际上是在单一线程上下文中通过循环完成的,因此无论递归深度多大,堆栈始终只有一层(即
trampoline调用所在的栈帧),彻底消除了栈溢出风险。
以上就是 JavaScript 尾递归编程的实现原理与蹦床函数应用的详细内容,更多关于 JavaScript 递归优化与算法实践的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









