

C语言实现Prim算法构造最小生成树:图解与代码解析

最小生成树是通信网络等场景中的经济最优方案。Prim算法利用贪心策略,从选定节点出发,每次选取连接已选集合与未选集合中权值最小的边进行扩展。本文将通过C语言结构体实现该算法,详细拆解数据定义、核心查找逻辑及执行步骤。
最小生成树基础与Prim思想
设 G=(V,E) 为无向连通带权图,其中 V 为顶点集,E 为边集,每条边 (v,w) 具有权重 c[v][w]。生成树是包含图中所有顶点的极小连通子图。在所有生成树中,总权值最小的那棵即为最小生成树(MST)。
Prem算法的核心在于贪心选择:始终保持两个集合,一个是已纳入树的顶点集合 U,另一个是未纳顶点集合 V-U。算法开始时令 U={u0},随后反复执行以下操作:在连接 U 和 V-U 的所有边中,选出权值最小的一条边 (i,j),将顶点 j 加入 U,将边 (i,j) 加入树的边集。重复此过程直到 U=V。
数据结构设计思路
为了实现这一逻辑,我们需要清晰地区分“点”和“边”的状态。本实现采用结构体数组来模拟图的网络:
- 点结构体 (Node):包含顶点编号
ID和状态标志OnTree。当OnTree=true时,表示该顶点已被收录进最小生成树。 - 边结构体 (LS):包含两个连接端的编号
N1, N2、权重V以及状态标志OnTree。OnTree=true表示该边已被选中加入最小生成树。
初始化时,仅有一个起始点被标记为在树上,所有边均未入选。随着算法推进,通过判断边的端点是否在树上,来锁定下一步扩张的候选边。
实例图解
以下图为例,演示如何构造最小生成树。
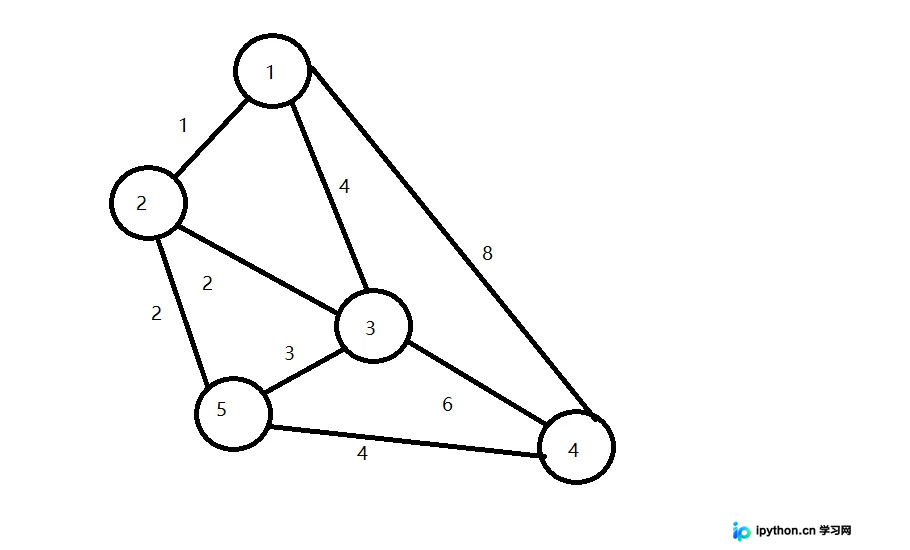
图示展示了初始的无向连通带权图,包含5个顶点和8条加权边。我们的目标是通过迭代选择,最终得到总权值最小的连通子图。
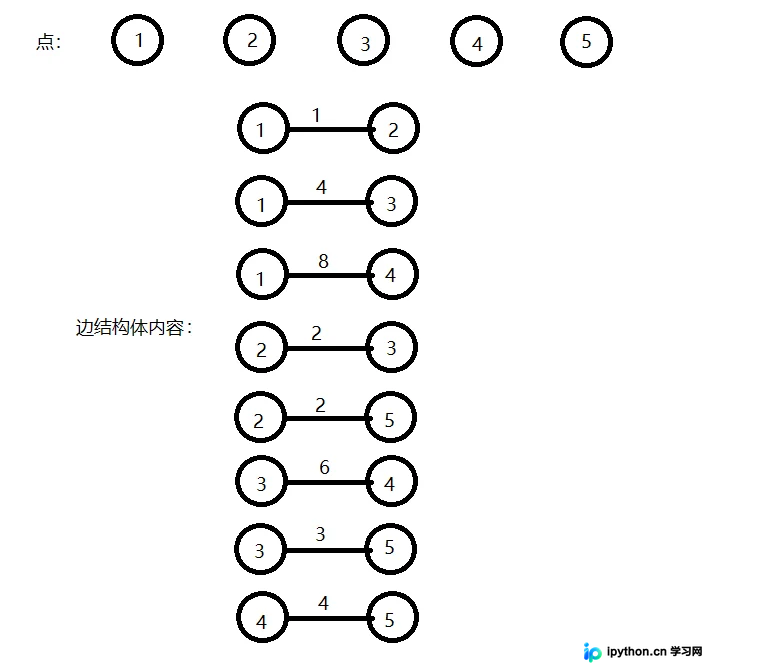
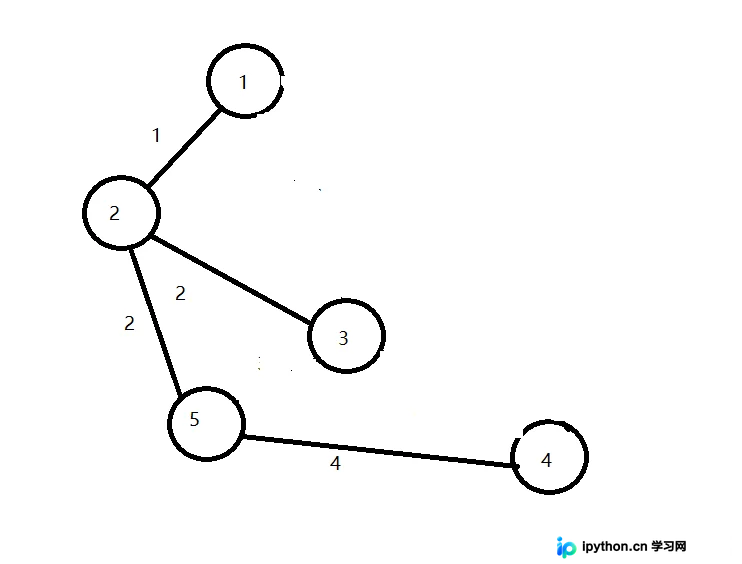
上图对应了点与边结构体的内存布局示意。我们需要关注的最终效果是选出一组特定的边和顶点组合。
C语言代码实现
代码分为结构体定义、状态判断函数及主循环三个部分。核心在于 FindOne 函数用于筛选符合贪心条件的边。
#include <iostream>
using namespace std;

// 点结构体:ID为序号,OnTree标记是否在树上
struct Node {
    int ID;          // 结点序号
    bool OnTree;     // 是否属于最小生成树
};

// 边结构体:N1,N2为端点,V为权值,OnTree标记是否入选
struct LS {
    int N1, N2; int V; bool OnTree;
    LS(int n1, int n2, int v) {
        N1 = n1; N2 = n2; V = v; OnTree = false;
    }
};

// 初始化点数组,默认不在树上
Node A[] = { {1,false}, {2,false}, {3,false}, {4,false}, {5,false} };

// 初始化边数组,定义图的连接关系与权重
LS L[8] = {
    LS(1,2,1), LS(1,3,4), LS(2,3,2),
    LS(2,5,2), LS(4,5,4), LS(3,4,6),
    LS(3,5,3), LS(1,4,8)
};

// 判断函数:检查某条边是否恰好有一个端点在“树”上
bool FindOne(LS L ,Node A[]) {
    int m = 0;
    for (int i = 0; i < 5; i++)
        if (L.N1 == A[i].ID &&& A[i].OnTree) m++;
    for (int i = 0; i < 5; i++)
        if (L.N2 == A[i].ID &&& A[i].OnTree) m++;
    return m ==1; // 只有N1和N2的一个连接到了在“树”上的结点才为真
}

int main()
{
    // 1. 初始状态:第一个结点设为在树上
    A[0].OnTree = true;

    // 2. 主循环:每轮添加一个顶点,共需运行5-1=4次有效扩张(此处循环5次兼容边界)
    for (int i = 0; i < 5; i++) {
        int p = 0;

        // 第二步:遍历所有边,找出第一个满足跨树条件的边作为基准
        for (int j = 0; j < 8; j++) {
            if (FindOne(L[j], A)) {
                p = j; break;
            }
        }

        // 第三步:在所有符合条件的边中,寻找权值最小的边
        for (int i = 0; i < 8; i++) {
            if (FindOne(L[i], A))
                if (L[i].V < L[p].V) p = i;
        }

        // 第四步:记录选中的边(标记OnTree)
        L[p].OnTree = true;

        // 第五步:将选中边的另一个端点标记为已在树上
        for (int i = 0; i < 5; i++) {
            if (L[p].N1 == A[i].ID) A[i].OnTree = true;
            if (L[p].N2 == A[i].ID) A[i].OnTree = true;
        }
    }

    // 输出结果:打印哪些边被选入了最小生成树
    for (int i = 0; i < 8; i++) {
        cout << L[i].OnTree;
    }
}
算法逻辑深度解析
上述代码逻辑可分解为以下几个关键步骤:
- 状态初始化:指定起始节点(如节点1),将其
OnTree设为true。 - 候选边过滤:利用
FindOne函数遍历所有边。该函数统计一条边的两个端点中有多少个已经位于“树”内。如果计数为1,说明该边是连接“树内”与“树外”的桥梁,即候选边。 - 贪心比较:在找到的所有候选边中,比较其权重
V,保留权值最小的那条边索引p。 - 状态更新:将选中的边
L[p]标记为OnTree=true,并将该边连接的、尚未在树上的另一个顶点标记为OnTree=true。 - 循环直至完成:重复上述过程,直到所有顶点都被纳入(或达到预定循环次数)。
FindOne 函数的关键在于确保我们总是向外扩张,而不是在树内部形成回路。只有当一个端点在、另一个不在时,才具备成为MST一部分的资格。
执行过程调试
通过逐步调试,观察变量变化有助于理解算法流程:
第一次迭代:
初始只有节点1在树上。遍历所有边,发现边 (1,2, weight=1) 是唯一的跨桥边且权值最小。因此选中该边,节点2也被加入树上。
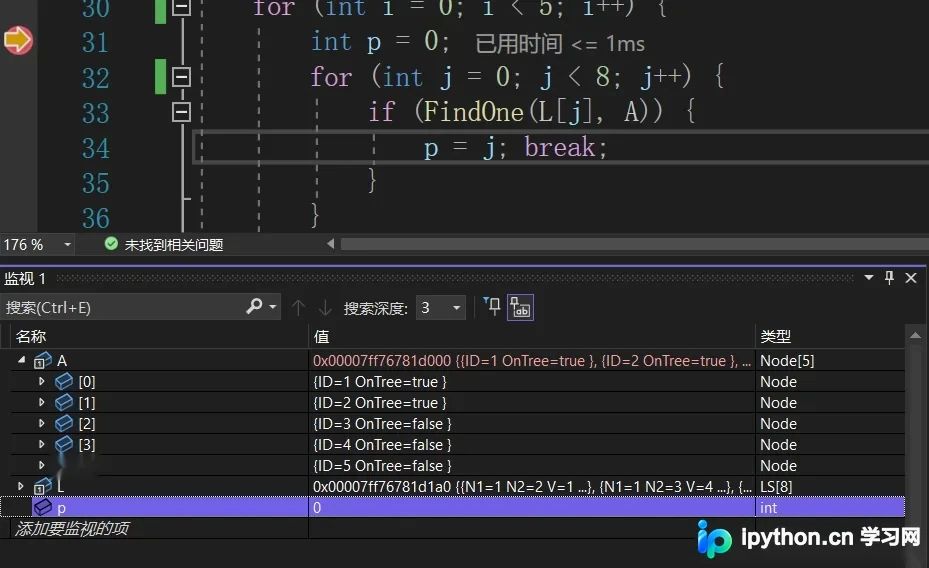
第二次迭代:
此时 {1, 2} 在树上。符合条件的边有 (2,3), (1,3), (1,4) 等。其中边 (2,3, weight=2) 和 (2,5, weight=2) 权值较小,算法选取其中之一(取决于实现细节,通常选先出现或特定逻辑)。假设选中 (2,3),则节点3加入。
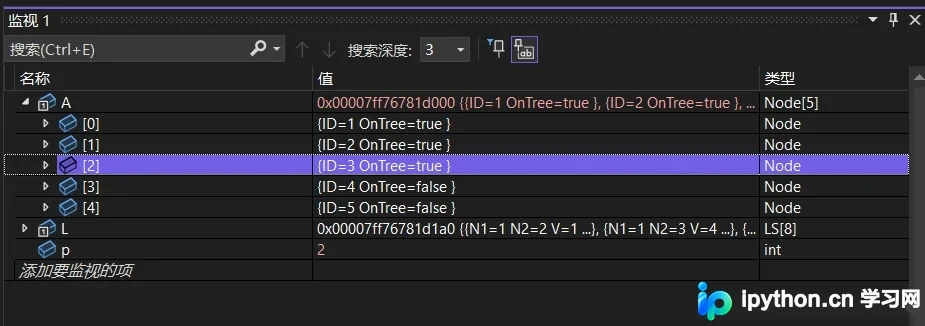
第三次迭代:
此时 {1, 2, 3} 在树上。继续比较跨桥边的权值,例如边 (3,5, weight=3) 可能被选中,节点5加入。
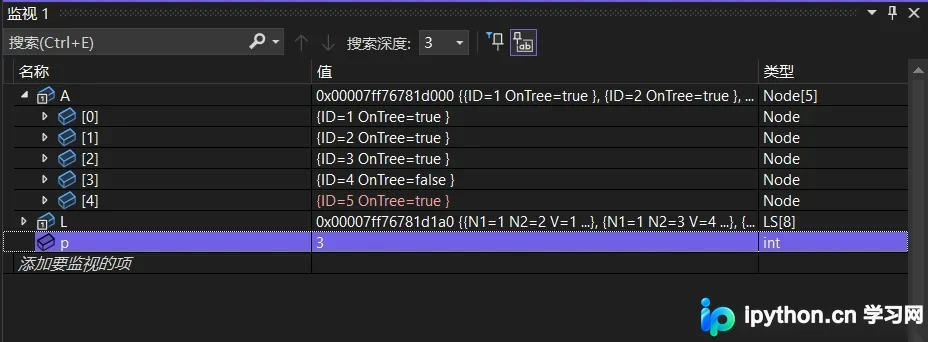
后续迭代:
重复上述比较与标记过程,直到节点4也被连接进来。最终所有的 OnTree 为 true 的边构成了最小生成树。
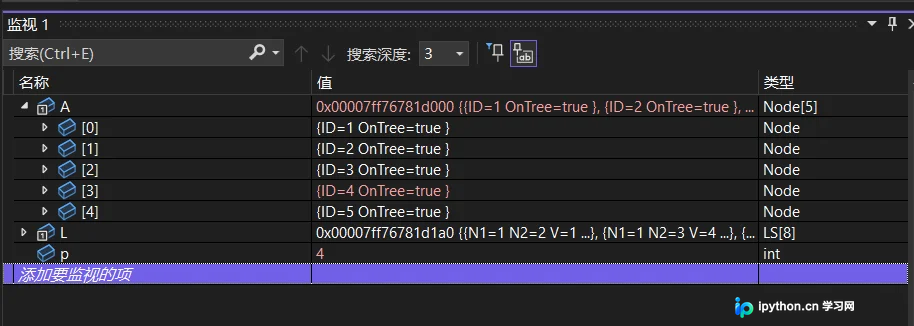
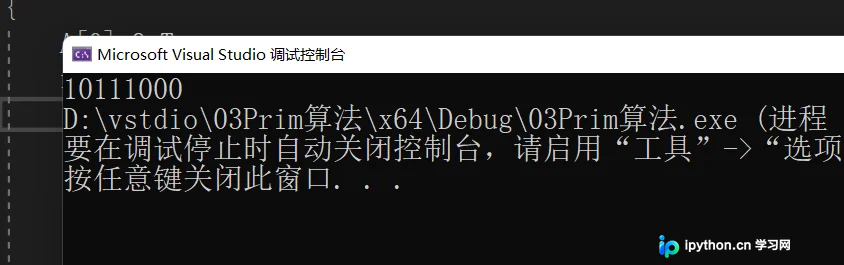
输出验证:
程序最后打印出被选中的边序列。对于给定的测试用例,输出的二进制流代表了边列表中被激活的元素,清晰展示了解析出的最小生成树结构。
总结
Prim算法是解决最小生成树问题的经典贪心算法。本文使用C语言的结构体与数组实现了该过程,重点展示了如何通过状态位标记来管理图的连通性增长。相比Kruskal算法按边排序,Prim算法更贴近于Dijkstra最短路径算法的思想,适合稠密图场景。
以上就是C语言实现Prim算法构造最小生成树的详细内容,更多关于C语言图论算法的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









