

C语言数组操作指南:从创建、内存存储到冒泡排序实战

C语言中数组是最常用的数据结构之一,涵盖了一维和二维形式。本文将从变量的声明与初始化入手,解析数组在内存中的连续存储原理,并深入探讨数组作为函数参数时的指针传递机制,最后通过冒泡排序算法实战,帮助你全面掌握 C 语言的数组操作技巧。
一、一维数组的基础与内存
第1步:创建与变量长度支持
在使用 C 语言定义一维数组时,需要指定数据类型、数组名和大小。标准做法是提供静态常量,但从 C99 标准开始,编译器也支持使用变量来动态定义数组的长度(VLA)。
// 常规静态数组
int num[10];
char arr[10];
double sum[10];

// C99 语法支持变长数组 (Variable Length Array)
int a = 10;
int arr[a];
第2步:数组初始化的规范写法
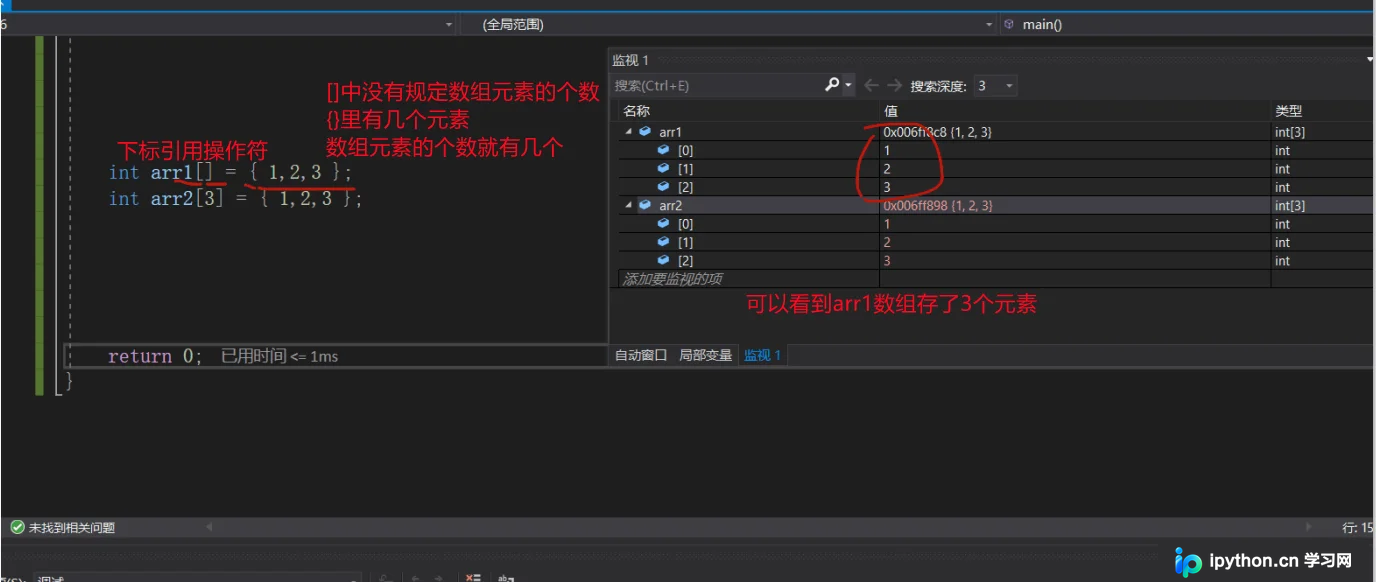
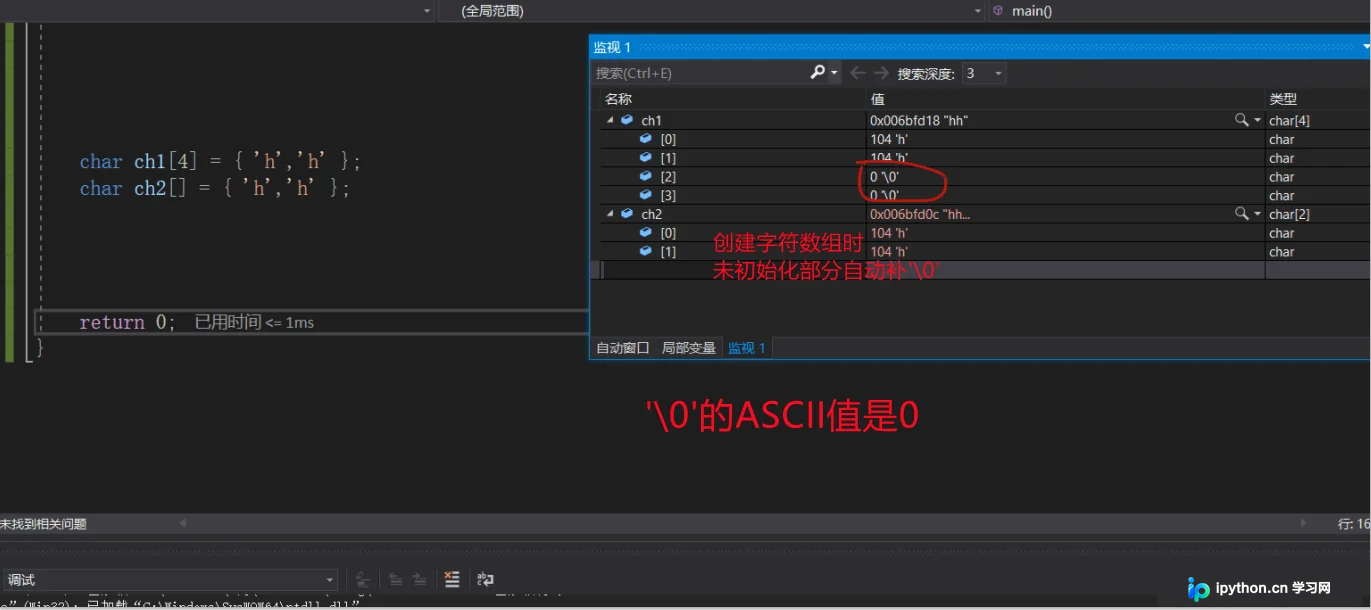
初始化是指定义数组时同时赋予初始值。可以通过 `{}` 方式批量赋值。若提供的初始值少于数组长度,剩余部分会自动填充为 0;若省略大括号内的内容,则所有元素默认为 0(仅适用于自动存储期)或不确定的值(全局/静态数组通常初始化为 0)。注意,对于已确定大小的数组,不能在初始化列表中给出超过元素个数的值。
int arr[3] = {1, 2, 3};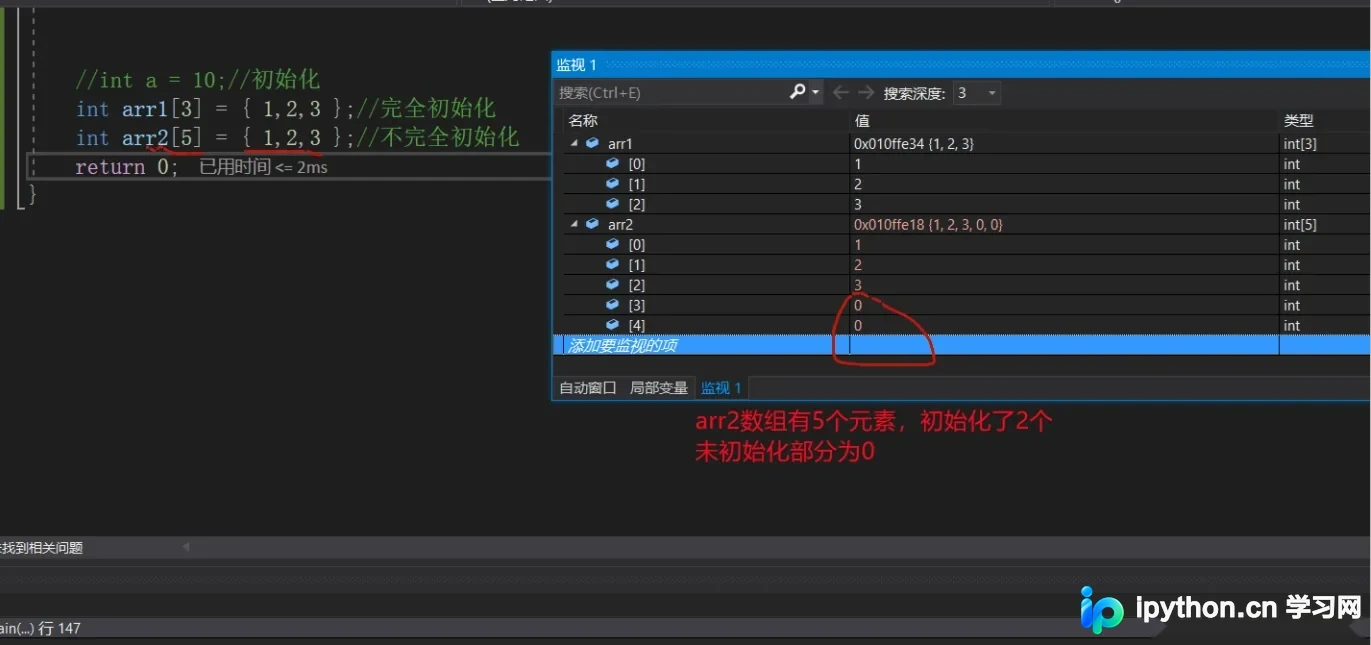
第3步:下标访问与赋值规则
C 语言数组严格遵循“从 0 开始”的下标索引规则。通过 `数组名[下标]` 的形式可以读取或修改特定位置的元素。越界访问(即下标超出 `0` 到 `长度-1` 的范围)会导致未定义行为,可能会引发程序崩溃或数据损坏。
#include<stdio.h>
int main()
{
    int arr[10] = { 0 };// 给每个元素初始化为0
    // 数组是通过下标访问的,下标是从0开始的
    arr[4] = 5; // 把下标为4的元素赋值为5,即第5个元素
    printf("%d\n", arr[4]); // 输出结果为 5
    return 0;
}
第4步:安全计算数组元素个数
为了适应未来修改数组长度的需求,通常不建议将长度硬编码为字面量(如 `for` 循环中的 `10`),而是使用 `sizeof` 运算符动态计算。公式为:sizeof(数组名) / sizeof(数组类型)。
int arr[10];
// sizeof(arr) 返回数组占用的总字节数
// sizeof(arr[0]) 返回单个元素占用的字节数
// 两者相除即为元素个数
int sz = sizeof(arr) / sizeof(arr[0]);
二、二维数组的构建与遍历
第1步:多维数组的声明与行列概念
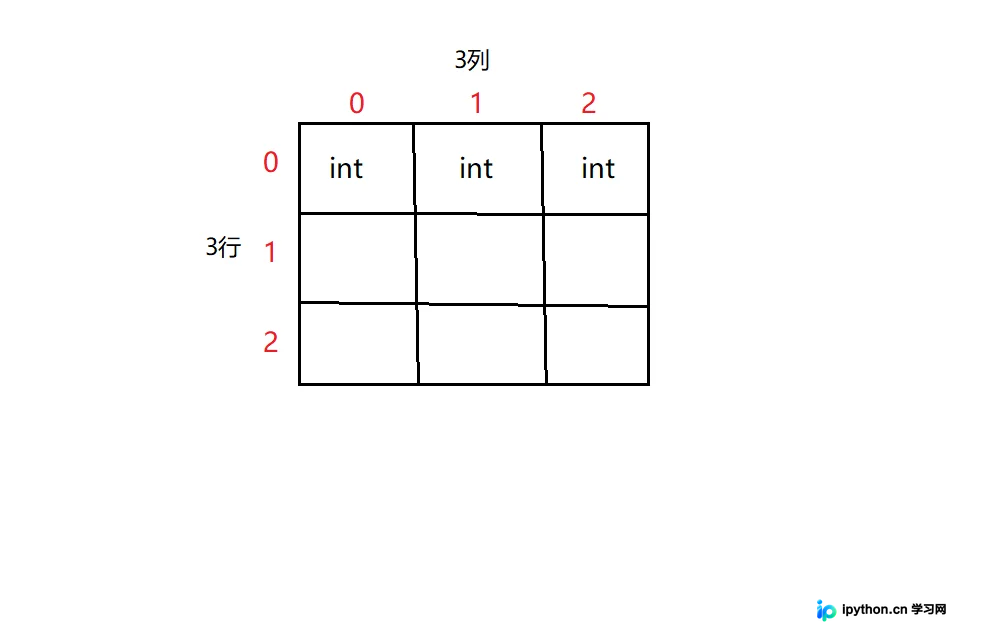
二维数组在数学上可看作表格,分为行和列。声明格式为 `类型 名称[行数][列数]`。值得注意的是,当同时初始化并省略维度时,**只能省略第一维(行),绝不能省略第二维(列)**。因为编译器无法根据后续的扁平化数据流自动判断每行应该截断多少个元素。
// 创建一个3行3列的数组
int arr[3][3];
char sum[3][3];

// []行的部分可以省略,但列的部分不可以
// 编译器会根据初始化的总元素个数和指定的列数自动推算行数
int arr[][3] = { ... };
char sum[][3] = { ... };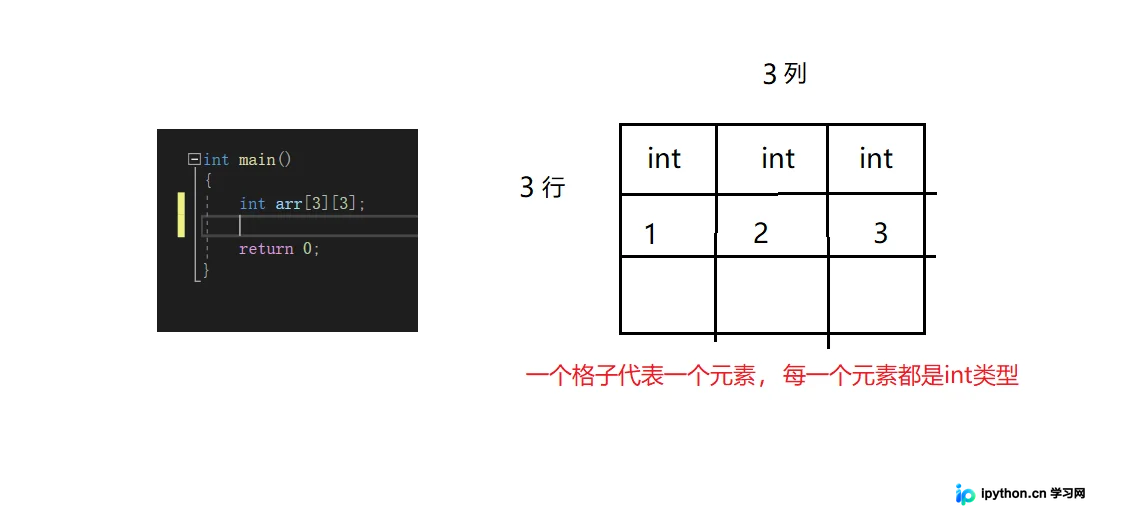
第2步:多维数据的连续初始化
初始化时可以按行逐一赋值,也可以将所有数字放入一个大括号内。如果是后者,数据会按照“行优先”的原则依次填入。比如一个 3x3 的数组,前三个数填第一行,接下来三个数填第二行。
// 创建的同时赋值
// 3行3列的二维数组共包含 9 个元素
int arr[3][3] = { 1, 2, 3, 4, 5, 6, 7, 8, 9 };
int sum[][3] = { 1, 2, 3, 4, 5, 6, 7, 8, 9 }; // 等效写法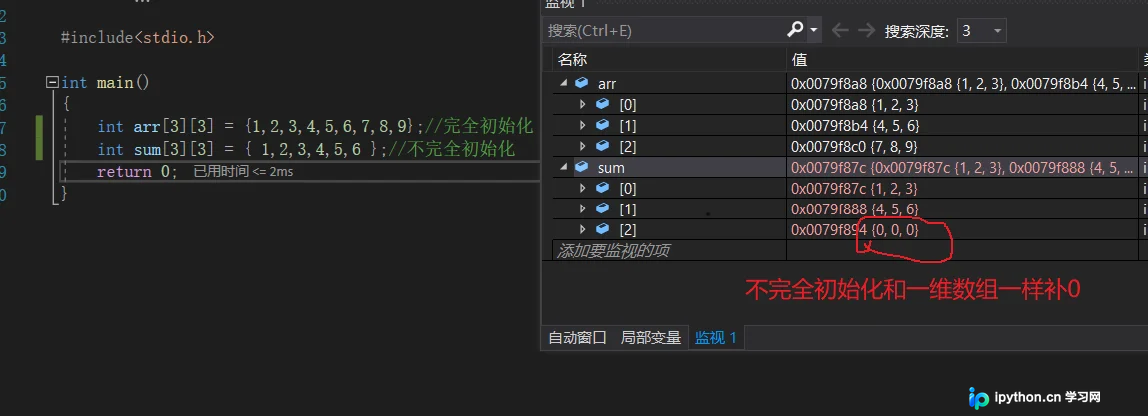
第3步:双重循环遍历
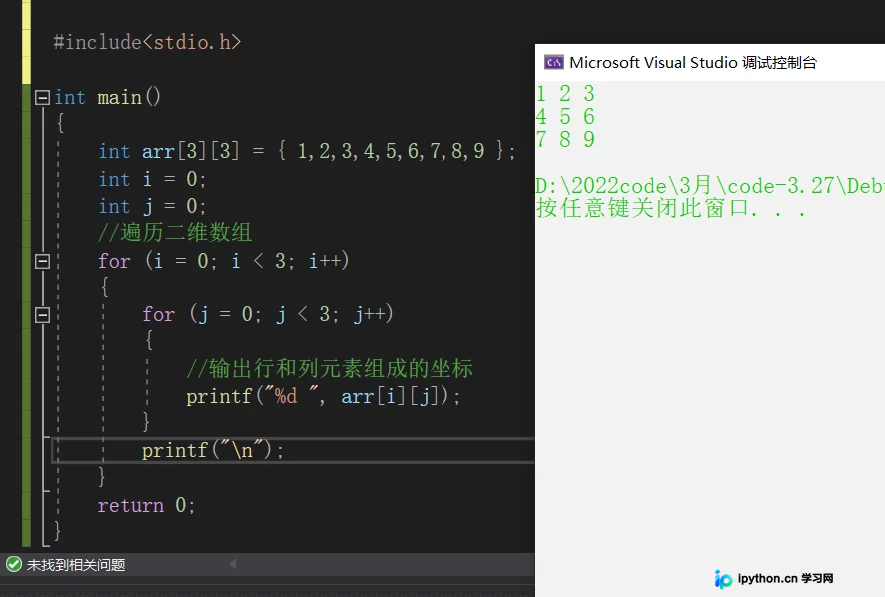
由于二维结构涉及两个维度的变化,必须使用嵌套 for 循环。外层循环控制行号,内层循环控制列号。输出时应注意控制换行,使得打印结果在视觉上呈现为矩阵形态。
#include<stdio.h>
int main()
{
    int arr[3][3] = { 1, 2, 3, 4, 5, 6, 7, 8, 9 };
    int i = 0; // 行下标
    int j = 0; // 列下标

    // 遍历二维数组
    for (i = 0; i < 3; i++)
    {
        for (j = 0; j < 3; j++)
        {
            // 输出当前坐标对应的元素值
            printf("%d ", arr[i][j]);
        }
        printf("\n"); // 每一行结束换行
    }
    return 0;
}
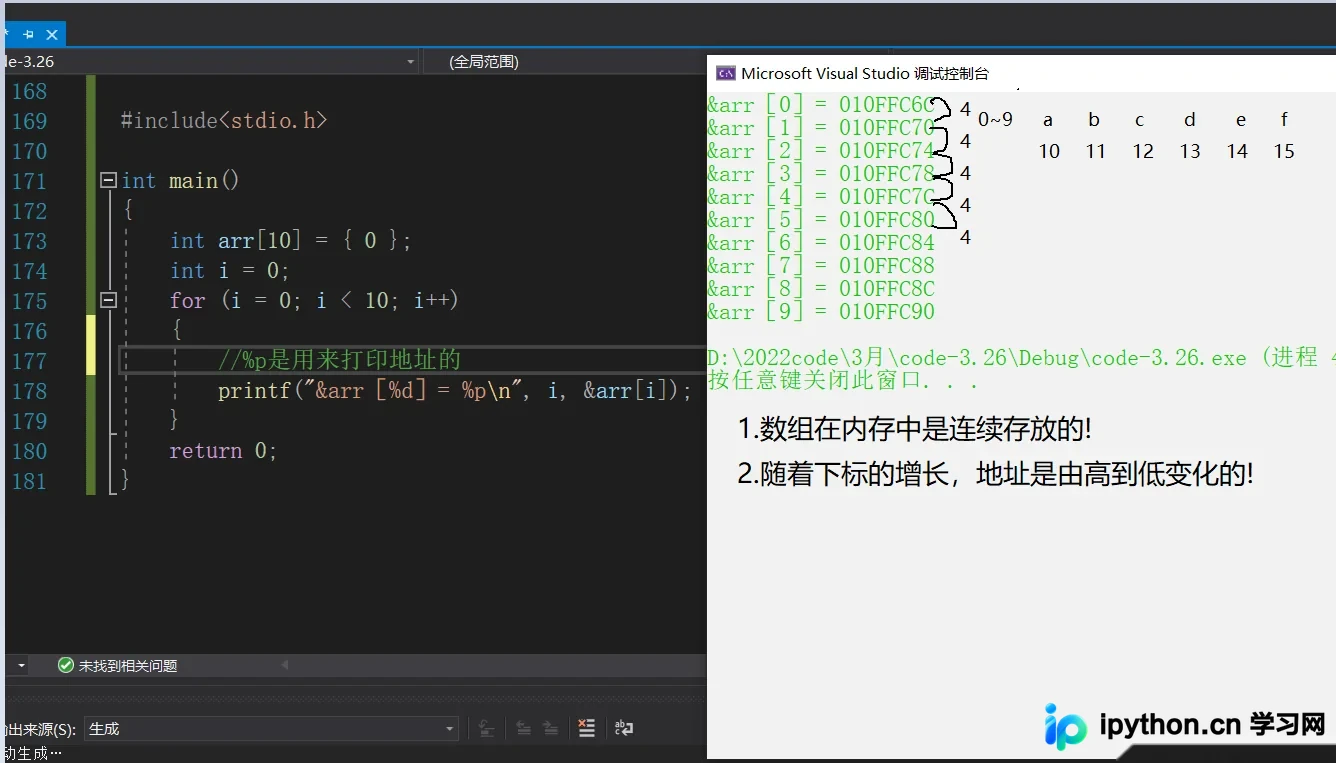
第4步:理解连续内存模型
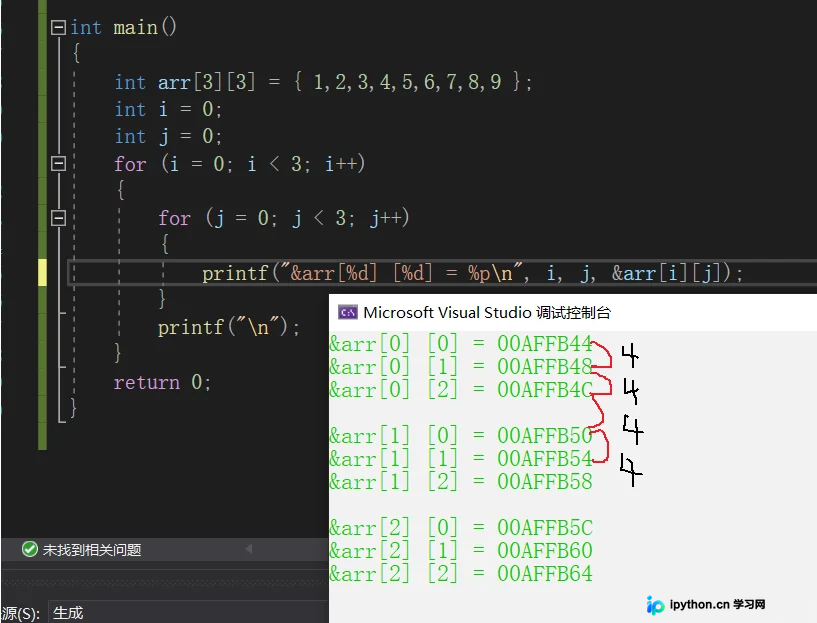
C 语言标准规定,二维数组在计算机内存中也是物理连续存放的。虽然逻辑上分为“行”和“列”,但在底层它们就像拉直的一维数组一样紧密排列。这意味着跨行访问依然是安全的且连续的。
#include<stdio.h>
int main()
{
    int arr[3][3] = { 1, 2, 3, 4, 5, 6, 7, 8, 9 };
    int i = 0, j = 0;
    for (i = 0; i < 3; i++)
    {
        for (j = 0; j < 3; j++)
        {
            // %p 用于打印十六进制地址
            printf("&arr[%d][%d] = %p\n", i, j, &arr[i][j]);
        }
        printf("\n");
    }
    return 0;
}
三、数组作为函数参数的特殊性与排序
第1步:剖析数组名退化为指针的两个例外
通常情况下,“数组名”等同于“数组首元素的地址”。但这存在两个关键的例外情况,考试或实际调试中极易出错:
1. sizeof(数组名):此时数组名代表整个数组,sizeof 计算的是整个数组占据的字节总数。
2. &数组名:此时取出的是整个数组的地址(其类型为指向含有 N 个整型元素的数组的指针,而非普通 int 指针)。
第2步:利用冒泡排序实现数组重排
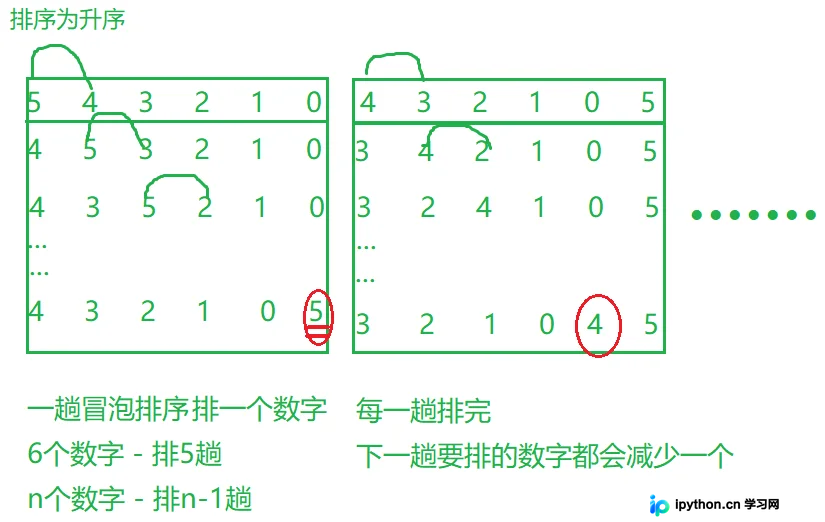
在实际开发中,经常需要对传入函数的数据进行排序。这里以经典的冒泡排序为例。该算法的基本思想是两两比较相邻元素,如果顺序错误就交换它们。通过多轮扫描,最大的元素会逐渐像气泡一样“浮”到数组末尾。
#include<stdio.h>

// void bubble_sort(int arr[], int sz)
// 形参中的 arr[] 本质上就是一个指针 int*,
// 接收到的其实是主调函数传过来的实参数组首元素的地址
void bubble_sort(int arr[], int sz)
{
    int i = 0;
    // 外层循环控制比较的趟数,共有 n-1 趟
    for (i = 0; i < sz - 1; i++)
    {
        int j = 0;
        // 内层循环负责相邻两个数的比较与交换
        // 每一趟结束后,最大数已经归位,所以参与比较的范围减少一次
        for (j = 0; j < sz - 1 - i; j++)
        {
            if (arr[j] > arr[j + 1])
            {
                // 发生逆序,执行交换
                int tmp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = tmp;
            }
        }
    }
}

int main()
{
    int i = 0;
    int arr[] = { 5, 4, 3, 2, 1, 0 };
    // 动态计算数组长度
    int sz = sizeof(arr) / sizeof(arr[0]);

    // 调用冒泡排序函数进行升序排列
    bubble_sort(arr, sz);

    // 打印排序后的结果
    for (i = 0; i < sz; i++)
    {
        printf("%d ", arr[i]);
    }
    return 0;
}
第3步:运行结果验证
经过上述步骤的算法处理后,原本无序的数据将按照从小到大的顺序重新分布,这证明了通过传址(即传首元素地址)修改原始数据的可行性。
以上就是 C 语言数组各种操作的详细内容,更多关于 C 语言数组入门与应用优化的资料请关注本站其它相关文章!0 1 2 3 4 5
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









