

C#符号表查找算法:顺序查找与二分查找实现解析

在现代软件开发中,高效检索海量信息是构建高性能应用的基础。C#中的符号表(Symbol Table)通过建立键(Key)与值(Value)的映射关系,实现了数据的快速存储与查询。本文将深入剖析基于C#实现的两种基础查找算法:无序链表顺序查找和有序数组二分查找,从API定义到核心代码实现,全面解析其工作原理与性能边界。
1. 构建通用符号表基类
要实现高效的查找,首先需要定义一个抽象的符号表接口。符号表有时也被称为字典或索引,其主要目的是将一个键与一个值联系起来,支持插入(Put)、查找(Get)和删除(Delete)等操作。由于典型应用中键通常具有可比性,接口设计需继承 IComparable 以支持有序操作。
第1步:定义符号表通用API接口
目的:确立一套标准的操作方法集合,屏蔽底层数据结构的差异。
关键成员说明:
Put(Key, Value):插入键值对;若值未空则执行删除逻辑。Get(Key):根据键获取对应值,不存在时返回默认值。Rank(Key)&Select(int k):用于有序符号表,分别计算小于key的键数量(排名)和获取排名为k的键。Min()/Max():获取最小或最大键。
以下是通用接口的完整定义:
public interface ISymbolTables<Key,Value> where Key : IComparable
{
    int CompareCount { get; set; }
    void Put(Key key, Value value);
    Value Get(Key key);
    void Delete(Key key);
    bool Contains(Key key);
    bool IsEmpty();
    int Size();
    IEnumerable<Key> Keys();
    Key Min();
    Key Max();
    Key Floor(Key key);
    Key Ceilling(Key key);
    int Rank(Key key);
    Key Select(int k);
    void DeleteMin();
    void DeleteMax();
    int Size(Key lo,Key hi);
    IEnumerable<Key> Keys(Key lo, Key hi);
}
为了统一处理逻辑,我们可以提供一个抽象基类 BaseSymbolTables<Key, Value>,其中大部分方法仅提供默认返回(如 return default(Value) 或 return false),由具体子类通过 override 实现核心逻辑。
2. 无序链表中的顺序查找
对于小规模数据或无序场景,最简单的实现是使用无序链表。每个链表节点存储一个键值对。这种实现被称为**顺序查找(Sequential Search)**。
第2步:实现顺序查找算法
入口:创建 SequentialSearchST 类并继承自基类。
核心逻辑:
- Get操作:遍历链表,使用
Equals比较目标键与当前节点的键。匹配则返回值,否则继续下一节点,最终返回 null。 - Put操作:首先遍历检查键是否已存在。如果存在,更新值;如果不存在,将新键值对作为新节点插入到链表的头部(时间复杂度 O(1))。
以下是 C# 顺序查找的具体实现:
public class SequentialSearchST<Key,Value>:BaseSymbolTables<Key, Value>
    where Key : IComparable
{
    private Node First;
    private class Node
    {
        public Key key;
        public Value value;
        public Node next;
        public Node(Key _key,Value _value,Node _next)
        {
            key = _key;
            value = _value;
            next = _next;
        }
    }

    public override Value Get(Key key)
    {
        for (Node x = First; x != null; x = x.next)
        {
            if (key.Equals(x.key))
                return x.value;
        }
        return default(Value);
    }

    public override void Put(Key key, Value value)
    {
        for (Node x = First; x != null; x = x.next)
        {
            CompareCount++;
            if (key.Equals(x.key))
            {
                x.value = value;
                return;
            }
        }
        // 插入到新节点,指向原头节点
        First = new Node(key,value,First);
    }
}
第3步:测试与性能轨迹分析
输入用例:使用字符串数组 new string[] { "S", "E", "A", "R", "C", "H", "E", "X", "A", "M", "P", "L", "E" } 进行演示。
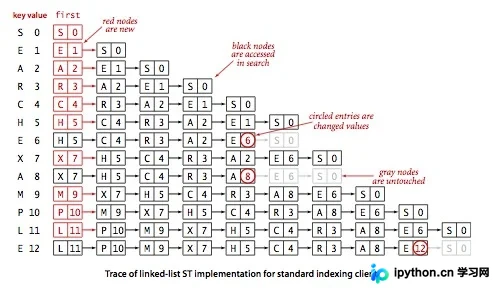 性能结论:
- 成本模型:以比较次数为主要衡量标准。
- 未命中查找与插入:需要 N 次比较。
- 命中查找:最坏情况 N 次,平均约 N/2 次。
- 整体效率:向空表插入 N 个不同键需要 ~N²/2 次比较,属于线性级别的低效方案,不适合大规模数据。
3. 有序数组中的二分查找
当数据量增大且键具有有序性时,二分查找能将查找时间降低至对数级别。该方法使用两个平行的数组分别存储键和值,并保持键的有序排列。
第4步:实现二分查找核心逻辑
目的:利用 Rank 方法定位键的位置,实现 O(lgN) 的快速查找。
Rank 方法实现(二分查找):设定上下界 lo 和 hi,每次取中间值 mid 进行比较。若目标更小则向左搜索,更大则向右搜索。
以下是包含 BinarySearchST 完整实现的代码:
public class BinarySearchST<Key,Value> : BaseSymbolTables<Key, Value>
    where Key : IComparable
{
    private Key[] keys;
    private Value[] vals;
    private int N; // 元素数量

    public BinarySearchST(int capacity)
    {
        keys = new Key[capacity];
        vals = new Value[capacity];
    }

    public override int Size() => N;

    public override Value Get(Key key)
    {
        if (IsEmpty()) return default(Value);
        int i = Rank(key);
        // 检查边界并确认相等
        return (i < N && keys[i].CompareTo(key) == 0) ? vals[i] : default(Value);
    }

    public override int Rank(Key key)
    {
        int lo = 0, hi = N - 1;
        while (lo <= hi)
        {
            int mid = lo + (hi-lo) / 2;
            CompareCount++;
            int cmp = key.CompareTo(keys[mid]);
            if (cmp < 0) hi = mid - 1;
            else if (cmp > 0) lo = mid + 1;
            else return mid;
        }
        return lo; // 返回插入位置
    }

    public override void Put(Key key, Value value)
    {
        int i = Rank(key);
        // 如果键已存在,直接更新值
        if (i < N && keys[i].CompareTo(key) == 0)
        {
            vals[i] = value;
            return;
        }
        // 键不存在,移动元素腾出位置
        for (int j = N; j > i; j--)
        {
            keys[j] = keys[j-1];
            vals[j] = vals[j-1];
        }
        // 插入新元素
        keys[i] = key;
        vals[i] = value;
        N++;
    }

    // 其他支持有序操作的辅助方法
    public override Key Min() => keys[0];
    public override Key Max() => keys[N-1];
    public override Key Select(int k) => keys[k];
    public override Key Ceilling(Key key) => keys[Rank(key)];
}

// Helper for base class
private bool IsEmpty() { return N == 0; } // Note: In real implementation, ensure this is accessible or move to base.
第5步:运行轨迹与复杂度分析
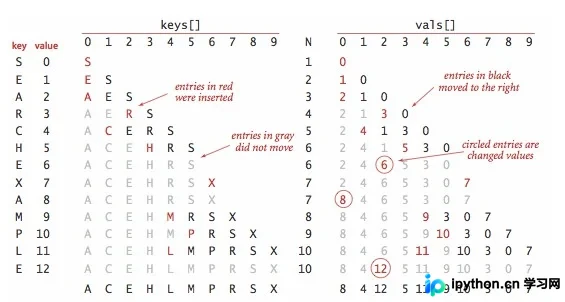 查找优势:
在 N 个键的有序数组中进行二分查找,最多只需
lgN + 1 次比较。这使得查找操作极其高效。
插入劣势:
虽然查找快,但 Put 方法涉及数组元素的移动。在最坏情况下(插入到第一个位置),需要移动 N 个元素。因此,构造一个有 N 个元素的有序表,最坏情况访问数组次数约为 N²。
总结对比:
| 算法 | 最坏查找成本 | 最坏插入成本 | 是否支持有序操作 |
| :--- | :--- | :--- | :--- |
| **顺序查找(无序链表)** | N | N | 否 |
| **二分查找(有序数组)** | lgN | 2N | 是 |
由此可见,如果应用场景主要侧重于静态查找(即初始化后极少修改),有序数组+二分查找是极佳的选择;而如果频繁插入删除,则需要考虑更高级的数据结构(如红黑树或哈希表)来平衡性能。
以上就是关于C#使用符号表实现查找算法的详细内容,更多关于C#数据结构与算法优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









