

C# 实现归并排序算法:原理、代码与优化

归并排序是一种基于分治思想的高效排序算法,能够保证在任意规模数据下保持稳定的 O(N logN) 时间复杂度。在 C# 实现中,它依赖于一个辅助数组来合并两个有序子序列。本文将演示如何编写自顶向下(递归)和自底向上(迭代)两种版本的归并排序,并介绍关键的优化步骤。
归并排序的核心逻辑
归并排序的基本概念是将两个已经有序的数组合并成一个更大的有序数组。算法将目标数组递归地分成两半分别进行排序,最后将排好序的两部分结果“归并”在一起。该算法的主要优势在于稳定的 O(N logN) 表现,主要缺点则是需要与输入数组大小成正比的额外空间。
第一步:实现原地/非原地归并 (Merge) 方法
目的: 构建核心的合并函数,将两个相邻的有序子数组合并为单一有序数组。
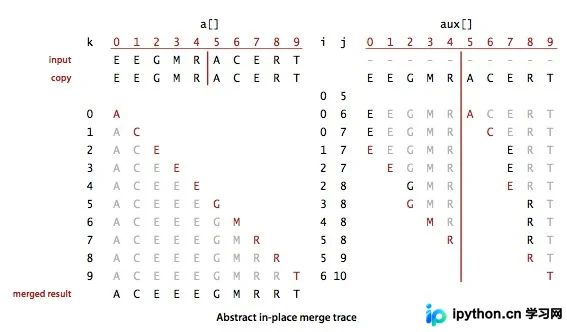
操作说明: 由于 C# 数组在内存中连续存储,直接在原数组上移动元素效率极低。标准做法是开辟一个与原数组等长的辅助数组 aux。我们将 a[lo...hi] 的数据复制到 aux 中,然后使用两个指针分别从左半部分的起始位置和右半部分的起始位置开始比较。
关键逻辑:
- 取左侧剩余部分较小者放入
a[k],若左半部取完,则直接取右半部。 - 取右侧剩余部分较小者放入
a[k],若右半部取完,则直接取左半部。
        // 归并 a[lo..mid] 和 a[mid+1..hi]
        public static void Merge(IComparable[] a, int lo, int mid, int hi)
        {
            int i = lo;           // 左边部分的索引
            int j = mid + 1;      // 右边部分的索引

            // 先将数据拷贝到辅助数组,避免频繁移动原数组元素
            for (var k = lo; k <= hi; k++)
            {
                aux[k] = a[k];
            }

            // 将两个有序子序列归并回原数组 a
            for (var k = lo; k <= hi; k++)
            {
                if (i > mid)
                    a[k] = aux[j++];  // 左侧已处理完,取右侧
                else if (j > hi)
                    a[k] = aux[i++];  // 右侧已处理完,取左侧
                else if (Less(aux[j], aux[i]))
                    a[k] = aux[j++];  // 右侧元素更小,取右侧
                else
                    a[k] = aux[i++];  // 左侧元素更小或相等,取左侧
            }
        }
第二步:实现自顶向下的递归归并排序
目的: 利用分治法,将大问题拆分为小问题。
入口: 调用 Sort(a)。
操作顺序:
- 准备: 实例化一个与排序数组等长的静态辅助数组
aux,这只需在顶层调用时进行一次。 - 划分: 计算中间点
mid = lo + (hi-lo)/2,分别对左半部分a[lo...mid]和右半部分a[mid+1...hi]进行递归排序。 - 合并: 当左右两部分都排好序后,调用上述
Merge方法进行归并。 - 终止条件: 当
hi <= lo时,子数组长度为 0 或 1,自然有序,直接返回。
    public class MergeSort : BaseSort
    {
        public static IComparable[] aux = null;

        // 顶层入口,初始化辅助数组
        public static void Sort(IComparable[] a)
        {
            aux = new IComparable[a.Length];
            Sort(a, 0, a.Length - 1);
        }

        // 递归排序 a[lo...hi]
        public static void Sort(IComparable[] a, int lo, int hi)
        {
            if (hi <= lo) return;
            int mid = lo + (hi - lo) / 2;

            Sort(a, lo, mid);      // 排序左半部分
            Sort(a, mid + 1, hi);  // 排序右半部分

            Merge(a, lo, mid, hi); // 归并结果
        }
    }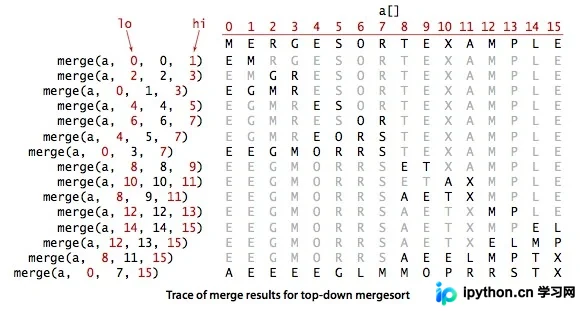
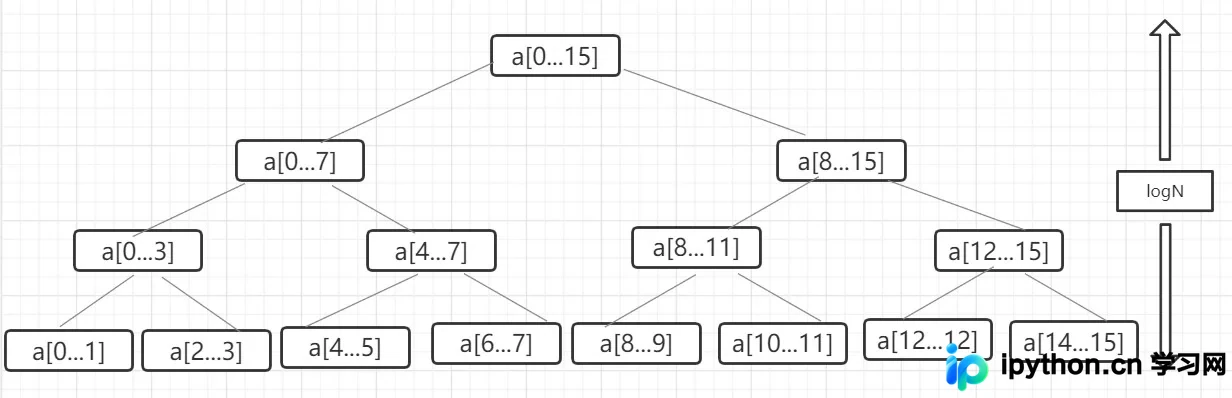
自顶向下的过程像一棵倒置的树。首先不断分裂直至长度为 1 的元素,然后从叶子节点开始向上两两归并。正如图片所示轨迹,这种结构保证了每一层的总比较次数约为 N,总共 logN 层,因此总体比较次数介于 1/2 N logN 到 N logN 之间。
第三步:性能优化策略
虽然标准版归并排序已经很快,但在实际工程中可以进行以下调整以提升效率:
- 小规模数组切换插入排序: 当待排序的子数组长度小于某个阈值(如 15)时,切换到插入排序。插入排序在小规模数据下常数因子更低,通常可提升约 10%-15% 的性能。
- 检测有序性: 在调用
Merge之前增加判断:if (!a[mid].CompareTo(a[mid + 1]) > 0) return;。如果左半部分的最大值小于等于右半部分的最小值,说明数组本身已经有序,无需进行归并操作。这能让算法在处理部分有序数据时达到线性时间O(N)。
第四步:实现自底向上的迭代归并排序
目的: 消除递归调用的栈开销,适用于特定的数据结构(如链表)或对栈深度敏感的场景。
思路: 不再先拆分再合并,而是先两两归并相邻的小数组,再四四归并,接着八八归并,以此类推,直到将整个数组合并完成。
操作逻辑:
- 外层循环控制步长
sz,从 1 开始每次翻倍(1, 2, 4, ...),直到超过数组长度。 - 内层循环以
sz + sz为步长遍历数组。 - 对每段长度为
sz的区间及其相邻区间进行归并。
    public class MergeSortBu : MergeSort
    {
        public static void Sort(IComparable[] a)
        {
            aux = new IComparable[a.Length];
            int n = a.Length;

            // sz: 当前子数组的长度
            for (var sz = 1; sz < n; sz = sz + sz)
            {
                // lo: 每个子区间的起始位置
                for (int lo = 0; lo < n - sz; lo += sz + sz)
                {
                    // 注意处理数组边界,防止越界
                    int hi = Math.Min(lo + sz + sz - 1, n - 1);
                    Merge(a, lo, lo + sz - 1, hi);
                }
            }
        }
    }
自底向上的归并排序在数组长度是 2 的幂时,其比较次数和访问次数与自顶向下的完全一致。由于不需要递归栈支持,它在某些特定环境下更具优势。
以上就是 C# 实现归并排序的详细内容,更多关于 C# 算法实现与优化资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









