

C# 并查集(Union-Find)算法详解:从原理到最优实现

并查集(Union-Find)是一种用于处理不相交集合合并与查询问题的数据结构。本文基于C#语言,深入解析动态连通性问题的抽象接口定义,并逐步演进四种经典实现算法:Quick-Find、Quick-Union、加权Quick-Union以及引入路径压缩的最优版本,详细对比它们在时间复杂度上的差异及适用场景。
动态连通性与问题定义
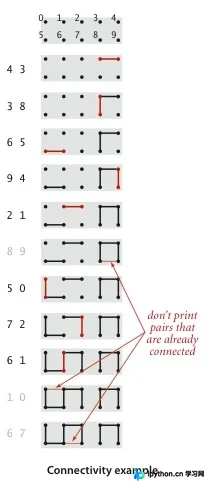
并查集主要解决动态连通性问题。在输入一对整数对序列时,每个整数代表一个对象,我们将这对整数解释为“两者已连接”。这种关系具备等价关系的三个特性:
- 对称性:若 p 连接到 q,则 q 连接到 p。
- 传递性:若 p 连接到 q 且 q 连接到 r,则 p 连接到 r。
- 自反性:p 与 p 连接。
该问题旨在从输入序列中过滤掉多余的对,即当读取整数对 p 和 q 时,如果它们已经属于同一个连通分量,则忽略;否则,将它们合并并输出。这在网络通信、变量名等价性及数学集合运算中有广泛应用。
API 设计与基础结构
为了精确解决问题,首先设计一套标准 API 来封装基本操作:初始化、连接两个触点、查找触点所属分量、判断是否连通以及统计连通分量数量。
/// <summary>
/// 动态连通API
/// </summary>
public interface IUnionFind
{
    /// <summary>
    /// 连接
    /// </summary>
    void Union(int p, int q);

    /// <summary>
    /// 查找触点 p 的分量标识符
    /// </summary>
    int Find(int p);

    /// <summary>
    /// 判断两个触点是否处于同一分量
    /// </summary>
    bool Connected(int p, int q);

    /// <summary>
    /// 连通分量的数量
    /// </summary>
    int Count();
}
算法的核心任务是基于数组结构实现此 API。使用以触点的值为索引的 id 数组表示分量,初始状态下每个触点自成一组。
1. Quick-Find 算法实现
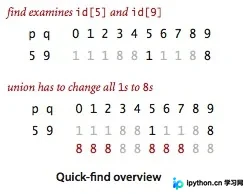
Quick-Find 的核心原则是:保证只有当 id[p] == id[q] 时,p 和 q 才是连通的。这意味着同一个连通分量中的所有触点,在数组 id 中的值必须完全相同。
第 1 步:实现 Quick-Find
目的:构建满足等价关系的初始模型。
入口:初始化大小为 n 的数组。
动作:
- Find(p):直接返回 id[p]。
- Union(p, q):若 Find(p) != Find(q),则遍历整个数组,将所有等于 Find(q) 的值修改为 Find(p)。
public class QuickFindUF : IUnionFind
{
    private int[] id;
    private int count;

    public QuickFindUF(int n)
    {
        count = n;
        id = new int[n];
        for (var i = 0; i < n; i++) id[i] = i;
    }

    public int Find(int p) => id[p];

    public bool Connected(int p, int q) => Find(p) == Find(q);

    public void Union(int p, int q)
    {
        var pID = Find(p);
        var qID = Find(q);
        if (pID == qID) return;
        for (var i = 0; i < id.Length; i++)
            if (id[i] == qID) id[i] = pID;
        count--;
    }

    public int Count() => count;
}
算法分析
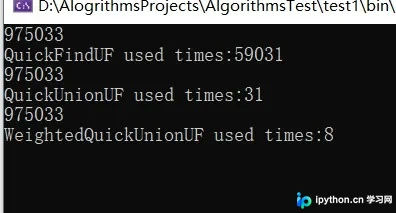
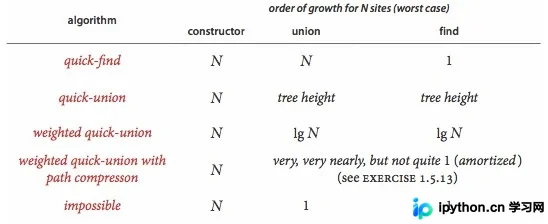
Quick-Find 的 Find 操作极快,仅需访问一次数组。然而,Union 操作代价高昂,每次可能需要扫描整个长度为 N 的数组。在最坏情况下(所有点最终合并为一个分量),处理 N-1 次连接的总开销约为 $O(N^2)$,平方级的时间复杂度使其难以应对大规模数据。
2. Quick-Union 算法实现
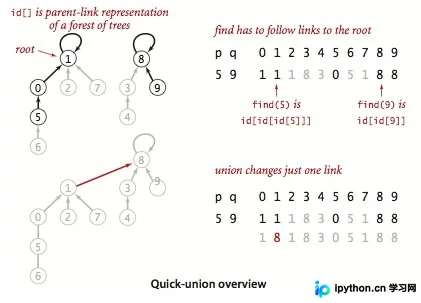
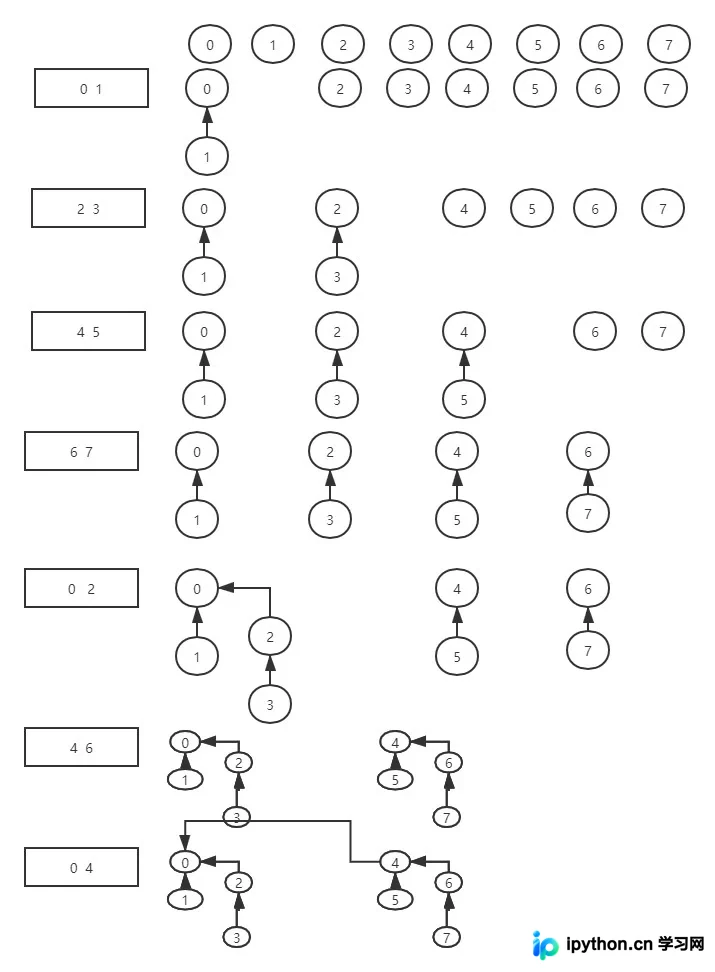
为了解决 Union 慢的问题,Quick-Union 改进了数据存储方式。它同样使用 id 数组,但此时 id[i] 不再代表分量 ID,而是指向同一分量中的另一个触点(父节点)。这使得数据结构呈现出一棵棵树的形式。
第 2 步:实现 Quick-Union
目的:利用树结构减少 Union 操作的移动次数。
动作:
- Find(p):沿父节点链接向上查找,直到 p == id[p](到达根节点)。
- Union(p, q):分别找到 p 和 q 的根节点,将其中一个根节点的父指针指向另一个根节点。
public class QuickUnionUF : IUnionFind
{
    private int[] id;
    private int count;

    public QuickUnionUF(int n)
    {
        count = n;
        id = new int[n];
        for (var i = 0; i < n; i++) id[i] = i;
    }

    public int Find(int p)
    {
        while (p != id[p]) p = id[p];
        return p;
    }

    public bool Connected(int p, int q) => Find(p) == Find(q);

    public void Union(int p, int q)
    {
        var pRoot = Find(p);
        var qRoot = Find(q);
        if (pRoot == qRoot) return;
        id[pRoot] = qRoot; // 将一棵树连到另一棵树上
        count--;
    }

    public int Count() => count;
}
森林表示
id 数组现在表示一片森林。每个节点指向其父节点,初始化时每个节点指向自己。Find 操作沿着链接查找至根节点。
算法分析
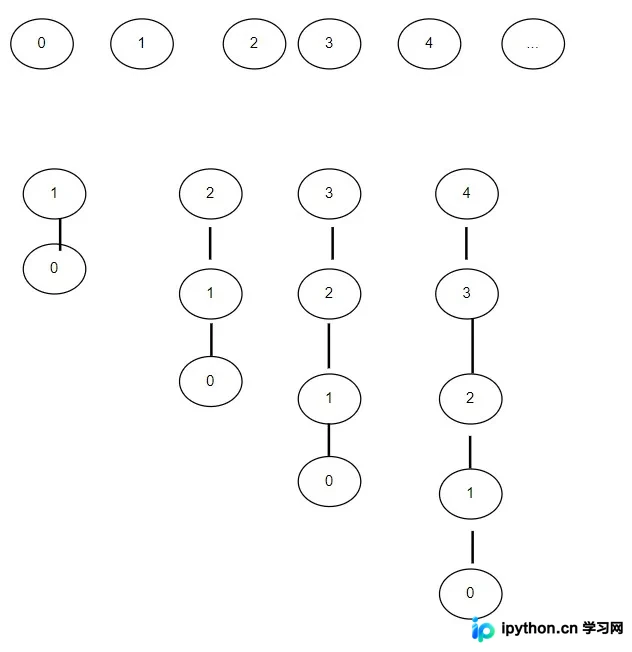
Quick-Union 避免了 Union 时的全数组扫描,但在最坏情况下(例如按顺序 0-1, 0-2... 连接形成一条长链),树的高度可能达到 N。此时 Find 的深度也为 N,总复杂度仍可能退化为 $O(N^2)$。
3. 加权 Quick-Union 算法实现
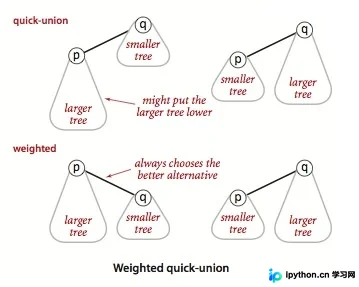
为了避免树变得过高导致性能下降,我们可以在连接两棵树时,始终将较小的树连接到较大的树下。这称为加权 Quick-Union。
第 3 步:实现加权 Quick-Union
目的:通过控制树的生长方向,保证树的高度保持在对数级别。
参数:新增 sz[] 数组记录以各节点为根的树的大小。
动作:在 Union 时比较 sz[pRoot] 和 sz[qRoot],小树挂到大树上,并更新大小。
public class WeightedQuickUnionUF : IUnionFind
{
    private int[] sz; // 记录根节点对应的树的大小
    private int[] id;
    private int count;

    public WeightedQuickUnionUF(int n)
    {
        count = n;
        id = new int[n];
        sz = new int[n];
        for (var i = 0; i < n; i++)
        {
            id[i] = i;
            sz[i] = 1;
        }
    }

    public int Find(int p)
    {
        while (p != id[p]) p = id[p];
        return p;
    }

    public bool Connected(int p, int q) => Find(p) == Find(q);

    public void Union(int p, int q)
    {
        var pRoot = Find(p);
        var qRoot = Find(q);
        if (pRoot == qRoot) return;

        if (sz[pRoot] < sz[qRoot])
            id[pRoot] = qRoot;
        else
        {
            id[qRoot] = pRoot;
            if (sz[pRoot] == sz[qRoot]) sz[pRoot]++; // 大小相等时树高+1
        }
        count--;
    }

    public int Count() => count;
}
算法分析
由于我们总是将小树合并到大树,树的高度增长速度被极大限制。对于 N 个触点,树的最大高度不会超过 logN。因此,加权 Quick-Union 在最坏情况下的操作成本仅为 $O( ext{log}N)$。这是前三种算法中唯一能高效处理大规模数据(如百万级触点)的版本。
4. 最优算法:带路径压缩的加权 Quick-Union
虽然加权 Quick-Union 已经非常优秀,但我们在 Find 过程中可以进一步优化。如果在查找根节点的过程中,将路径上的所有节点都直接指向根节点,可以进一步降低后续查找的成本,这就是路径压缩(Path Compression)。
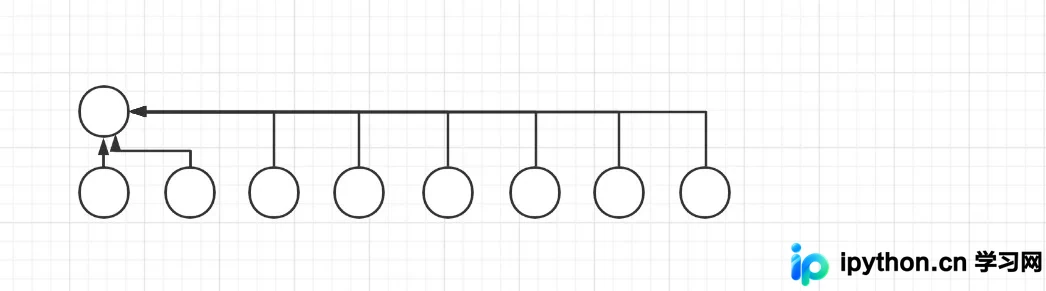
实现方式
可以在迭代式查找中加入逻辑:id[p] = id[id[p]],这将使得节点在查找过程中直接跳向更高层级的父节点,逐步将树压平。
综合改进策略总结
研究此类基础算法的标准步骤包括:
- 完整定义问题,建立抽象 API。
- 实现初级算法并进行基准测试。
- 当规模不达标时进行经验性或数学性分析以指导改进。
- 引入更高阶的抽象概念(如加权、路径压缩)来获得性能保障。
以上就是 C# 并查集算法详解的详细内容,更多关于 C# 高级数据结构优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









