

C语言数据内存存储详解:原码补码与大小端判断

发布时间:2026-10-16| 7人浏览过
C语言数据的内存存储是理解程序底层行为的关键。本文将详细讲解整型和浮点型的表示方式,重点分析原码、反码与补码的计算逻辑,并介绍如何通过编程检测系统的大小端字节序,为解决潜在的数据对齐和兼容性问题是基础。
数据类型与内存空间
在C语言中,变量需要在内存中开辟空间,其大小由数据类型决定。常见的类型及其归类如下:
1. 整形家族
包括有符号(signed)和无符号(unsigned)类型:
char:字符型,通常为1字节。short:短整型,通常为2字节。int:整型,通常为4字节。long/long long:长整型及更长整型。
2. 浮点数家族
float:单精度浮点数。double:双精度浮点数。
3. 其他类型
- 构造类型:数组、结构体(
struct)、枚举(enum)、联合(union)。 - 指针类型:
int *,char *,void *等。 - 空类型:
void,用于表示函数返回值或参数无类型,以及通用指针。
整型在内存中的存储原理
计算机系统中,数值一律使用补码来表示和存储。这主要是因为在CPU中只有加法器,使用补码可以将符号位和数值域统一处理,使加法和减法运算无需额外的硬件电路支持。
原码、反码与补码的定义
- 原码:直接将二进制按正负数形式翻译。最高位为符号位(0为正,1为负)。
- 反码:正数的反码与其原码相同;负数的反码是符号位不变,其余位取反。
- 补码:正数的补码与其原码相同;负数的补码是其反码加1。
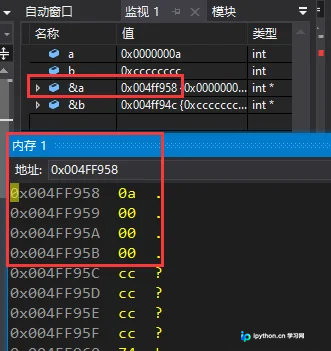
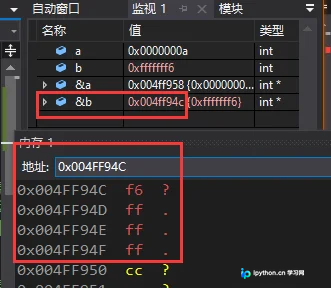
以下代码展示了整数 a = 20 和 b = -10 在内存中的存储形式:
int main()
{
	int a = 20;
	// 原码:00000000 00000000 00000000 00010100
	// 反码:00000000 00000000 00000000 00010100
	// 补码:00000000 00000000 00000000 00010100
	// 内存存储(十六进制):00 00 00 14

	int b = -10;
	// 原码:10000000 00000000 00000000 00001010
	// 反码:11111111 11111111 11111111 11110101
	// 补码:11111111 11111111 11111111 11110110
	// 内存存储(十六进制):FF FF FF F6
	return 0;
}
通过补码进行运算可以简化硬件设计。例如计算 1 + (-1):
1 的补码为 0x00000001,-1 的补码为 0xFFFFFFFF。两者相加后截断32位结果为 0,符合预期。若使用原码直接相加,则无法得到正确结果。
大小端字节序(Byte Order)
概念区分
当数据长度大于1字节时(如 int、short),需要确定多字节在内存中的排列顺序:
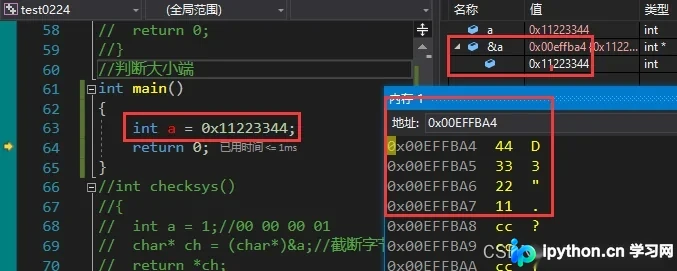
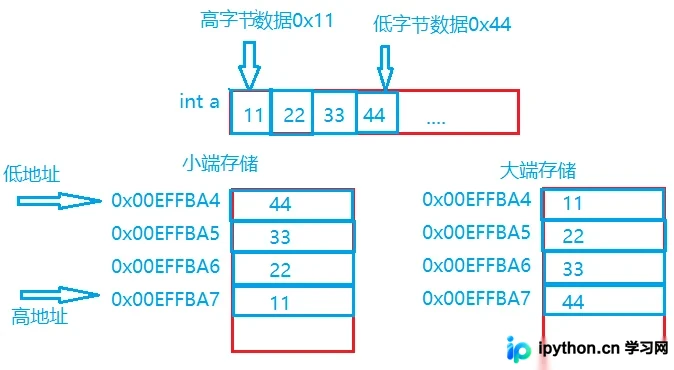
- 小端模式(Little-endian):低位字节存放在低地址,高位字节存放在高地址。常见于X86架构、ARM(默认配置)。
- 大端模式(Big-endian):高位字节存放在低地址,低位字节存放在高地址。常见于网络传输协议及部分DSP处理器。
假设 short x = 0x1122,起始地址为 0x0010:
- 小端:地址 0x0010 存 0x22,地址 0x0011 存 0x11。
判断系统字节序的代码实现
利用指针强制类型转换的特性,可以检测当前系统的字节序。如果将一个 int 类型的低地址作为 char* 访问,读取到的第一个字节即为最低地址的内容。
int check_sys()
{
    int a = 1; // 内存布局:00 00 00 01 (大端) 或 01 00 00 00 (小端)
    char* ch = (char*)&a; // 将int地址转为char指针,指向最低地址
    return *ch; // 解引用获取最低地址的值
}

int main()
{
    if (check_sys() == 1)
    {
        printf("系统为小端模式\n");
    }
    else
    {
        printf("系统为大端模式\n");
    }
    return 0;
}
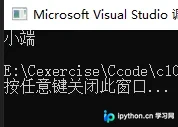
上述代码中,若返回值为1,说明低地址存储的是低字节(01),即为小端模式。执行结果如下:
以上就是C语言中数据存储在内存中的详细机制,包括整数补码计算和大端小端的判断方法,更多关于C语言底层优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









