

C语言冒泡排序与选择排序详解及代码实现

发布时间:2026-10-16| 6人浏览过
本文深入解析C语言中常用的冒泡排序与选择排序算法。内容涵盖两种算法的核心执行逻辑、标准代码实现以及从性能表现到稳定性的详细对比,帮助读者快速掌握基础排序技巧。
一、冒泡排序
冒泡排序(Bubble Sort)是一种基础的交换排序算法。它重复地走访要排序的数列,一次比较两个元素,如果它们的顺序错误就把它们交换过来。走访数列的工作是重复地进行直到没有再需要交换,也就是说该数列已经排序完成。这个算法的名字由来是因为越小的元素会经由交换慢慢“浮”到数列的顶端。
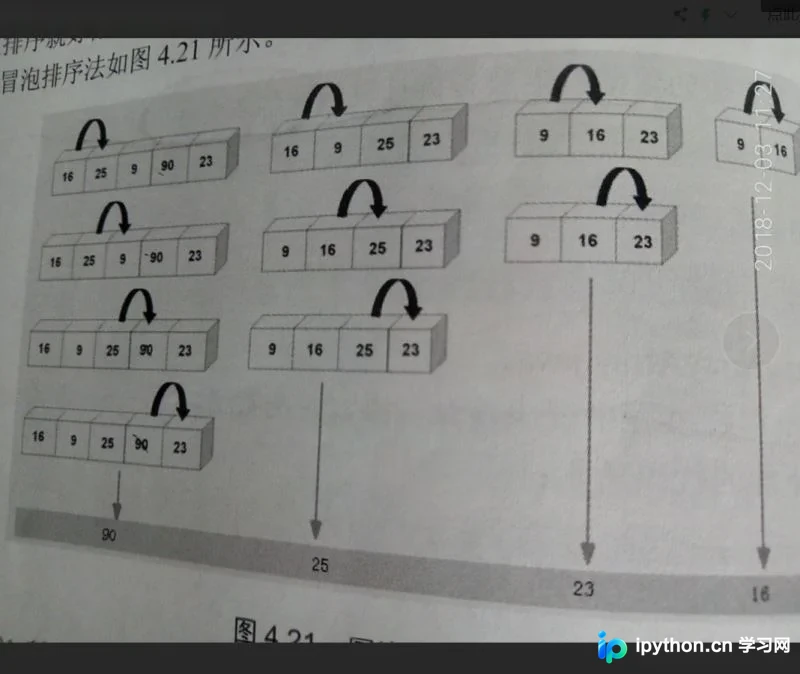
冒泡排序示意图
以一组数据为例,每次比较相邻的两个值,较小的向前移动。第一轮结束后,最大的数会被交换到最后;第二轮结束后,第二大的数排倒数第二,依此类推。若数组长度为 n,则需要比较 n-1 轮,第 i 轮需要比较 n-1-i 次。
以下代码演示如何使用二重循环对5个整数进行升序排序:
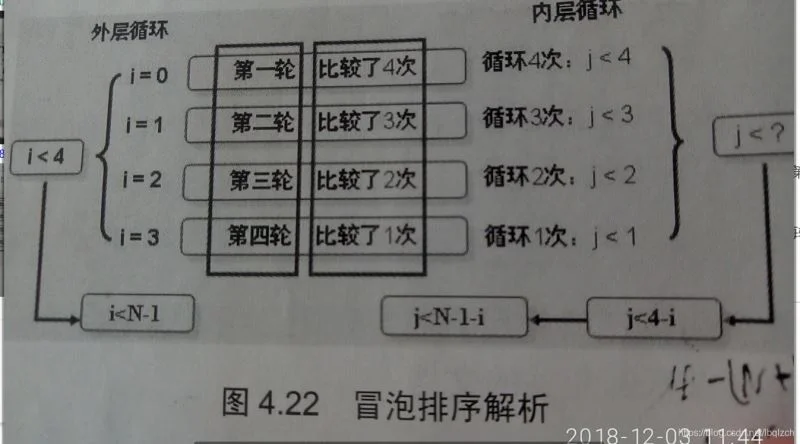
双重循环结构示意
#include <stdio.h>
#define NUM 5

// 声明函数
void arrsort(int a[], int n);
void arrout(int a[], int n);

int main() {
    // 初始化测试数组
    int a[NUM] = {16, 25, 9, 90, 23};

    // 输出排序前数据
    printf("Original: ");
    arrout(a, NUM);

    // 调用排序函数
    arrsort(a, NUM);

    // 输出排序后数据
    printf("Sorted:   ");
    arrout(a, NUM);

    return 0;
}

// 冒泡排序核心逻辑
void arrsort(int a[], int n) {
    for (int i = 0; i < n - 1; i++) {       // 外层控制轮数
        for (int j = 0; j < n - 1 - i; j++) { // 内层控制每轮比较次数
            if (a[j] > a[j + 1]) {            // 相邻元素比较
                // 交换位置
                int temp = a[j + 1];
                a[j + 1] = a[j];
                a[j] = temp;
            }
        }
    }
}

// 辅助打印函数
void arrout(int a[], int n) {
    for (int i = 0; i < n; i++) {
        printf("%3d", a[i]);
    }
    printf("\n");
}
运行上述代码,终端将依次输出原始序列与排序后的序列:
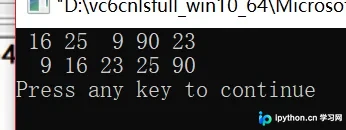
程序输出结果示例
二、选择排序
选择排序(Selection Sort)也是一种简单直观的排序算法。它的核心思想是每一轮从未排序区间中找到最小(或最大)元素,存放到已排序区间的末尾。具体步骤如下:
- 首先在未排序序列中找到最小元素,存放到排序序列的起始位置。
- 然后,再从剩余未排序元素中继续寻找最小元素,然后放到已排序序列的末尾。
- 重复第二步,直到所有元素均排序完毕。
这种算法的逻辑可以理解为:先不急于交换,而是记录下当前最小值的位置索引,待一轮扫描完成后,只进行一次位置互换。
以下代码演示如何接收用户输入的10个整数,并使用选择排序进行升序排列:
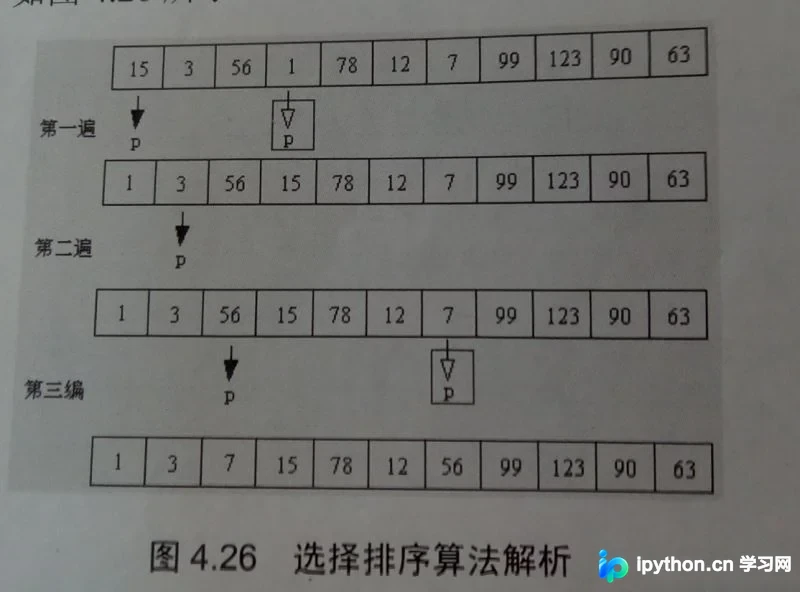
选择排序逻辑流程
#include <stdio.h>

int main() {
    int i, j, k;
    int a[10];

    // 输入环节
    printf("Enter 10 integers:\n");
    for (k = 0; k < 10; k++) {
        scanf("%d", &a[k]);
    }

    // 选择排序核心逻辑
    for (i = 0; i < 9; i++) {          // 外层循环控制需要进行多少轮选择
        for (j = i + 1; j < 10; j++) { // 内层循环遍历未排序部分
            if (a[i] > a[j]) {         // 如果当前指派的值大于后续值
                // 交换数值,确保a[i]为当前未排序部分的最小值
                int temp = a[j];
                a[j] = a[i];
                a[i] = temp;
            }
        }
    }

    // 输出排序结果
    printf("Result: ");
    for (i = 0; i < 10; i++) {
        printf("%d ", a[i]);
    }
    printf("\n");

    return 0;
}
三、冒泡排序与选择排序的区别
虽然这两种算法的时间复杂度均为 O(n²),但在实际运行机制上存在显著差异:
- 比较对象不同: 冒泡排序是比较相邻的两个位置的值;选择排序是按照顺序比较,通常是将当前位置的值与后续所有值进行比较以找出极值。
- 交换频率不同: 冒泡排序在每一轮比较后,只要发现逆序就需要立即交换位置,因此交换次数较多;而选择排序在每一轮扫描中,通常只需要在最后找到最小值后再交换一次位置,交换效率相对较高。
- 查找方式不同: 冒泡排序是通过数值的流动来找最终位置;选择排序是给定一个位置去找适合该位置的数值。
四、优缺点分析与总结
1. 冒泡排序
- 优点: 逻辑简单,易于理解和实现;空间复杂度为
O(1),只需常数级额外空间;且它是一种稳定的排序算法(即相等元素的相对位置不会改变)。 - 缺点: 无论数据是否有序,都需要走完所有轮次(除非使用提前终止优化的版本),平均和最坏情况下的时间复杂度都为
O(n²),在处理大规模数据时效率较低。
2. 选择排序
- 优点: 交换次数少(最多
n-1次),在某些交换成本较高的场景下(如大记录块的交换)可能略优。 - 缺点: 同样具有
O(n²)的时间复杂度,且它是一种不稳定的排序算法。例如序列{5, 8, 5, 2, 9},第一遍选择会将第一个5与2交换,导致原序列中两个5的相对前后顺序发生破坏。
以上就是C语言冒泡排序和选择排序使用的详细内容,更多关于C语言经典算法与基础排序技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









