

Python读取TXT文件的完整步骤与代码实现

本文详解在Python中读取和清洗TXT数据的标准流程,涵盖一次性读取、逐行分割、数值与字符串转换等核心操作。附带完整示例代码,针对常见报错提供路径修正方案,帮助快速实现文本文件的准确解析与格式化输出。
读取目标与准备工作
在实际项目中,通常需要解析外部TXT文本以获取结构化数据。Python将该类文件默认视为纯文本流,所有内容初始读取均为字符串格式。为保证跨平台兼容性,建议统一采用 utf-8 编码打开文件。执行前请确认输入路径存在且具备读取权限,同时备份可能因覆盖操作丢失的输出文件。
数据读取与处理流程
第1步:安全打开文件并获取对象
目的:建立文件读写通道并确保资源自动释放。入口:Python内置文件处理接口。动作:调用 open() 函数配合 with 上下文管理器。参数:传入文件路径字符串与 encoding='utf-8' 编码标识。完成状态:不触发IO异常警告,文件句柄绑定成功,随代码块结束自动关闭,可安全进行后续读取。
第2步:选择数据读取策略
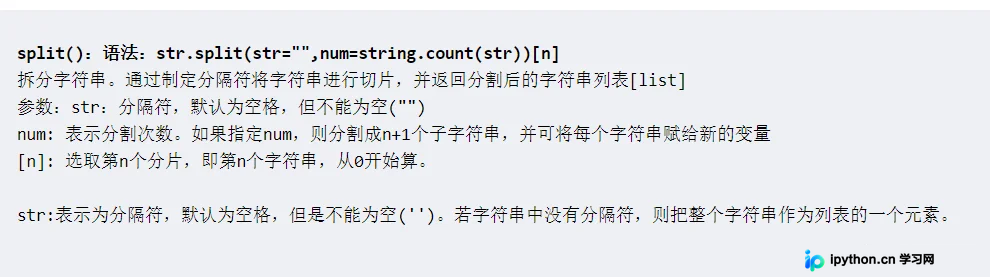
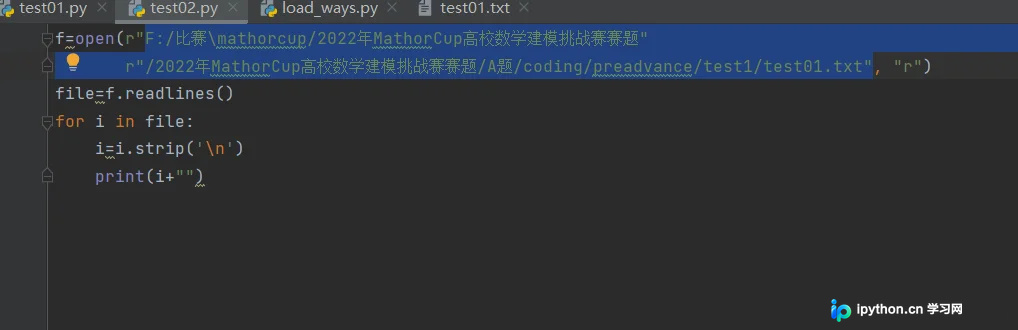
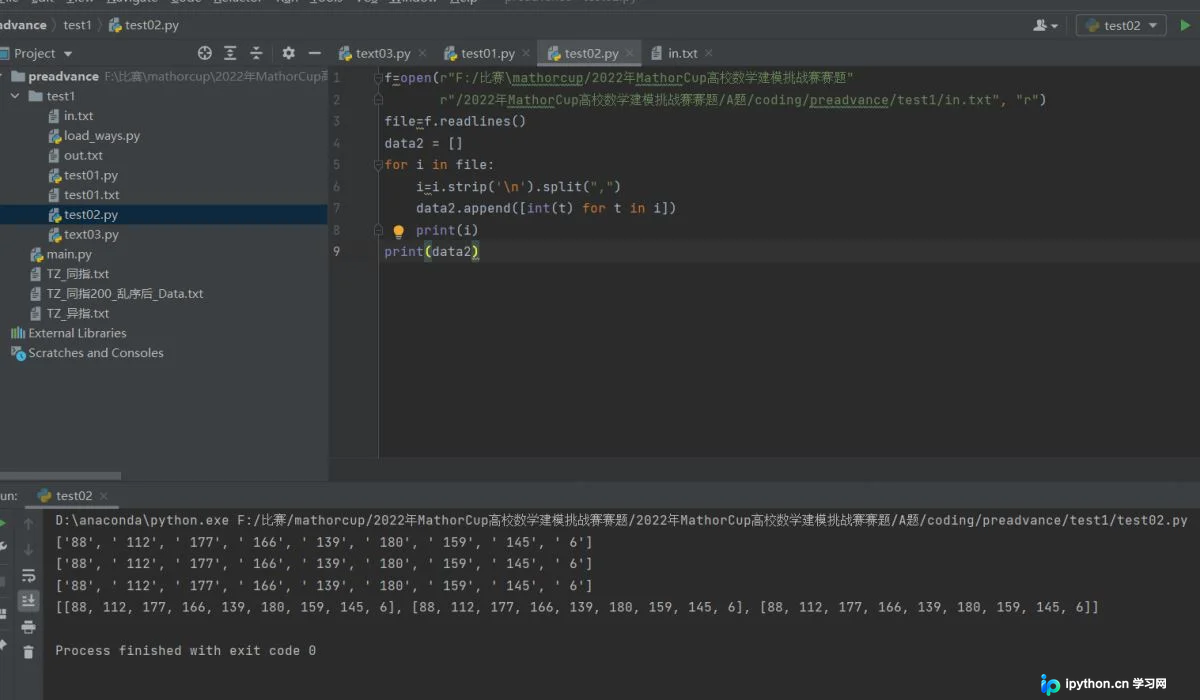
目的:按数据规模与后续计算需求提取结构化内容。入口:已绑定的文件对象。动作:若需整体加载,使用 infile.readlines() 返回完整行列表;若需内存友好型处理,使用 for 循环遍历对象,结合 line.strip("\n").split() 逐行剥离换行符并切分字段;若需精细到单元格级操作,引入双层 for 循环逐层解析。参数:分隔符默认按空白字符切割,换行控制符需显式去除。完成状态:获得规整的二维数组结构,各元素位置与原表行列对齐。
第3步:类型转换与格式清洗
目的:将原始文本转化为可计算数值或统一输出格式。入口:待处理的字符串序列。动作:若文本包含数字但需参与运算,使用 int() 或 float() 进行显式转换;若源文件混入逗号或其他分隔符,可先用系统记事本批量替换为空格,再配合上述切分方法避免切分错位。参数:转换函数需校验源字符是否为合法数字串。完成状态:输出纯数值矩阵或标准化字符串序列,支持无缝导入下游算法或报表。
完整代码实现
以下为整合打开、读取、转换与写入的封装脚本。注意覆盖写入前请确认输出目录权限,避免意外清空重要数据。
def read_txt(inputpath, outputpath):
    # 安全写入模式:覆盖前请确认输出文件非关键资产
    with open(outputpath, 'w', encoding='utf-8') as outfile:
        with open(inputpath, 'r', encoding='utf-8') as infile:
            # 第一种:读取所有行(返回列表形式)
            # data1 = infile.readlines()
            # print(data1)

            # 第二种:逐行分开读取并转为数值列表
            data2 = []
            for line in infile:
                data_line = line.strip("\n").split()  # 去除首尾换行符,并按空格划分
                num_line = [int(i) for i in data_line]
                data2.append(num_line)
            print("数值矩阵:", data2)

            # 第三种:遍历嵌套结构,统一转为字符串格式便于导出
            str_data = [[str(item) for item in row] for row in data2]
            print("格式化字符串:", str_data)

            # 写入方法(以空格分隔输出)
            for line in str_data:
                out_str = ' '.join(line) + '\n'  # 使用空格作为列间隔符
                outfile.write(out_str)

if __name__ == "__main__":
    input_path = '1.txt'
    output_path = '2.txt'
    read_txt(input_path, output_path)
路径配置与常见排错
运行上述脚本时,最常见的问题是文件未找到(FileNotFoundError)。这通常源于相对路径在当前工作目录下定位失败。相对路径依赖脚本执行的当前工作目录,而绝对路径直接从磁盘根节点或项目根目录指定坐标。当遇到报错时,建议将路径改为绝对路径,并注意在不同操作系统下保持 / 或双反斜杠 \\ 的书写规范,以消除歧义。
简要总结
掌握 open() 上下文管理、灵活组合 readlines() 与 strip().split() 切割策略,并严格区分相对与绝对路径引用,即可稳定完成Python读取TXT数据的全部操作。合理预留备份环节与类型转换校验,能有效提升文本解析脚本的鲁棒性。
以上就是Python读取TXT文件的详细操作与代码配置内容,更多关于Python文本处理与数据清洗的实用技巧请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









