


很多人在刚接触 Spring Boot 时,看到 JDBC、连接池、MyBatis 这些组合就会下意识觉得要写一堆 XML 或 Java 配置。实际上,Spring Boot 已经把最麻烦的基础装配放进了 starter 里,开发者真正要关心的,往往只剩依赖引入和少量必要参数。本文就按“连接池怎么来的、参数该怎么写、MyBatis 怎么接、通用 Mapper 怎么用”的顺序,梳理一遍这套集成逻辑,方便你判断哪些配置可以省,哪些不能省。
为什么 Spring Boot 通常不需要手动配置连接池
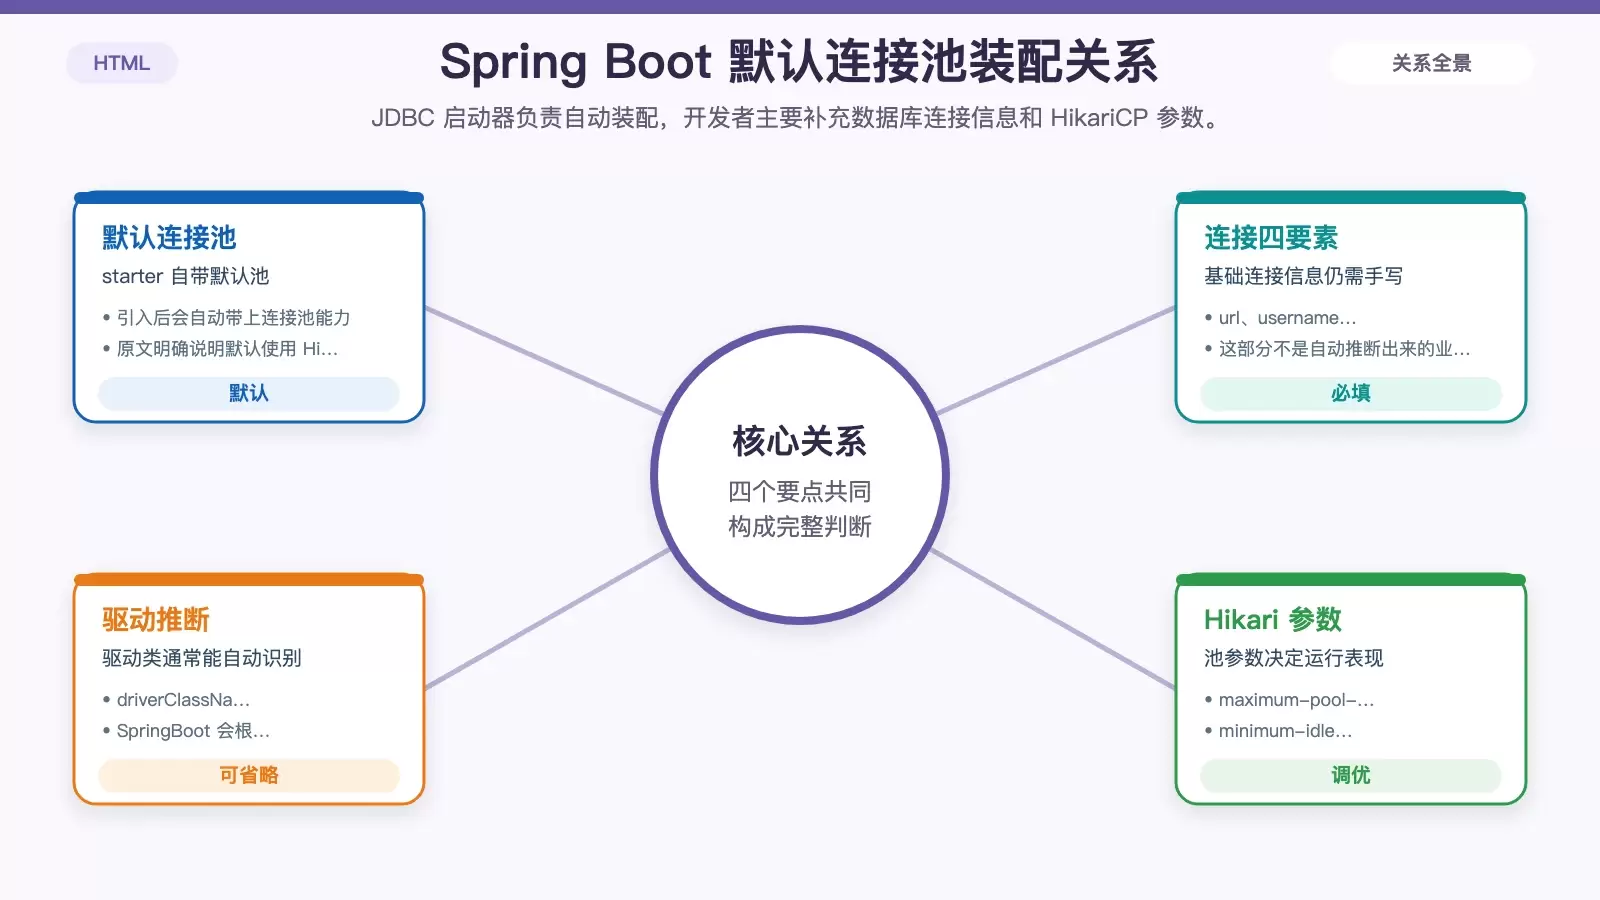
在 Spring Boot 中,JDBC 连接池的关键并不在“自己创建 DataSource Bean”,而在于引入正确的 starter。只要加入 JDBC 启动器,Spring Boot 就会自动完成数据源相关装配,并默认使用 HikariCP 作为连接池。
先看最基础的依赖:
<!--jdbc的启动器,默认使用HikariCP连接池-->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-jdbc</artifactId>
</dependency>
<!--不要忘记数据库驱动,因为springboot不知道我们使用的什么数据库,这里选择mysql-->
<dependency>
    <groupId>mysql</groupId>
    <artifactId>mysql-connector-ja va</artifactId>
</dependency>
这里有两个信息需要分开看:
starter 负责装配,数据库驱动负责连库
spring-boot-starter-jdbc 解决的是 JDBC 与数据源自动配置问题;而 mysql-connector-ja va 则告诉 Spring Boot 你实际要连接的是哪种数据库。少了驱动,Spring Boot 无法判断数据库实现,也就无法真正建立连接。
“不用手动配置”不等于“什么都不用写”
Spring Boot 会自动带上连接池,但数据库地址、账号密码这类连接信息仍然要由你提供。也就是说,省掉的是连接池装配代码,不是业务运行所需的基本参数。
默认 HikariCP 时,通常只需要补这些参数
引入 JDBC 启动器后,接下来最常见的工作就是在配置文件里补齐数据源参数,以及根据项目负载调整 HikariCP 连接池属性。
# 连接四大参数
spring.datasource.url=jdbc:mysql://localhost:3306/[your datasource]
spring.datasource.username=root
spring.datasource.password=root
# 可省略,SpringBoot自动推断
spring.datasource.driverClassName=com.mysql.jdbc.Driver
spring.datasource.hikari.idle-timeout=60000
spring.datasource.hikari.maximum-pool-size=30
spring.datasource.hikari.minimum-idle=10
这段配置可以拆成两部分理解:
必须明确的数据源信息
spring.datasource.url、spring.datasource.username、spring.datasource.password 是实际连库所必需的核心参数。无论是否自动配置,这三项通常都少不了。
连接池参数按需调整
spring.datasource.hikari.idle-timeout=60000、spring.datasource.hikari.maximum-pool-size=30、spring.datasource.hikari.minimum-idle=10 这类配置是 HikariCP 的池化参数,用来控制空闲超时、最大连接数和最小空闲连接数。
其中 spring.datasource.driverClassName=com.mysql.jdbc.Driver 在文中已经说明“可省略,SpringBoot自动推断”,因此如果驱动与 URL 足够明确,Spring Boot 往往能自动识别,不一定需要手写。
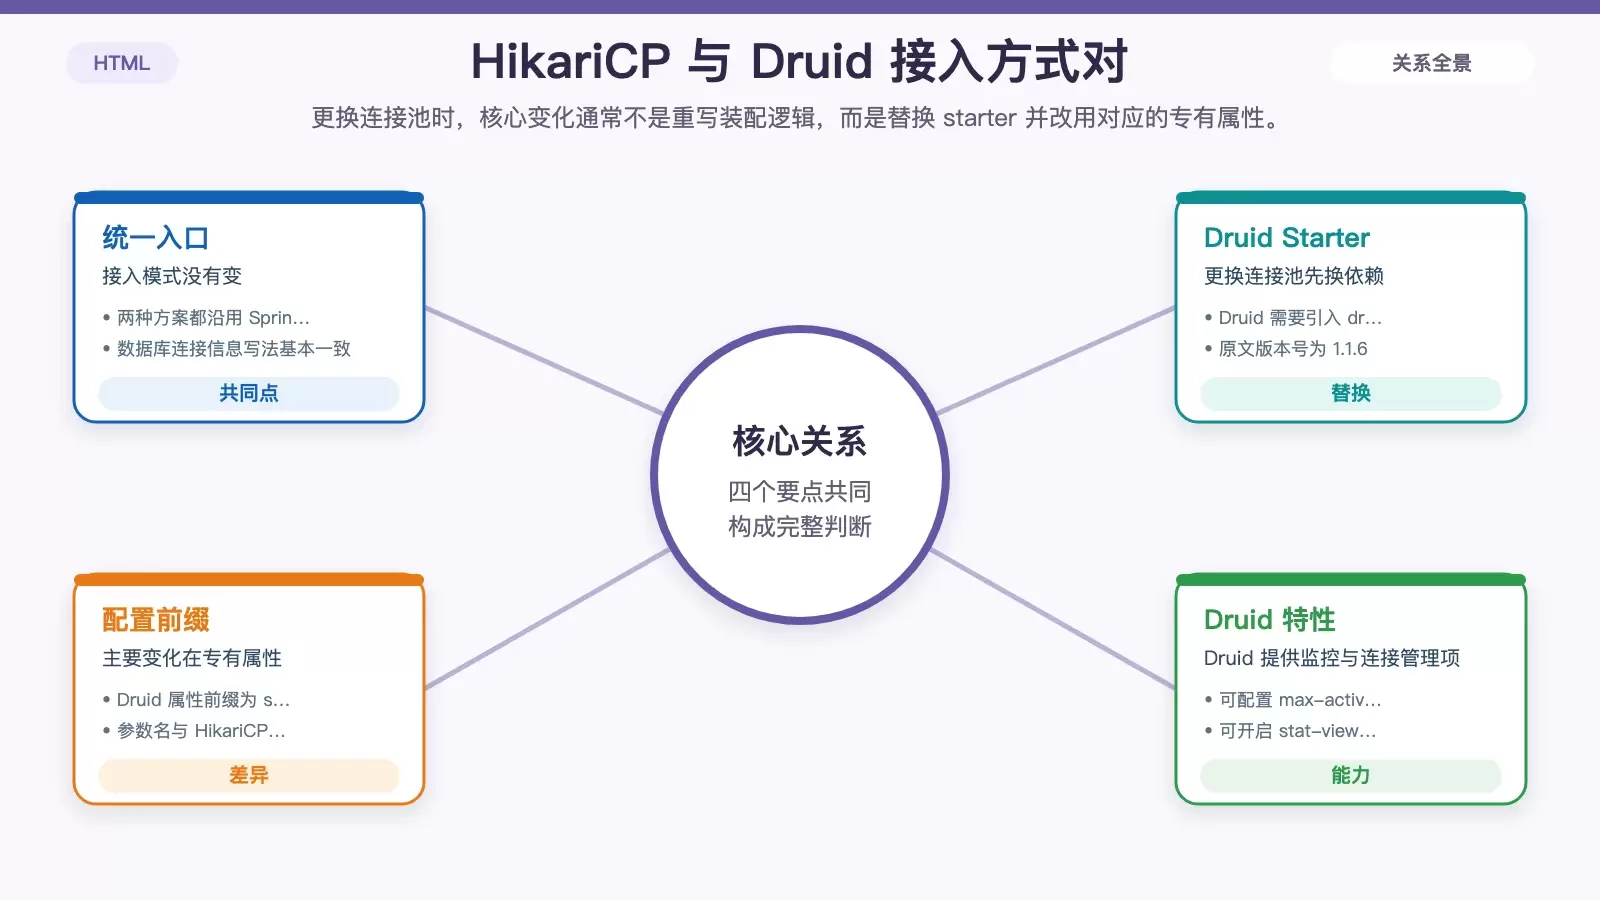
如果要换成 Druid,改的是 starter 和专有参数
如果项目更偏好 Druid,也不需要回到传统 Spring 时代那种手工装配方式。Druid 官方同样提供了自己的 Spring Boot 启动器,思路依然是“引依赖 + 写配置”。
先引入 Druid 的 starter:
<!-- Druid连接池 -->
<dependency>
    <groupId>com.alibaba</groupId>
    <artifactId>druid-spring-boot-starter</artifactId>
    <version>1.1.6</version>
</dependency>
连接信息的写法和前面的数据源配置基本一致,不同之处主要体现在 Druid 自身的属性命名:
#初始化连接数
spring.datasource.druid.initial-size=1
#最小空闲连接
spring.datasource.druid.min-idle=1
#最大活动连接
spring.datasource.druid.max-active=20
#获取连接时测试是否可用
spring.datasource.druid.test-on-borrow=true
#监控页面启动
spring.datasource.druid.stat-view-servlet.allow=true
这说明 Spring Boot 并不是“只支持默认连接池”,而是通过 starter 机制把第三方组件接入方式统一了。你更换连接池时,通常不需要自己重建整套数据源装配逻辑,只要替换依赖,并改写对应厂商的配置前缀即可。
整合 MyBatis 时,重点在 starter 与 Mapper 识别
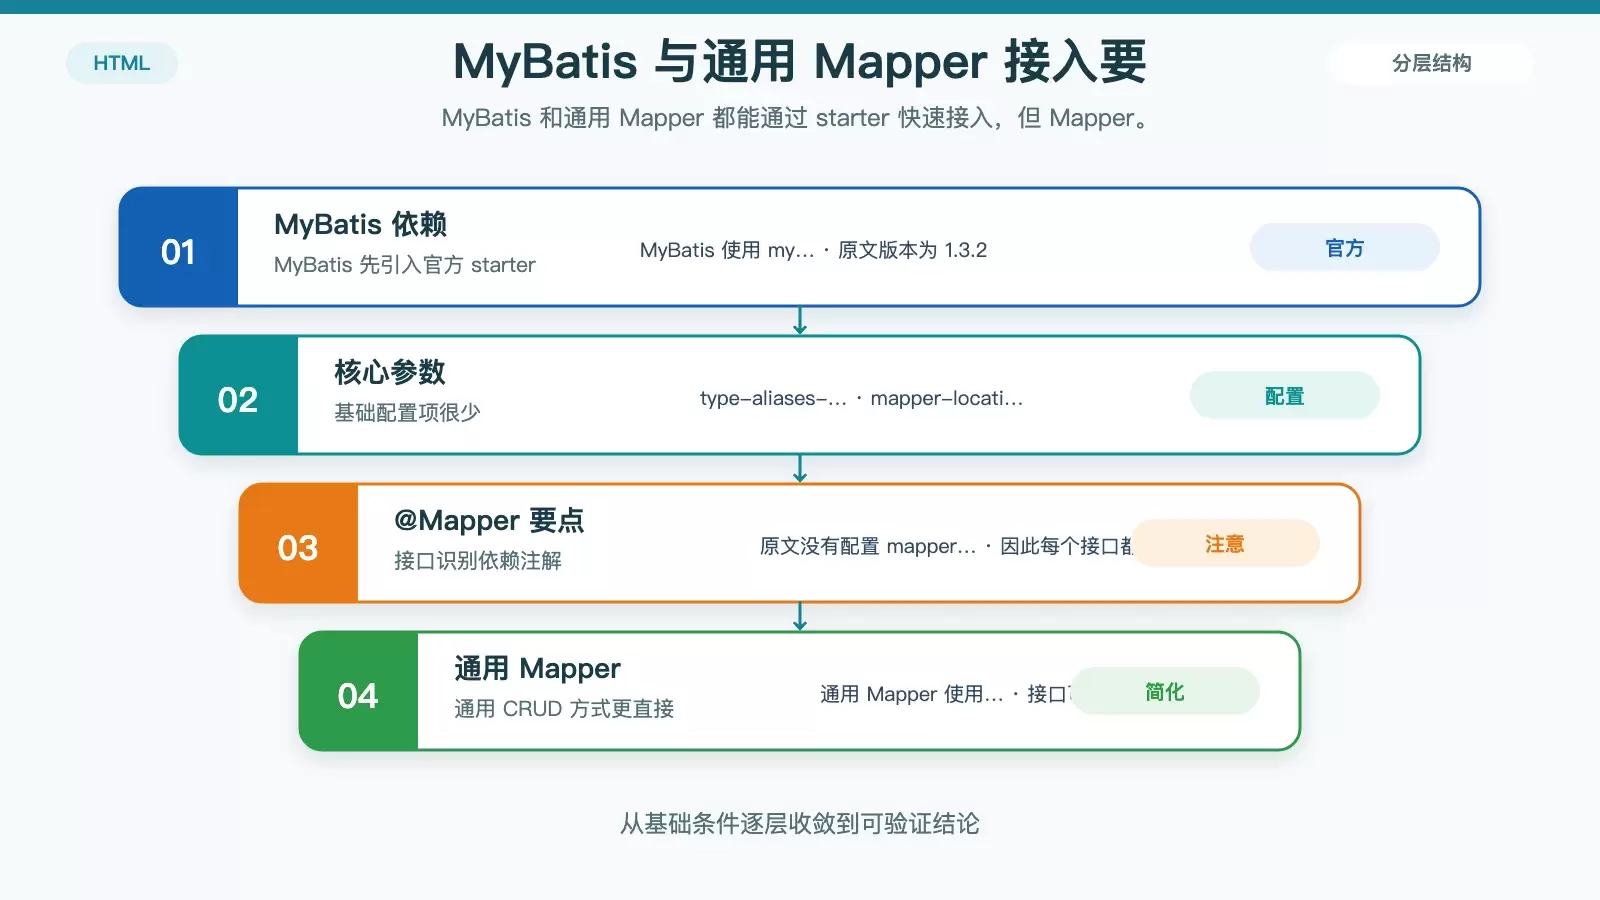
JDBC 数据源准备好之后,接下来通常会进入持久层框架的整合。文中给出的方案是使用 MyBatis 官方提供的 Spring Boot 启动器。
<!--mybatis -->
<dependency>
    <groupId>org.mybatis.spring.boot</groupId>
    <artifactId>mybatis-spring-boot-starter</artifactId>
    <version>1.3.2</version>
</dependency>
基础配置也比较直接:
# mybatis 别名扫描
mybatis.type-aliases-package=[your pojo]
# mapper.xml文件位置,如果没有映射文件,请注释掉
mybatis.mapper-locations=classpath:mappers/*.xml
别名包和 XML 路径按项目结构填写
mybatis.type-aliases-package 用于扫描实体类别名;mybatis.mapper-locations=classpath:mappers/*.xml 用于指定映射文件位置。如果项目没有 XML 映射文件,这一项需要按原文提示注释掉。
这里没有配置接口扫描包,因此要加 @Mapper
原文特别提醒:这里没有配置 mapper 接口的扫描包,所以每个 Mapper 接口都需要显式添加 @Mapper 注解,才能被 Spring 识别。
@Mapper
public interface UserMapper {
}
这也是很多新手在“依赖和配置都写了,但接口注入失败”时最容易漏掉的一步。
通用 Mapper 的接入更直接
如果你使用的是 tk.mybatis 提供的通用 Mapper 方案,接入方式还可以再简化一层。文中给出的做法是直接引入它的 Spring Boot 启动器。
你也可以选择老mybatis的mapper方式,自己写sql
<!-- 通用mapper -->
<dependency>
    <groupId>tk.mybatis</groupId>
    <artifactId>mapper-spring-boot-starter</artifactId>
    <version>2.0.2</version>
</dependency>
原文给出的结论是:不需要做任何配置,直接使用。
@Mapper
public interface UserMapper extends tk.mybatis.mapper.common.Mapper<User>{

    //
}
从使用方式上看,它的核心价值在于把常见的通用 CRUD 能力进一步封装,减少手工编写重复 Mapper 代码的工作量。
文中的完整 pom.xml 示例
下面是原文提供的完整演示 pom.xml,保留原样便于直接对照依赖关系:
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://ma ven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://ma ven.apache.org/POM/4.0.0 http://ma ven.apache.org/xsd/ma ven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>
    <groupId>cn.itcast.user</groupId>
    <artifactId>itcast-user</artifactId>
    <version>1.0-SNAPSHOT</version>
    <parent>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-parent</artifactId>
        <version>2.0.6.RELEASE</version>
    </parent>
    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>
        <!--jdbc的启动器,默认使用HikariCP连接池-->
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-jdbc</artifactId>
        </dependency>
        <!--不要忘记数据库驱动,因为springboot不知道我们使用的什么数据库,这里选择mysql-->
        <dependency>
            <groupId>mysql</groupId>
            <artifactId>mysql-connector-ja va</artifactId>
        </dependency>
        <!--mybatis -->
        <dependency>
            <groupId>org.mybatis.spring.boot</groupId>
            <artifactId>mybatis-spring-boot-starter</artifactId>
            <version>1.3.2</version>
        </dependency>
        <!-- 通用mapper -->
        <dependency>
            <groupId>tk.mybatis</groupId>
            <artifactId>mapper-spring-boot-starter</artifactId>
            <version>2.0.2</version>
        </dependency>
    </dependencies>
</project>
可以把这套集成思路理解为“starter + 少量关键配置”
结合全文,可以把 Spring Boot 整合 JDBC、连接池、MyBatis 和通用 Mapper 的方式概括成一条非常清晰的路径:先引入对应 starter,再补充必要的连接参数和少量框架配置。
真正被简化掉的是复杂的手工装配过程,而不是所有配置项本身。换句话说,Spring Boot 省去的是样板式整合代码,但数据库地址、账号密码、连接池容量、Mapper 识别方式这些与运行结果直接相关的信息,依然需要你明确掌握。









