

C++实现地铁站名汉字频率统计

本文演示如何使用C++编写程序,分析并统计上海等地铁系统中站名里各个汉字的出现频率。主要涉及文件读取、数据去重、字符遍历计数以及结果排序输出的完整流程,帮助读者掌握处理中文文本统计的基础编程逻辑。
问题背景与目标
在日常数据挖掘或文本分析练习中,统计特定语料库中字符的频率是一个常见需求。以上海地铁为例,我们可以收集所有线路的站点名称,通过编程手段找出其中出现次数最多的汉字。这不仅有助于了解命名习惯,也是检验数据处理能力的有效案例。
数据准备与结构定义
我们需要一个包含所有地铁站名的文本文件作为输入源。由于不同线路可能共享部分站点名称,原始数据中往往存在重复项。因此,在统计之前,必须先完成数据的去重工作,确保每个站名仅被计算一次。
首先,定义用于存储站名和统计结果的数据结构。使用全局数组 name 暂存去重后的站名,nPos 记录当前已存入的站名数量;使用结构体数组 strCount 存储出现的汉字及其频次,sPos 记录已发现的独特汉字总数。
#include<iostream>
#include<string>
#include<stdio.h>
#include<string.h>
#include<algorithm>
using namespace std;

string name[15000];
int nPos=0;

struct Count{
	char T[4]; // 存储中文汉字,占位4字节以容纳宽字符
	int times; // 出现次数
	Count(){
		T[0]=T[1]=T[2]=T[3]=0;
	}
}strCount[15000];
int sPos=0;
操作步骤详解
第1步:读取并去重站名数据
目的是将输入文件中的站名清洗为标准集合。程序使用 freopen 将标准输入输出重定向到文件,简化文件流操作。遍历输入字符串,检查是否已存在于数组 name 中,若不存在则追加。
int main(){
	freopen("Name.txt","r",stdin);
	freopen("Calc.txt","w",stdout); // 此处重定向主要用于测试输出验证,实际统计过程可在内存中进行
	//1.排重
	string s;
	while(cin>>s){
		int flag=0;
		for(int i=1;i<=nPos;i++){
			if(name[i]==s)flag=1;
		}
		if(flag==0)name[++nPos]=s;
}注意:上述代码片段主要展示去重逻辑。在实际运行时,建议直接处理内存中的 name 数组,避免过早写入中间文件干扰后续统计逻辑。这里保留 freopen 是为了兼容原草稿的输出重定向习惯,但核心统计应基于内存数组。
第2步:逐字遍历并统计频次
接下来是对去重后的站名列表进行深度解析。由于中文字符在常见的 std::string 实现(如UTF-8)中可能占用多个字节,但在此示例代码逻辑中,假设采用GB2312或GBK编码或简单的双字节字符处理模式(即每两个字符代表一个汉字)。代码通过步长为2的方式遍历字符串,提取每个“汉字”,并在 strCount 数组中进行比对。
如果该汉字已存在,则对应计数器加1;如果不存在,则新增一条记录。这里使用了一个辅助函数 check 来比较两个字符序列是否相等。
// 辅助函数:判断两个双字节字符是否相同
bool check(char *A,char *B){
	if(A[0]==B[0] && A[1]==B[1]) return true;
	return false;
}

// 主循环逻辑嵌入main或其他处理函数中
for(int i=1;i<=nPos;i++){
	for(int j=0;j+1<name[i].size();j+=2){
		char c[3];
		c[0]=name[i].at(j);
		c[1]=name[i].at(j+1);
		c[2]='\0'; // 修正原代码中的笔误,确保字符串正确终止

		int flag=0;
		for(int k=1;k<=sPos;k++){
			if(check(strCount[k].T,c)){ // 这个字已经出现过
				strCount[k].times++;
				flag=1;
			}
		}
		if(flag==0){
			strncpy(strCount[++sPos].T,c,2);
			strCount[sPos].times=1;
		}
	}
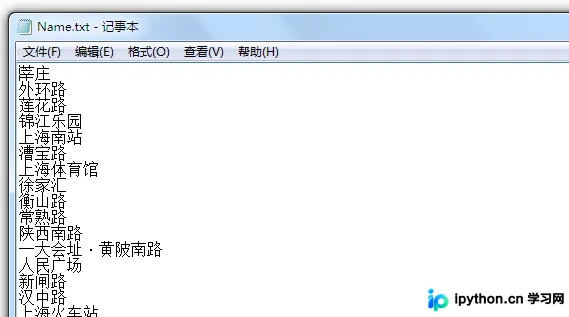
}图片说明:以下是部分原始站名数据的格式示例,可以看到数据按行排列,需程序自动解析。
第3步:排序并输出结果
统计完成后,需要对 strCount 数组按照出现次数 times 进行降序排列。使用 std::sort 配合自定义比较函数 comp,然后输出前50个高频汉字及其次数。
bool comp(Count A,Count B){
	return A.times > B.times; // 降序排列
}

int main(){
	// ... 前置处理代码 ...

	//3.输出信息
	sort(strCount+1,strCount+sPos+1,comp);
	for(int i=1;i<=50;i++){
		cout<<strCount[i].T<<" "<<strCount[i].times<<endl;
	}
	return 0;
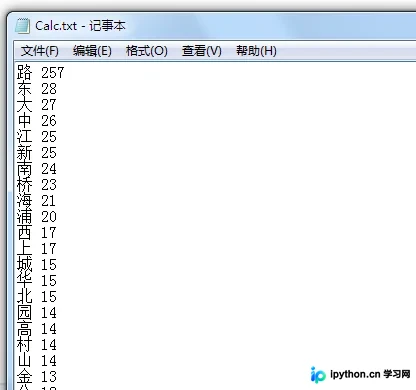
}图片说明:以下为程序运行后输出的部分高频汉字统计结果,展示了最终的计算效果。
注意事项与潜在问题
- 编码兼容性:上述代码假设中文字符由两个字节组成(如GBK/GB2312)。如果使用UTF-8编码,一个汉字可能占3个字节,此时步长应为3,且
check函数的比较逻辑也需相应调整,否则会导致统计错误。 - 性能优化:当前实现使用线性搜索匹配字符,时间复杂度较高(O(N*M*K))。对于大规模数据集,建议使用
std::map<string, int>或哈希表来加速查找和计数过程。 - 资源依赖:原始文章中提供的下载链接可能已失效,建议读者自行构造测试用的
Name.txt文件,内容只需包含若干行地铁站名即可运行验证逻辑。
以上就是利用C++统计地铁站名中汉字出现频率的详细内容,更多关于C++文本分析与数据统计的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









