

Java 数据结构与算法之哈希表:冲突解决策略详解

哈希表是利用 Key-Value 形式高效存储数据的结构,核心在于通过哈希函数建立关键字与数组下标的映射关系。当发生键值冲突时,可采用开放地址法或链地址法进行解决。本文将结合 Java 代码,演示不同冲突解决策略的具体实现。
1. 哈希函数的设计与映射
哈希表旨在像字典一样,通过快速定位实现数据的读写。为了将单词等数据存入内存,我们需要建立一种从“数据内容”到“数组索引”的转换机制。
第1步:构建数字编码
首先,需要将非数值型数据转化为数字。例如将英文字母 a-z 映射为 1-26。对于整个单词,常见思路有两种:
- 累加法:将各字母对应的数字相加。此法简单但范围小,极易产生大量冲突。
- 幂乘连加:如计算 cats 的值时,利用 27 的次幂进行加权求和:
cats = 3*27³ + 1*27² + 20*27¹ + 19*27⁰。这种方式生成的数字具有唯一性,但数值巨大,无法直接作为数组下标。
第2步:压缩至有效范围
为解决上述问题,需要使用取余运算(Modulo)将巨大的数字范围压缩到可接受的数组容量内:
arrayIndex = hashValue % arraySize
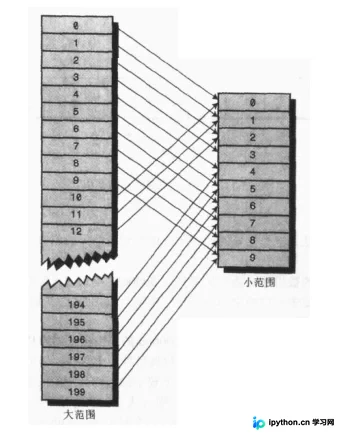
这一过程即为哈希化。通过哈希函数转化后的数组被称为哈希表。
2. 冲突处理:两种核心方案
由于映射范围缩小,不同的关键字可能计算出相同的数组下标,这就是哈希冲突。常见的解决方式包括开放地址法和链地址法。
3. 开放地址法 (Open Addressing)
当目标位置被占用时,在数组中寻找其他空位来存储数据。根据寻找方式的不同,主要分为三种变体。
第3步:线性探测与聚集问题
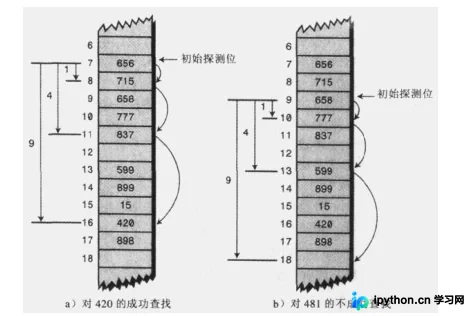
最基础的线性探测是从计算出的下标开始,依次向后查找(x+1, x+2...),直到找到空白单元。该方法实现简单,但在装载因子较高时容易发生“聚集”现象,即连续的被占单元越来越多,导致搜索效率下降。
第4步:二次探测 (Quadratic Probing)
为了避免线性聚集,可以采用跳跃式探测。步长随次数平方增加(x+1², x+2²...)。虽然减少了初始位置的聚集,但容易产生“二次聚集”,即如果多个关键字映射到同一位置,它们的探测序列会完全相同,仍可能引发冲突。
第5步:再哈希法 (Rehashing)
这是消除聚集问题的较优解法。引入第二个哈希函数来计算探测步长,使得不同关键字即使映射到同一位置,也采用不同的探测序列。
- 步长公式:
stepSize = constant - key % constant(constant 需小于数组容量的质数)。 - 注意事项:数组容量应设置为质数,否则可能导致无法遍历所有槽位。
第6步:完整代码实现(再哈希法)
以下代码展示了基于再哈希法的哈希表插入、删除与扩容逻辑:
package com.ys.hash;
public class HashDouble {
    private DataItem[] hashArray;   // 表示每个数据项信息
    private int arraySize;// 数组初始大小
    private int itemNum;// 实际存储项数
    private DataItem nonItem;// 用于标记已删除的数据项
    public HashDouble(){
        this.arraySize = 13;
        hashArray = new DataItem[arraySize];
        nonItem = new DataItem(-1);
    }
    public boolean isFull(){
        return (itemNum == arraySize);
    }
    public void insert(DataItem item){
        if(isFull()) extendHashTable();
        int key = item.getKey();
        int hashVal = hashFunction1(key);
        int stepSize = hashFunction2(key);
        // 使用双哈希解决冲突
        while(hashArray[hashVal] != null && hashArray[hashVal].getKey() != -1){
            hashVal += stepSize;
            hashVal %= arraySize;
        }
        hashArray[hashVal] = item;
        itemNum++;
    }
    /**
     * 扩容并重新哈希化(Rehashing)。
     * 因数组容量改变,必须按新规则重新插入原数据。
     */
    public void extendHashTable(){
        int num = arraySize;
        itemNum = 0;
        arraySize *= 2;
        DataItem[] oldHashArray = hashArray;
        hashArray = new DataItem[arraySize];
        for(int i = 0 ; i < num ; i++){
            insert(oldHashArray[i]);
        }
    }
    public int hashFunction1(int key){
        return key%arraySize;
    }
    public int hashFunction2(int key){
        return 5 - key%5;
    }
    // 查找与删除逻辑此处省略...
    public static class DataItem{
        private int iData;
        public DataItem(int iData){
            this.iData = iData;
        }
        public int getKey(){
            return iData;
        }
    }
}
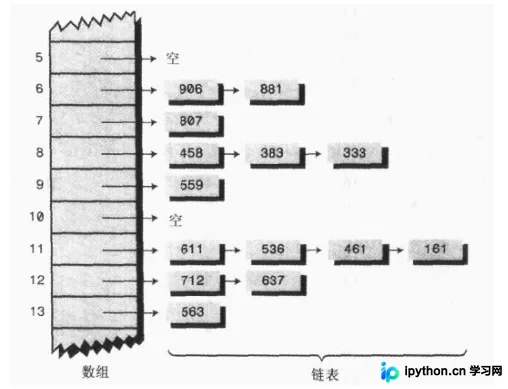
4. 链地址法 (Chaining)
链地址法不再在数组中寻找空位,而是让每个数组单元成为一个链表的头节点。所有映射到同一索引的关键字都挂接在该索引下的链表尾部或头部。
第7步:有序链表辅助类
为了便于插入维护顺序和提高查找效率,可以使用有序链表:
package com.ys.hash;
public class SortLink {
    private LinkNode first;
    public void insert(LinkNode node){
        int key = node.getKey();
        LinkNode previous = null, current = first;
        while(current != null && current.getKey() < key){
            previous = current;
            current = current.next;
        }
        if(previous == null) first = node;
        else previous.next = node;
        node.next = current;
    }
    // 查找与删除操作类似,此处省略...
    class LinkNode{
        private int iData;
        public LinkNode next;
        public LinkNode(int iData){
            this.iData = iData;
        }
    }
}
第8步:完整的链地址法哈希表实现
利用上述链表结构构建哈希表,其时间复杂度取决于链表长度:
package com.ys.hash;
import com.ys.hash.SortLink.LinkNode;
public class HashChain {
    private SortLink[] hashArray;
    private int arraySize;
    public HashChain(int size){
        arraySize = size;
        hashArray = new SortLink[arraySize];
        for(int i = 0 ; i < arraySize ; i++)
            hashArray[i] = new SortLink();
    }
    public void insert(LinkNode node){
        int key = node.getKey();
        int hashVal = hashFunction(key);
        hashArray[hashVal].insert(node); // 直接插入对应链表中
    }
    public LinkNode find(int key){
        int hashVal = hashFunction(key);
        return hashArray[hashVal].find(key);
    }
    public int hashFunction(int key){
        return key%arraySize;
    }
}
在链地址法中,装填因子可以大于 1。当链表较短时,查找速度极快;但当某些位置负载过高形成冗长链表时,性能会退化为 O(N),因此在实际工程中通常会结合红黑树等更平衡的结构优化。
5. 总结
Java 中的哈希表是高效数据存储的核心基石。理解其工作原理不仅能帮我们排查代码中的 Bug,还能在面试和架构设计中展现扎实的基础知识。本文通过剖析哈希函数构建、开放地址法的多种变体以及链地址法的实现细节,展示了如何在实践中应用这些理论。以上就是带你了解 Java 数据结构和算法之哈希表的详细内容,更多关于 Java 算法设计的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









