

C语言输入缓冲区问题详解与解决方案

在C语言开发中,处理键盘输入时常因缓冲区残留数据(如换行符)导致二次读取错误或字符串截断。本文通过实际代码案例,解析scanf的行缓冲原理,提供清除缓存区的多种技巧,并探讨字符数组输入的替代方案。
发现问题:意外的二次输出
许多初学者在使用 scanf 循环读取字符时,会发现自己预期只输入一个字符,但程序却输出了两次结果。例如,在判断字母是否为元音字母的场景中,输入 'o' 后按回车,屏幕上可能同时打印出 "元音字母" 和 "辅音字母"。这种现象并非程序逻辑错误,而是由 C 语言的输入缓冲区机制引起的。
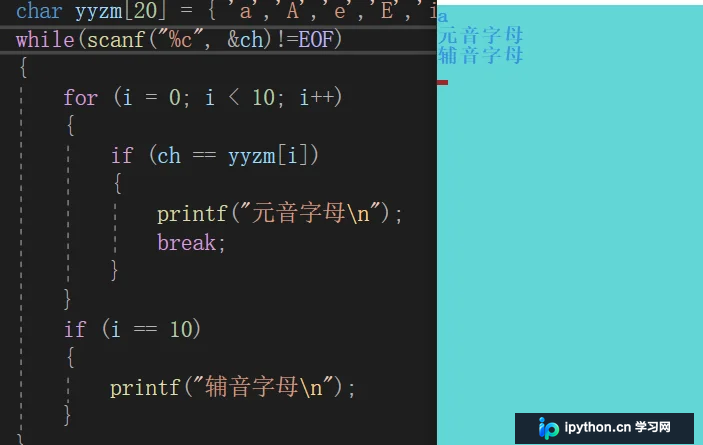
例题与分析
我们需要编写一个程序,判断用户输入的单个字符是元音字母还是辅音字母。常见的错误实现如下:
#include<stdio.h>
int main()
{
	int i = 0;
	char ch = 0;
	// 定义元音字母表
	char yyzm[20] = { 'a','A','e','E','i','I','o','O','u','U' };

	// 循环读取字符直到文件结束
	while(scanf("%c", &ch)!=EOF)
	{
		// 遍历检查是否为元音
		for (i = 0; i < 10; i++)
		{
			if (ch == yyzm[i])
			{
				printf("元音字母\n");
				break;
			}
		}
		// 如果循环正常结束(未break),则是辅音
		if (i == 10)
		{
			printf("辅音字母\n");
		}
	}
	return 0;
}
问题原因:缓冲区的残留
C 语言的标准输入(stdin)默认采用行缓冲。当你通过键盘输入一个字符并按下回车键时,按键事件会被转换为两个字符送入缓冲区:
1. 你输入的字符(例如 'o');
2. 代表回车的换行符 '\n'。
scanf("%c", &ch) 每次只读取缓冲区中的一个字符。
- **第一次循环**:读取到 'o',匹配元音,正确输出。
- **第二次循环**:虽然你还没有敲击键盘,但缓冲区里还有一个刚才遗留的 '\n'。scanf 直接读取了这个 '\n',因为它不是元音字母,所以进入 else 分支,输出了 "辅音字母"。
解决方法
要解决这个多余的回车读取问题,核心思路是在读取下一个有效字符前,先清空或忽略掉缓冲区中的换行符。
第1步:使用 getchar() 消耗换行符
在每次 scanf 之后,立即调用 getchar()。由于 getchar 也是从标准输入读取一个字符,它会刚好吃掉那个多余的 '\n'。
第2步:修改 scanf 格式字符串(推荐)
这是更简洁的做法。在格式串 "%c" 前添加一个空格:scanf(" %c", &ch)。
**原理**:在 scanf 的格式字符串中,空格表示“跳过任意数量的空白字符”(包括空格、制表符、换行符)。这样,scanf 会自动忽略掉上一个输入留下的 \n,继续等待用户输入新的非空白字符。
第3步:显式匹配换行符
也可以在格式串中添加 "\n",即 scanf("%c\n", &ch)。这同样指示 scanf 读取完字符后,再丢弃一个空白字符(通常是回车)。但在某些特定交互场景下," %c" 比 "%c\n" 表现更为稳定。
修正后的完整代码如下:
#include<stdio.h>
int main()
{
	int i = 0;
	char ch = 0;
	char yyzm[20] = { 'a','A','e','E','i','I','o','O','u','U' };

	// 注意 %c 前面的空格,用于自动跳过之前的换行符
	while(scanf(" %c", &ch) != EOF)
	{
		for (i = 0; i < 10; i++)
		{
			if (ch == yyzm[i])
			{
				printf("元音字母\n");
				break;
			}
		}
		if (i == 10)
		{
			printf("辅音字母\n");
		}
	}
	return 0;
}
进阶:字符串输入时的空格问题
当输入包含空格的字符串时,scanf("%s") 也会遇到麻烦。因为 %s 遇空格(Space)、制表符(Tab)或换行符(Newline)就会停止读取。如果你希望读取整行包含空格的句子,需要考虑其他方案。
传统方案:gets 函数及其隐患
历史上,gets() 是一个常被提及的替代方案。它的优点是只要没碰到换行符,它就能读取所有字符(包括中间的空格)。
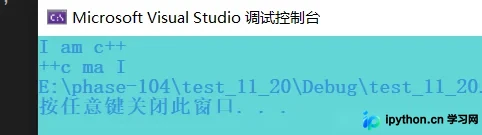
// 逆序字符串示例(仅作演示说明)
#include<stdio.h>
#include<string.h>
void reverse_string(char* str) {
    int len = strlen(str);
    for (int i = 0; i < len / 2; i++) {
        char tmp = str[i];
        str[i] = str[len - 1 - i];
        str[len - 1 - i] = tmp;
    }
}
int main() {
    char str[100];
    // 历史用法,存在风险
    gets(str);
    reverse_string(str);
    printf("%s\n", str);
    return 0;
}
现代C语言的建议
需要特别注意,由于 gets()删除。在实际工程开发和现代 C 语言教学中,应避免使用它。
替代建议:
推荐使用 fgets(buffer, size, stdin)。它能指定最大读取长度,并在末尾自动加入 '\0',安全性远高于 gets。需要注意的是,fgets 会将最后的换行符也读入缓冲区,使用时需手动处理结尾的 '\n'。
为什么要引入缓冲区?
理解缓冲区的必要性,有助于从根本上理解 I/O 操作的行为。缓冲区(Buffer)位于低速设备(如磁盘、键盘、网络)与高速 CPU 之间,起到缓存数据的作用。
- 性能提升: 减少磁盘读写次数。CPU 直接从内存中的缓冲区取数据,速度远快于访问物理磁盘。
- 协调速度差异: 打印机速度慢,数据可先存入打印机缓冲区,CPU 发送后即可去处理其他任务。
缓冲区的三种类型
在 C 语言标准库(stdio.h)中,缓冲区分为以下三类:
- 全缓冲(Full Buffering): 只有填满缓冲区后才进行实际 I/O。典型代表是对普通磁盘文件的读写。这种方式效率最高,减少了系统调用次数。
- 行缓冲(Line Buffering): 当输入/输出遇到换行符(\n)时才执行真正的 I/O。典型代表是标准输入(stdin)和标准输出(stdout)。这就是为什么我们在终端输入一行并按回车后,内容才会被传递给程序或显示出来。
- 不带缓冲(Unbuffered): 不进行缓冲,数据立刻输入/输出。典型代表是标准错误(stderr)。这使得错误信息可以立即显示,无需等待缓冲区满。
总结
C 语言中的缓冲区问题主要源于标准输入的行缓冲机制。在使用 scanf("%c") 时,务必处理遗留的换行符(可通过 " %c" 或 getchar() 解决);在处理包含空格的长文本时,应避免使用过时的 gets 函数,转而使用安全的 fgets 或手动实现的字符读取逻辑。以上就是对C语言输入缓冲区问题的详细内容,更多关于C语言基础优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









