

C# Bitmap图像处理加速:BitmapData与GPU CUDA优化

C#中使用Bitmap.GetPixel/SetPixel处理图像速度慢,推荐使用BitmapData类直接操作内存指针以显著提升性能。对于更高要求的场景,可结合CUDA进行GPU加速。本文通过灰度处理案例,对比传统方法、BitmapData及GPU加速的耗时差异,提供具体的代码实现与性能数据。
为什么BitmapData效率更高
在C#中进行位图(Bitmap)像素点遍历时,System.Drawing.Bitmap自带的GetPixel和SetPixel方法虽然易用,但内部涉及大量的安全检查与方法调用开销,导致其执行效率极低。相比之下,BitmapData类允许通过指针直接读写图像的底层内存数据,避开了逐像素的方法调用开销,因此在处理大规模图像数据时速度有数量级的提升。
方案一:使用BitmapData锁定内存区
目的:通过锁定Bitmap内存区域,获取像素数据的起始地址,直接在CPU内存缓冲区中进行计算,避免频繁调用SetPixel。
第1步:锁定Bitmap并获取内存指针
使用LockBits方法将指定区域的像素数据锁定到内存中,模式设为读写(ReadWrite),格式通常选择24位RGB(Format24bppRgb)以减少复杂度。
private void Gray_BitmapData()
{
    int width = bitmap.Width;
    int height = bitmap.Height;

    // 锁定整个图片区域的内存
    Rectangle rect = new Rectangle(0, 0, width, height);
    PixelFormat format = PixelFormat.Format24bppRgb;
    BitmapData bitmapData = bitmap.LockBits(rect, ImageLockMode.ReadWrite, format);

    // 计算总字节数:宽度 x 高度 x 每像素字节数(24bit=3Bytes)
    int stride = bitmapData.Stride; // 注意:Stride可能包含行填充(padding),需根据实际格式处理
    // 为简化演示,假设无padding或使用标准24bppRgb连续内存
    int size = width * height * 3;

    byte[] srcArray = new byte[size];
    IntPtr ptr = bitmapData.Scan0;

    // 将内存中的数据复制到托管数组
    Marshal.Copy(ptr, srcArray, 0, size);
第2步:在内存缓冲区中计算灰度值
遍历缓冲区数组,计算每个像素的灰度值并写回。这里采用简单平均法:Gray = (R+G+B)/3。需注意像素在内存中的存储顺序通常为BGR,且每行可能存在字节对齐导致的Padding,生产环境中建议使用stride属性进行行定位。
    int p;
    for (int i = 0; i < width; i++)
    {
        for (int j = 0; j < height; j++)
        {
            // 定位当前像素在数组中的起始索引 (BGR)
            p = j * width * 3 + i * 3;

            // 计算灰度值
            byte color = (byte)((srcArray[p] + srcArray[p + 1] + srcArray[p + 2]) / 3);

            // 写回 B, G, R (均设为灰度值)
            srcArray[p] = color;     // Blue
            srcArray[p + 1] = color; // Green
            srcArray[p + 2] = color; // Red
        }
    }
第3步:更新Bitmap并解锁
将修改后的内存数据复制回Bitmap锁定的内存区,并立即解锁以释放资源。
    // 将缓冲区数据写回Bitmap内存
    Marshal.Copy(srcArray, 0, ptr, size);

    // 解锁Bitmap
    bitmap.UnlockBits(bitmapData);
}
耗时测试
为了直观对比,以下代码使用Stopwatch分别记录传统方法与BitmapData方法的耗时。
private void TestPerformance()
{
    Stopwatch watch = new Stopwatch();

    // 测试 BitmapData 方法
    watch.Start();
    Gray_BitmapData();
    watch.Stop();
    double timeBitmapData = watch.Elapsed.TotalMilliseconds;

    // 测试 传统 SetPixel 方法
    watch.Reset();
    watch.Start();
    Gray_Tradition();
    watch.Stop();
    double timeTradition = watch.Elapsed.TotalMilliseconds;

    MessageBox.Show($"BitmapData: {timeBitmapData:F2} ms\nTradition: {timeTradition:F2} ms");
}
根据测试图片结果:
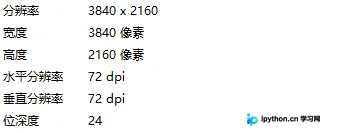
图片信息显示测试环境配置。
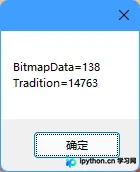
耗时数据显示,传统SetPixel方法耗时长达14秒左右,而BitmapData方法仅需0.1秒左右。这表明直接使用内存指针处理,效率提升了约100倍以上。
方案二:利用CUDA进行GPU加速
当对图像处理速度有极致要求时,可以利用NVIDIA CUDA技术在GPU上并行处理图像像素。这需要编写C/C++内核编译为DLL,并在C#中通过P/Invoke调用。
第1步:编写CUDA Kernel并生成DLL
创建CUDA C++项目,实现灰度转换的内核函数。该函数直接在显存中操作数据,无需在主机和设备间频繁搬运中间状态。
#include "cuda_runtime.h"
#include "device_launch_parameters.h"
#include <stdio.h>
#include <Windows.h>

// CUDA Kernel: 线程索引对应像素索引
__global__ void DoInKernel(byte* o, int num)
{
    int i = blockIdx.x * blockDim.x + threadIdx.x;
    if (i >= num) return;

    // 每个像素占3个字节 (BGR)
    byte* ori = o + i * 3;
    // 计算灰度并回填
    ori[0] = ori[1] = ori[2] = (ori[0] + ori[1] + ori[2]) / 3;
}

// 导出函数供C#调用
extern "C" __declspec(dllexport) void Gray(byte * oriArray, int num) {
    int size = num * 3 * sizeof(byte);
    byte* dev_ori;

    // 1. 在GPU显存分配内存
    cudaMalloc((void**)&dev_ori, size);

    // 2. 将主机内存数据复制到显存
    cudaMemcpy(dev_ori, oriArray, size, cudaMemcpyHostToDevice);

    // 3. 配置启动参数并执行内核 (示例中固定线程块大小1024)
    dim3 blockSize(1024);
    dim3 gridSize((num + blockSize.x - 1) / blockSize.x);
    DoInKernel<<<gridSize, blockSize >>> (dev_ori, num);

    // 4. 等待GPU完成并将结果从显存复制回主机内存
    cudaMemcpy(oriArray, dev_ori, size, cudaMemcpyDeviceToHost);

    // 5. 释放显存
    cudaFree(dev_ori);
}
第2步:在C#中声明并调用DLL
使用DllImport导入外部函数,并在业务逻辑中替换为GPU调用。
[DllImport("CUDA.dll", EntryPoint = "Gray", CallingConvention = CallingConvention.Cdecl)]
public static extern void Gray(IntPtr ori, int num);
调用时的主体流程与传统方式类似,只需锁定内存获取指针后直接传入DLL即可。
private void Gray_GPU()
{
    int width = bitmap.Width;
    int height = bitmap.Height;

    Rectangle rect = new Rectangle(0, 0, width, height);
    BitmapData bitmapData = bitmap.LockBits(rect, ImageLockMode.ReadWrite, PixelFormat.Format24bppRgb);

    IntPtr ptr = bitmapData.Scan0;
    int pixelCount = width * height;

    // 直接调用CUDA DLL,数据已在LockBits后的内存中
    Gray(ptr, pixelCount);

    bitmap.UnlockBits(bitmapData);
    pictureBox1.Refresh();
}
第3步:GPU加速耗时对比
由于加载DLL和初始化CUDA上下文需要一定的时间,首次执行包含预热成本。真正的GPU计算时间体现在后续的执行或扣除初始化开销后。
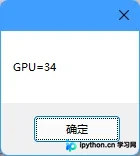
数据显示,在使用GPU加速后,纯处理时间仅约为34毫秒。相比于传统的14秒和CPU内存优化的0.1秒,GPU方案在超大规模图像或多帧实时处理中具有显著优势,尽管其前期配置和调用复杂度较高。
总结与建议
- 一般应用场景:若只是常规的图片灰度化、色彩调整等,优先使用
BitmapData配合指针操作。它无需额外的依赖库,代码相对简洁,性能已远超SetPixel。 - 高性能/实时场景:若涉及视频流处理、大规模批量渲染或对延迟极度敏感,建议引入CUDA/GPU加速。虽然需要维护C++/CUDA工程并管理DLL依赖,但其并行处理能力能带来质的飞跃。
- 注意事项:在使用
LockBits时,务必注意Stride属性。对于非24位的像素格式或存在行对齐填充的情况,直接按Width * Height计算索引可能导致越界或图像错位,生产环境应基于Stride进行正确的行偏移计算。
以上就是C# Bitmap图像处理加速的实现详细内容,更多关于C# Bitmap图像处理加速的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









