

C语言栈的两种实现:顺序栈与链式栈详解

本文将深入解析C语言中栈数据的两种主要实现方式:基于数组的顺序栈和基于指针的链式栈。文章将逐一展示从结构体定义到核心功能函数(进栈、出栈、判断空栈)的完整代码实现,并通过实际运行输出直观呈现数据流动过程,帮助读者掌握不同场景下的栈设计思路。
一、顺序栈的实现原理
顺序栈是利用一段连续的存储空间来存储栈元素,通常使用数组来实现。其核心在于维护一个栈顶指针 top,用于指示当前栈顶元素的位置。当栈为空时,top 通常初始化为 -1;入栈时先移动指针再存入数据,出栈时先取出数据再移动指针。
以下是顺序栈的完整实现代码,包含初始化、判空、进栈和出栈功能:
#include<stdio.h>
#include<stdlib.h>
#define maxsize 64

// 定义栈结构体
typedef struct
{
	int data[maxsize]; // 固定大小的数组存储数据
	int top;           // 栈顶指针
} sqstack, *sqslink;

// 初始化栈(设置为空)
void Clearstack(sqslink s)
{
	s->top = -1;
}

// 判断栈是否为空
int Emptystack(sqslink s)
{
	if (s->top < 0)
		return 1; // 空栈返回1
	else
		return 0; // 非空栈返回0
}

// 进栈操作
int Push(sqslink s, int x)
{
	// 检查栈是否已满
	if (s->top >= maxsize - 1)
		return 0; // 满栈,入栈失败
	else
	{
		s->top++;               // 栈顶指针上移
		s->data[s->top] = x;    // 存入数据
		return 1;               // 入栈成功
	}
}

// 出栈操作
int Popstack(sqslink s)
{
	int n;
	// 检查栈是否为空
	if (Emptystack(s) > 0)
		return NULL; // 空栈无法出栈
	else
	{
		n = s->data[s->top]; // 保存栈顶数据
		s->top--;             // 栈顶指针下移
		return n;             // 返回出栈数据
	}
}

void main()
{
	sqslink s1;
	// 动态分配内存
	s1 = (sqslink)malloc(sizeof(sqstack));
	Clearstack(s1); // 初始化

	printf("%d\n", s1->top); // 输出初始top值,应为-1

	// 循环进栈测试
	for(int i = 0; i <= 10; i++)
	{
		Push(s1, i);
		printf("%d is pushed into stack\n", i);
	}

	printf("top is point to %d\n", s1->top); // 当前栈顶位置
	printf("\n");

	// 执行一次出栈
	int n = Popstack(s1);
	printf("number %d is poped\n", n);
	printf("top is point to %d\n", s1->top); // 出栈后top位置变化
}
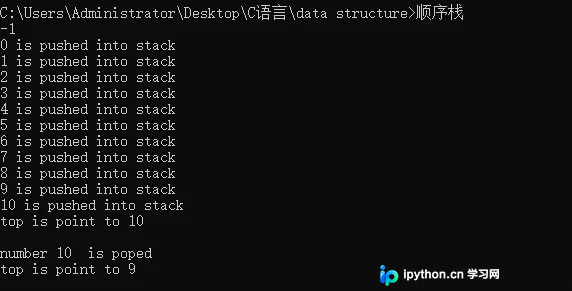
在顺序栈的实现中,需要注意数组容量的限制。虽然访问速度极快,但在栈满时需要预先扩容或无法继续插入,这是其主要的局限性。上述代码演示了从空栈开始,依次压入0到10十个数字,然后弹出一个数字的过程,通过观察 top 指针的变化可以清晰理解栈的“后进先出”特性。
二、链式栈的实现机制
链式栈采用链表结构存储数据,每个节点包含数据和指向下一个节点的指针。这种结构不需要预定义最大容量,内存分配更加灵活,适合元素数量不确定或频繁变动的场景。在链式栈中,通常将链表的头节点作为栈顶,这样入栈和出栈操作都只需要修改头部指针,时间复杂度为 O(1)。
以下是链式栈的完整代码实现,重点展示了如何通过指针操作维护栈的结构:
#include<stdio.h>
#include<stdlib.h>

// 定义节点结构体
typedef struct node
{
	int data;
	struct node *next;
} snode, *slink;

// 用于封装出栈结果的结构体,同时返回新栈顶和被弹出的节点
struct Node
{
	slink i; // 新的栈顶指针
	slink n; // 被弹出的旧节点
};

// 清空栈(简化处理,仅重置指针,实际应用中需遍历释放内存)
void Clearstack(slink top)
{
	top = NULL;
}

// 判断栈是否为空
int Emptystack(slink top)
{
	if (top == NULL) return 1;
	else return 0;
}

// 进栈操作
slink Push(slink top, int x)
{
	slink node = NULL;
	node = (slink)malloc(sizeof(snode));
	node->data = x;
	node->next = top; // 新节点指向原来的栈顶
	top = node;       // 更新栈顶为新节点
	printf("*************************\n");
	printf("%d", top->data);
	printf("*************************\n");
	return top; // 返回新的栈顶指针
}

// 出栈操作
struct Node Pop(slink top)
{
	slink node = NULL;
	struct Node result;

	if (Emptystack(top))
	{
		result.i = node; // 空栈处理
	}
	else
	{
		int n;
		node = top;          // 记录当前栈顶
		top = node->next;    // 栈顶移动到下一节点
		result.i = top;      // 记录新的栈顶
		result.n = node;     // 记录被弹出的节点
		return result;       // 返回包含新旧栈顶和弹出节点的结果
	}
}

void main()
{
	slink top_ = NULL;

	// 循环进栈
	for(int i = 0; i < 10; i++)
	{
		top_ = Push(top_, i);
		printf("%d is pushed in to the stack\n", i);
	}

	int e;
	e = top_->data; // 查看当前栈顶数据
	printf("top is pointint to %d\n", e);
	printf("\n");

	// 执行出栈
	slink node = NULL;
	printf("*************************\n");
	struct Node result = Pop(top_);

	if ((result.i) != NULL)
	{
		top_ = result.i;   // 更新外部栈顶指针
		node = result.n;   // 获取被弹出的节点

		e = top_->data;     // 查看新栈顶
		printf("top is pointint to %d\n", e);

		int e_node;
		e_node = node->data; // 查看被弹出节点的数据
		printf("the node Poped 's data is pointint to %d\n", e_node);
		free(node);          // 释放内存,防止泄漏
	}
	else
	{
		printf("stack is empty");
	}
}
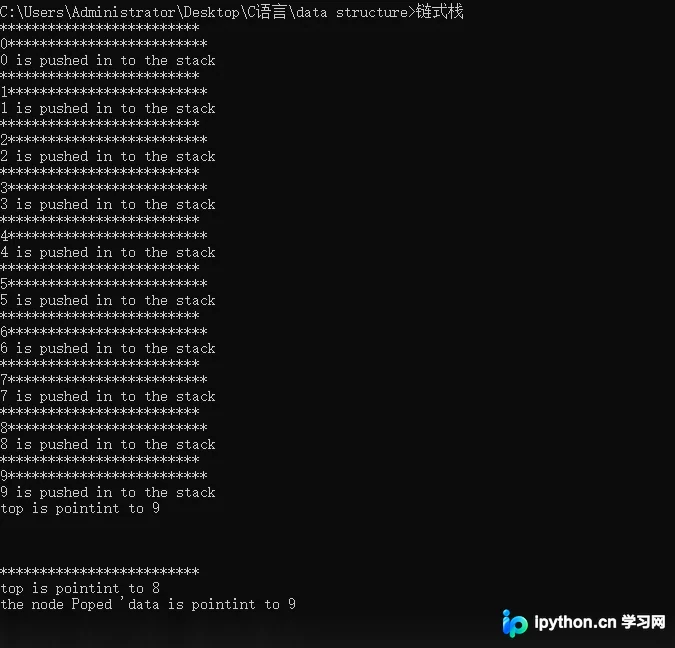
链式栈的代码逻辑相比顺序栈稍显复杂,主要体现在指针的传递和内存的管理上。在 Push 函数中,我们创建新节点并将其 next 指向原栈顶,从而实现“先进后出”的逻辑结构。在 Pop 函数中,为了正确处理内存,函数返回了一个包含新栈顶指针和被弹出节点的结构体。调用者拿到被弹出的节点指针后,必须手动 free 以释放内存,否则会导致内存泄漏。
三、总结与对比
通过上述两种实现的详细对比,我们可以得出以下结论:
- 空间管理:顺序栈预先分配固定大小内存,使用效率高但可能浪费或溢出;链式栈按需分配,无容量上限但存在指针开销和管理成本。
- 操作效率:两者在基本的进栈和出栈操作上时间复杂度均为 O(1),性能相当。
- 适用场景:若数据规模已知且相对稳定,顺序栈更简单直接;若数据规模动态变化较大,链式栈更具优势。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









