

在Python中实现本地文本词频统计的两种方法详解

本文详细介绍如何使用Python对本地文本文档进行词频统计。通过“双列表结合zip”与“字典键值映射”两种方法演示了从文本读取、清洗到计数的全过程。掌握这两种基础算法,能够灵活处理日常数据处理任务,帮助开发者快速生成单词频率清单。
Python本地文本词频统计原理
在数据分析或自然语言处理的基础场景中,词频统计是最常见的操作之一。其核心逻辑是将连续的非结构化文本拆解为独立的单词单元,随后遍历这些单元以计算特定字符串的出现频次。本文将针对本地文本文件(TXT),展示两种经典的Python实现方式:一是利用原生列表与集合特性手动遍历计数,二是利用哈希数据结构(字典)进行映射累加。这两种思路不仅能解决基础的计数需求,也是理解Python内置数据结构的高效切入点。
配置环境与准备输入文件
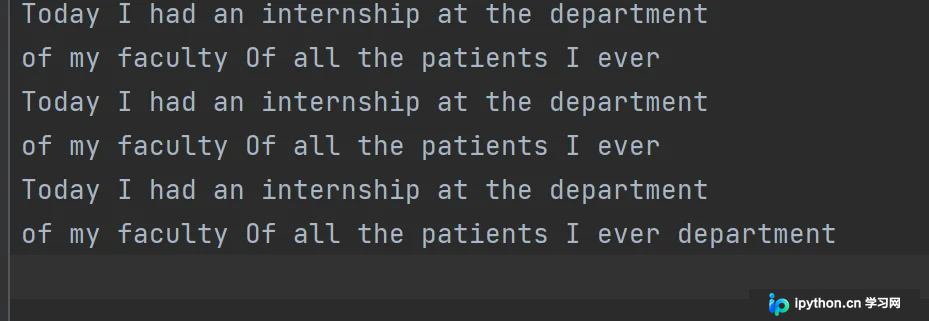
在进行代码编写之前,需要准备一个待分析的文本源。该文件的格式要求较为宽松,默认将每行内由空格分隔的独立字符串视作一个有效的“单词”实体进行处理,换行符将在代码解析阶段被剔除。
策略一:基于双列表与 Zip 函数的传统统计
第1步:读取原始文件并完成清洗工作
首先需要通过上下文管理器打开指定路径的文件,按行获取所有内容。接着初始化一个空白列表用于存储拆分后的单词片段。在此过程中,应当主动清除每行末尾的换行符 \n,并使用切片切分出独立的单词序列。
# 读取本地 txt 文件
with open("passage.txt", 'r', encoding='utf-8') as file:
    lines = file.readlines()

words = []
for line in lines:
    # 去除换行符并按空格切分,合并至总列表
    words += line.replace("\n", "").split(" ")
第2步:执行去重运算并进行频次累加
由于需要知道每个单词具体出现了几次,第一步必须将所有重复的项过滤掉以得到唯一的词汇表(Unique Words)。利用 Python 原生 set 类型自动排异的能力可迅速完成此步骤。随后创建第二张列表(Counts List),采用双重嵌套循环的逻辑:外层遍历唯一词汇表,内层遍历全量单词表,每当二者相等时计数器自增,最终将结果推入第二列表。
# 利用 set 集合自动去重,获取不重复的词表
unique_words = list(set(words))
counts = []

# 双重循环逐一比对频率
for target_word in unique_words:
    freq = 0
    for current_word in words:
        if target_word == current_word:
            freq += 1
    counts.append(freq)
第3步:组合双列表并生成最终清单
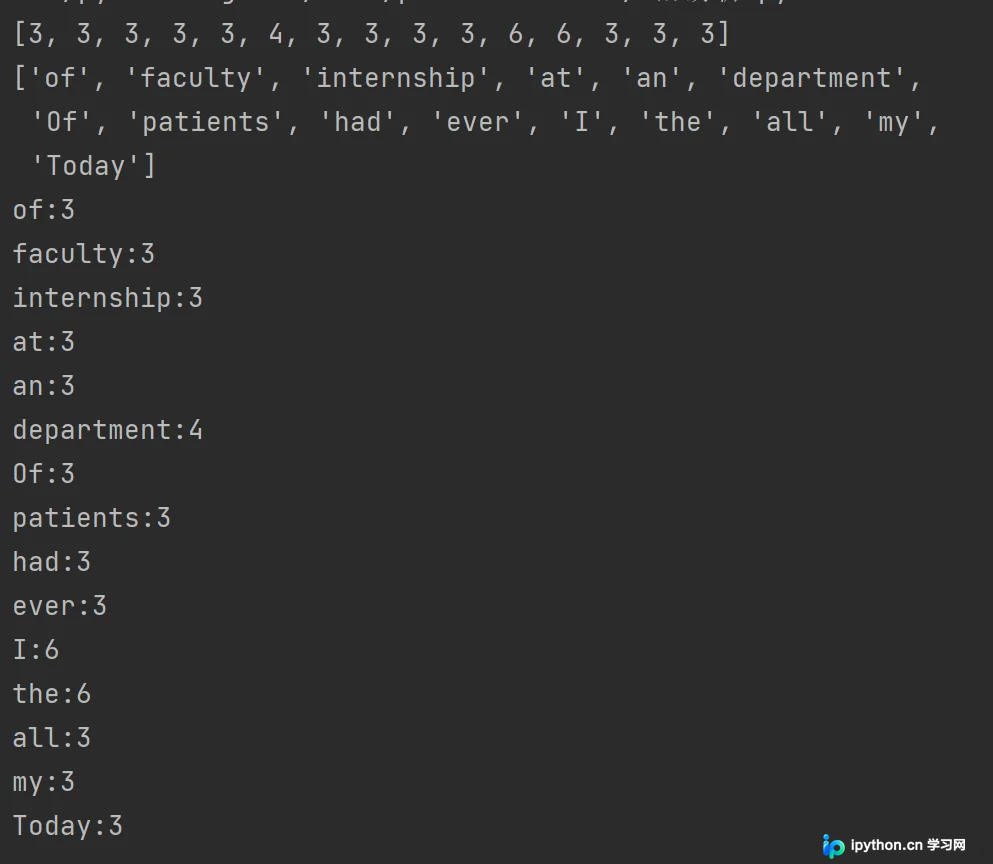
此时我们拥有了两张平级关系的一维数组:单词表与对应的数字表。调用 zip() 内置函数可以将这两张表按索引位置打包压缩为一个迭代器对象。通过解包操作即可直观地打印出配对好的统计数据。
# 将单词与其频率拼接显示
for w, c in zip(unique_words, counts):
    print(f"{w}:{c}")
该方案在处理逻辑上非常接近人类手算思维,便于初学者建立基础的数据处理认知框架。
策略二:依托哈希表(字典)提升计算效率
当面对动辄数十万词的语料库时,双重循环带来的 O(n*m) 级别的时间开销会显著拖慢程序响应速度。利用 Python 字典(Dictionary)作为关联容器,可以实现单次遍历完成全部统计工作。
操作入口与参数设置
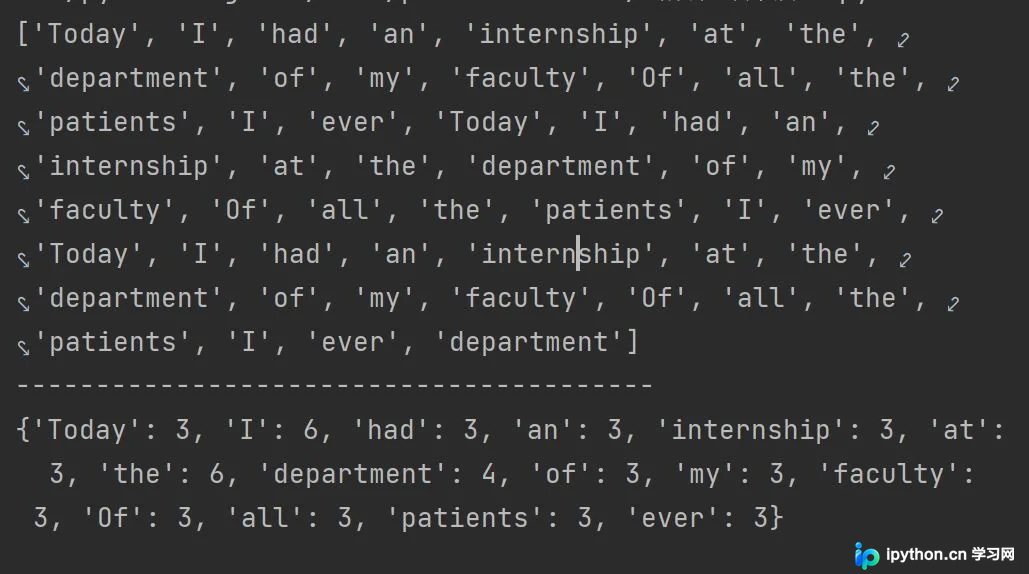
依然保持相同的底层数据提取流程。新建一个名为 dictionary_counter 的空字典对象。在随后的 for 单循环中,每次取出文件中的一个单词实例:if 语句校验该键值是否存在于字典中。若不存在则赋予初始计数值 1;若已存在,则对该键下的整数进行加法累加操作。
# 重新读取数据源并展平处理
with open("passage.txt", 'r', encoding='utf-8') as f:
    raw_lines = f.readlines()

token_list = []
for l in raw_lines:
    token_list += l.replace("\n", "").split(" ")

frequency_map = {}

for word_item in token_list:
    if word_item in frequency_map:
        frequency_map[word_item] += 1
    else:
        frequency_map[word_item] = 1

print(frequency_map)
技术验证与性能简析
上述两种方法均能有效达成预期的词频统计目标。第一个方法优势在于无需依赖高级数据结构,对于极少量数据的测试脚本具备较高的可读性;第二个方法凭借哈希表的 O(1) 平均查找速度,在数据规模增大时能够大幅削减 CPU 计算周期,更适合工业级或大样本量的应用环境。在实际编写代码时,请确保输入文件所在的磁盘目录具有足够的读取权限,且文件编码需与代码声明的 encoding 属性(通常为 utf-8)保持一致,以防因乱码引发 UnicodeDecodeError 中断运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









