

Django进阶:F与Q查询、事务及性能优化详解

本文深入解析Django ORM中F查询与Q查询的高级用法,涵盖字段动态比较、字符串拼接及复杂逻辑组合。同时介绍数据库事务处理机制,并对比update与save效率,详解select_related与prefetch_related的性能优化策略及bulk_create批量插入技巧,助力提升Django应用性能。
F查询
在前述示例中,过滤器通常是将字段值与预设常量进行对比。若需对同一模型实例中两个不同字段的值进行比较,应如何处理?
Django提供了F()对象以支持此类比较。在查询中引用F()实例,可直接获取字段值,从而比较同一Model实例中两个不同字段的数值关系。
示例1:
筛选卖出数量大于库存数量的商品记录。
from django.db.models import F
ret1=models.Product.objects.filter(maichu__gt=F('kucun'))
print(ret1)
F()允许将表中特定字段的值直接作为筛选条件,替代手动设定的常量,从而实现动态比较效果。
Django支持在F()对象之间,以及F()对象与常数之间进行加减乘除和取模运算。利用这些操作,可对表中数值型字段执行数学计算。
将每件商品的价格上调50元。
models.Product.objects.update(price=F('price')+50)
引申:
若需修改CharField类型的字段(严禁直接套用数值运算操作),应如何处理?
例如:在所有书名后追加“新款”字样。此时需使用字符串拼接操作Concat,并配合Value指定拼接内容。
from django.db.models.functions import Concat
from django.db.models import Value
ret3=models.Product.objects.update(name=Concat(F('name'),Value('新款')))
Concat用于执行字符串拼接,其参数位置决定拼接发生在头部还是尾部,Value内包含需新增的拼接字符串值。
Q查询
filter()等方法中,以逗号分隔的条件隐含“与”关系。若需执行更复杂的查询(如“或”逻辑),可使用Q对象。
示例1:
查询卖出数量大于100,或价格低于100元的商品。
from django.db.models import Q
models.Product.objects.filter(Q(maichu__gt=100)|Q(price__lt=100))
将条件包裹在Q对象中后,filter即可支持交叉并集的比较符。
示例2:
查询库存数量为100,且卖出数量不为0的产品。
models.Product.objects.filter(Q(kucun=100)&~Q(maichu=0))
可组合使用&和|操作符,并通过括号分组来构建任意复杂的Q对象。
此外,Q对象支持使用~操作符进行取反,从而允许组合常规查询与取反(NOT)查询。
示例3:
查询产品名称包含“新款”,且库存数量大于60的商品。
models.Product.objects.filter(Q(kucun__gt=60), name__contains="新款")
查询函数可混合使用Q对象与关键字参数。所有传递给查询函数的参数(无论是关键字参数还是Q对象)均默认进行“AND”连接。但需注意,若使用Q对象,必须置于所有关键字参数之前。
事务
事务定义:将多个SQL语句操作封装为原子性操作,要么全部成功,若其中任一环节失败则回滚至初始状态,以此保障数据的完整性与一致性(注:NoSQL数据库对事务的支持通常有限)。
    # 事务
    # 买一本 跟老男孩学Linux 书
    # 在数据库层面要做的事儿
    # 1. 创建一条订单数据
    # 2. 去产品表 将卖出数+1, 库存数-1
    from django.db.models import F
    from django.db import transaction
    # 开启事务处理
    try:
        with transaction.atomic():
            # 创建一条订单数据
            models.Order.objects.create(num="110110111", product_id=1, count=1)
            # 能执行成功
            models.Product.objects.filter(id=1).update(kucun=F("kucun")-1, maichu=F("maichu")+1)
    except Exception as e:
        print(e)
其他鲜为人知的操作
Django ORM执行原生SQL
场景假设:以博客园为例,博客归档按年月划分,而DateField存储格式为年月日。若需从数据库获取数据后重新处理为特定时间格式,Django未内置直接方法,需自行编写处理逻辑。
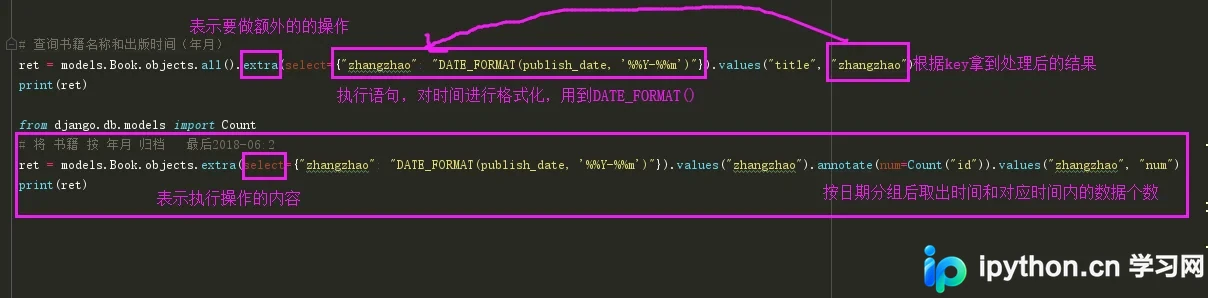
# extra
# 在QuerySet的基础上继续执行子语句
# extra(self, select=None, where=None, params=None, tables=None, order_by=None, select_params=None)

# select和select_params是一组,where和params是一组,tables用来设置from哪个表
# Entry.objects.extra(select={'new_id': "select col from sometable where othercol > %s"}, select_params=(1,))
# Entry.objects.extra(where=['headline=%s'], params=['Lennon'])
# Entry.objects.extra(where=["foo='a' OR bar = 'a'", "baz = 'a'"])
# Entry.objects.extra(select={'new_id': "select id from tb where id > %s"}, select_params=(1,), order_by=['-nid'])

举个例子:
models.UserInfo.objects.extra(
                    select={'newid':'select count(1) from app01_usertype where id>%s'},
                    select_params=[1,],
                    where = ['age>%s'],
                    params=[18,],
                    order_by=['-age'],
                    tables=['app01_usertype']
                )
                """
                select
                    app01_userinfo.id,
                    (select count(1) from app01_usertype where id>1) as newid
                from app01_userinfo,app01_usertype
                where
                    app01_userinfo.age > 18
                order by
                    app01_userinfo.age desc
                """


# 执行原生SQL
# 更高灵活度的方式执行原生SQL语句
# from django.db import connection, connections
# cursor = connection.cursor()  # cursor = connections['default'].cursor()
# cursor.execute("""SELECT * from auth_user where id = %s""", [1])
# row = cursor.fetchone()
QuerySet方法大全
几个比较重要的方法:
update()与save()的区别
两者均用于数据修改与保存,但save()会将数据列的所有字段重新写入,而update()仅针对修改的字段进行更新,效率更高且耗时更少。
因此,后续对数据的修改保存建议优先使用update()。
select_related和prefetch_related
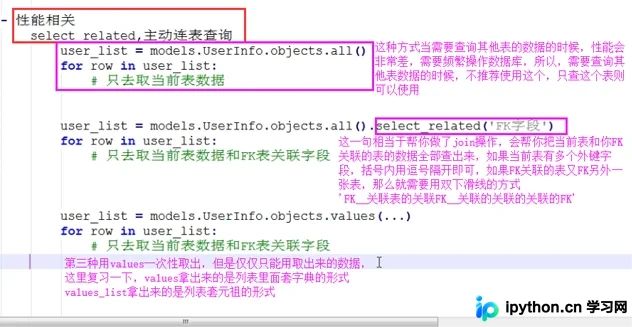
def select_related(self, *fields) 性能相关:表之间进行join连表操作,一次性获取关联的数据。 总结: 1. select_related主要针一对一和多对一关系进行优化。 2. select_related使用SQL的JOIN语句进行优化,通过减少SQL查询的次数来进行优化、提高性能。
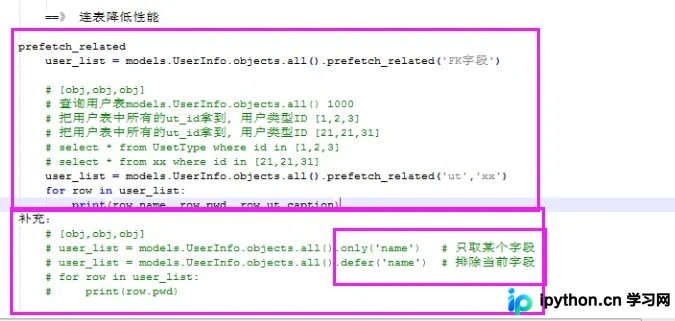
def prefetch_related(self, *lookups) 性能相关:多表连表操作时速度会慢,使用其执行多次SQL查询在Python代码中实现连表操作。 总结: 1. 对于多对多字段(ManyToManyField)和一对多字段,可以使用prefetch_related()来进行优化。 2. prefetch_related()的优化方式是分别查询每个表,然后用Python处理他们之间的关系。lated
 bulk_create
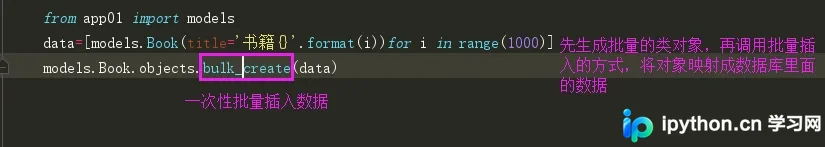
批量插入数据
要求:一次性插入多条数据
data = ["".join([str(random.randint(65, 99)) for i in range(4)]) for j in range(100)]
obj_list = [models.A(name=i) for i in data]
models.A.objects.bulk_create(obj_list)
QuerySet方法大全
##################################################################
# PUBLIC METHODS THAT ALTER ATTRIBUTES AND RETURN A NEW QUERYSET #
##################################################################

def all(self)
# 获取所有的数据对象

def filter(self, *args, **kwargs)
# 条件查询
# 条件可以是:参数,字典,Q

def exclude(self, *args, **kwargs)
# 条件查询
# 条件可以是:参数,字典,Q

def select_related(self, *fields)
性能相关:表之间进行join连表操作,一次性获取关联的数据。

总结:
1. select_related主要针一对一和多对一关系进行优化。
2. select_related使用SQL的JOIN语句进行优化,通过减少SQL查询的次数来进行优化、提高性能。

def prefetch_related(self, *lookups)
性能相关:多表连表操作时速度会慢,使用其执行多次SQL查询在Python代码中实现连表操作。

总结:
1. 对于多对多字段(ManyToManyField)和一对多字段,可以使用prefetch_related()来进行优化。
2. prefetch_related()的优化方式是分别查询每个表,然后用Python处理他们之间的关系。

def annotate(self, *args, **kwargs)
# 用于实现聚合group by查询

from django.db.models import Count, Avg, Max, Min, Sum

v = models.UserInfo.objects.values('u_id').annotate(uid=Count('u_id'))
# SELECT u_id, COUNT(ui) AS `uid` FROM UserInfo GROUP BY u_id

v = models.UserInfo.objects.values('u_id').annotate(uid=Count('u_id')).filter(uid__gt=1)
# SELECT u_id, COUNT(ui_id) AS `uid` FROM UserInfo GROUP BY u_id having count(u_id) > 1

v = models.UserInfo.objects.values('u_id').annotate(uid=Count('u_id',distinct=True)).filter(uid__gt=1)
# SELECT u_id, COUNT( DISTINCT ui_id) AS `uid` FROM UserInfo GROUP BY u_id having count(u_id) > 1

def distinct(self, *field_names)
# 用于distinct去重
models.UserInfo.objects.values('nid').distinct()
# select distinct nid from userinfo

注:只有在PostgreSQL中才能使用distinct进行去重

def order_by(self, *field_names)
# 用于排序
models.UserInfo.objects.all().order_by('-id','age')

def extra(self, select=None, where=None, params=None, tables=None, order_by=None, select_params=None)
# 构造额外的查询条件或者映射,如:子查询

Entry.objects.extra(select={'new_id': "select col from sometable where othercol > %s"}, select_params=(1,))
Entry.objects.extra(where=['headline=%s'], params=['Lennon'])
Entry.objects.extra(where=["foo='a' OR bar = 'a'", "baz = 'a'"])
Entry.objects.extra(select={'new_id': "select id from tb where id > %s"}, select_params=(1,), order_by=['-nid'])

def reverse(self):
# 倒序
models.UserInfo.objects.all().order_by('-nid').reverse()
# 注:如果存在order_by,reverse则是倒序,如果多个排序则一一倒序


def defer(self, *fields):
models.UserInfo.objects.defer('username','id')
或
models.UserInfo.objects.filter(...).defer('username','id')
#映射中排除某列数据

def only(self, *fields):
#仅取某个表中的数据
models.UserInfo.objects.only('username','id')
或
models.UserInfo.objects.filter(...).only('username','id')

def using(self, alias):
指定使用的数据库,参数为别名(setting中的设置)


##################################################
# PUBLIC METHODS THAT RETURN A QUERYSET SUBCLASS #
##################################################

def raw(self, raw_query, params=None, translations=None, using=None):
# 执行原生SQL
models.UserInfo.objects.raw('select * from userinfo')

# 如果SQL是其他表时,必须将名字设置为当前UserInfo对象的主键列名
models.UserInfo.objects.raw('select id as nid from 其他表')

# 为原生SQL设置参数
models.UserInfo.objects.raw('select id as nid from userinfo where nid>%s', params=[12,])

# 将获取的到列名转换为指定列名
name_map = {'first': 'first_name', 'last': 'last_name', 'bd': 'birth_date', 'pk': 'id'}
Person.objects.raw('SELECT * FROM some_other_table', translations=name_map)

# 指定数据库
models.UserInfo.objects.raw('select * from userinfo', using="default")

################### 原生SQL ###################
from django.db import connection, connections
cursor = connection.cursor() # cursor = connections['default'].cursor()
cursor.execute("""SELECT * from auth_user where id = %s""", [1])
row = cursor.fetchone() # fetchall()/fetchmany(..)


def values(self, *fields):
# 获取每行数据为字典格式

def values_list(self, *fields, **kwargs):
# 获取每行数据为元祖

def dates(self, field_name, kind, order='ASC'):
# 根据时间进行某一部分进行去重查找并截取指定内容
# kind只能是:"year"(年), "month"(年-月), "day"(年-月-日)
# order只能是:"ASC" "DESC"
# 并获取转换后的时间
- year : 年-01-01
- month: 年-月-01
- day : 年-月-日

models.DatePlus.objects.dates('ctime','day','DESC')

def datetimes(self, field_name, kind, order='ASC', tzinfo=None):
# 根据时间进行某一部分进行去重查找并截取指定内容,将时间转换为指定时区时间
# kind只能是 "year", "month", "day", "hour", "minute", "second"
# order只能是:"ASC" "DESC"
# tzinfo时区对象
models.DDD.objects.datetimes('ctime','hour',tzinfo=pytz.UTC)
models.DDD.objects.datetimes('ctime','hour',tzinfo=pytz.timezone('Asia/Shanghai'))

"""
pip3 install pytz
import pytz
pytz.all_timezones
pytz.timezone(‘Asia/Shanghai')
"""

def none(self):
# 空QuerySet对象


####################################
# METHODS THAT DO DATABASE QUERIES #
####################################

def aggregate(self, *args, **kwargs):
# 聚合函数,获取字典类型聚合结果
from django.db.models import Count, Avg, Max, Min, Sum
result = models.UserInfo.objects.aggregate(k=Count('u_id', distinct=True), n=Count('nid'))
===> {'k': 3, 'n': 4}

def count(self):
# 获取个数

def get(self, *args, **kwargs):
# 获取单个对象

def create(self, **kwargs):
# 创建对象

def bulk_create(self, objs, batch_size=None):
# 批量插入
# batch_size表示一次插入的个数
objs = [
models.DDD(name='r11'),
models.DDD(name='r22')
]
models.DDD.objects.bulk_create(objs, 10)

def get_or_create(self, defaults=None, **kwargs):
# 如果存在,则获取,否则,创建
# defaults 指定创建时,其他字段的值
obj, created = models.UserInfo.objects.get_or_create(username='root1', defaults={'email': '1111111','u_id': 2, 't_id': 2})

def update_or_create(self, defaults=None, **kwargs):
# 如果存在,则更新,否则,创建
# defaults 指定创建时或更新时的其他字段
obj, created = models.UserInfo.objects.update_or_create(username='root1', defaults={'email': '1111111','u_id': 2, 't_id': 1})

def first(self):
# 获取第一个

def last(self):
# 获取最后一个

def in_bulk(self, id_list=None):
# 根据主键ID进行查找
id_list = [11,21,31]
models.DDD.objects.in_bulk(id_list)

def delete(self):
# 删除

def update(self, **kwargs):
# 更新

def exists(self):
# 是否有结果
到此这篇关于django中F与Q查询的使用的文章就介绍到这了,更多相关django F与Q查询内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









