

Python常用数据结构详解:栈、队列、元组、集合与字典

本文系统介绍Python中核心的数据结构,包括利用List实现栈、使用Deque优化队列性能、探讨Tuple的不可变性与线程安全优势,以及Range序列。深入解析集合Set的运算、字典Dict的Key约束与生成式创建,并详解列表生成式、条件过滤、嵌套应用及生成器Lazy Loading机制,最后涵盖循环遍历的各种技巧。
栈
# 使用List作为栈
stack = [3, 4, 5]

# 入栈
stack.append(6)
# 出栈
val = stack.pop()
# 栈定元素
val = stack[-1]
队列
队列遵循先进先出(FIFO)原则,然而直接使用List处理First Out操作时效率较低。在实际开发中,通常推荐采用双端队列Deque来构建高效的队列结构。
Deque的核心优势在于其两端添加和删除元素的时间复杂度均为O(1),这使其在处理频繁进出队操作时表现优异。
from collections import deque
queue = deque(["Eric", "John", "Michael"])

# 入队列
queue.append("Terry")
# 出队列
queue.popleft()
元组
元组(Tuple)在外观上与List非常相似,但其本质区别在于Tuple是不可变的数据结构,一旦创建便无法修改。
# 创建, 等号右边可以用括号扩起来
empty = ()
xyz = 12345, 54321, 'hello!'
one = 12345,
## Unpacking
x, y, z = xyz
x, = one
需要注意的是,Tuple内部可以包含如List这样的可变元素。这意味着虽然Tuple本身的引用不可变,但其内部引用的可变对象的内容仍可被修改。
a = [1,2,3]
b = [4,5,6]
# 创建, 等号右边可以用括号扩起来
t = (a, b)
# ([1, 2, 3], [4, 5, 6])
a.append(4)
b.append(7)
print(t)
# ([1, 2, 3, 4], [4, 5, 6, 7])
如果应用场景中Tuple的功能已完全满足需求,那么使用Tuple相比List具备以下两个显著优势:
- 由于元组具有不可修改的特性,因此它在天然上具备线程安全性,无需额外的同步机制即可在多线程环境中安全使用。
- 在内存占用方面,元组通常优于列表。由于元组结构固定且不可变,Python解释器可以对其进行更优化的内存布局,从而节省空间。
import sys
t = tuple(range(2 ** 24))
l = [i for i in range(2 ** 24)]

# 比较内存使用
print(sys.getsizeof(t), sys.getsizeof(l))
Tuple的创建方式多样,可以通过括号包裹元素或使用逗号分隔来定义。
import timeit

# 从Range转换Tuple 这种速度最快,推荐此方法
timeit.timeit('''t = tuple(range(10000))''', number = 10000)

# 从List创建Tuple
timeit.timeit('''t = tuple([i for i in range(10000)])''', number = 10000)

# 从Range创建Tuple
timeit.timeit('''t = tuple(i for i in range(10000))''', number = 10000)

# Unpacking生成器创建Tuple
timeit.timeit('''t = *(i for i in range(10000)),''', number = 10000)
Range
Range属于序列数据结构(与List、Tuple并列)的一种,常用于For循环中生成整数序列,是控制迭代次数的常用工具。
# 0 - 9
val = range(10)
val = range(0, 10)
val = range(0, 10, 1)
集合
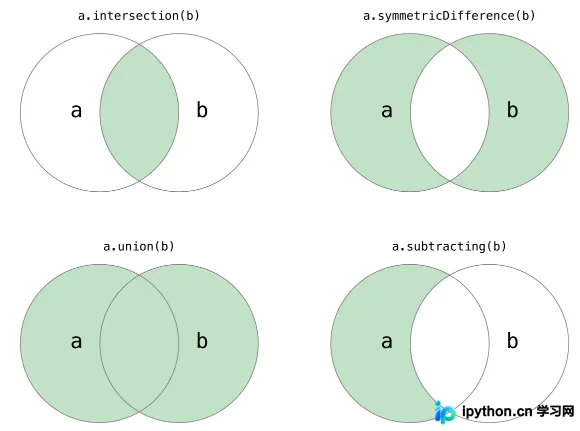
empty = set()
a = {1, 2, 3, 3, 3, 2}
b = {1, 3, 5, 7, 9}

# 超集和子集
a <= b
a.issubset(b)
b.issuperset(a)

# 交集
intersection = a & b
# 并集
union = a | b
# 差
subtraction = a - b
# 对称差
symmetric_difference = a ^ b
字典
字典由键值对(Key: Value)组成。对于Key的要求必须是不可变类型,例如String、Number等,以确保其哈希值稳定。
因此,Tuple可以作为字典的Key,而List因为可变,不能作为Key。
# {'sape': 4139, 'guido': 4127, 'jack': 4098}
d = dict([('sape', 4139), ('guido', 4127), ('jack', 4098)])

# {2: 4, 4: 16, 6: 36}
d = {x: x**2 for x in (2, 4, 6)}

# {'sape': 4139, 'guido': 4127, 'jack': 4098}
d = dict(sape=4139, guido=4127, jack=4098)
但是,如果Tuple内部包含可变类型(如List),那么该Tuple也不能作为Key,尝试这样做会引发如下错误:
TypeError: unhashable type: 'list'
生成式
生成式(List Comprehensions)提供了一种简洁且高效的语法方式来创建列表,替代了繁琐的循环追加操作。
# [0, 1, 4, 9, 16, 25, 36, 49, 64, 81]
# 创建列表
squares = []
for x in range(10):
 squares.append(x**2)

# 生成式
squares = [x**2 for x in range(10)]
条件语句
# [(1, 3), (1, 4), (2, 3), (2, 1), (2, 4), (3, 1), (3, 4)]
[(x, y) for x in [1,2,3] for y in [3,1,4] if x != y]
使用函数
# ['3.1', '3.14', '3.142', '3.1416', '3.14159']
from math import pi
[str(round(pi, i)) for i in range(1, 6)]
生成式嵌套
matrix = [
  [1, 2, 3, 4],
  [5, 6, 7, 8],
  [9, 10, 11, 12],
]

# 行列
matrix = [[row[i] for i in range(len(row))] for row in matrix]

# 列行
transposed = [[row[i] for row in matrix] for i in range(4)]
transposed = list(zip(*matrix))
生成器
生成器与生成式在语法上相似,但核心区别在于生成器采用懒加载模式(Lazy Loading),不会立即生成整个列表,而是按需产生数据,从而节省内存。
import sys
# 元素已经就绪,耗费较多的内存
l = [i for i in range(2 ** 24)]
print(sys.getsizeof(l))
# 146916504 // 8 = 2 ** 24

# 创建生成器对象, 不占用额外空间,但是需要数据的时候需要内部运算
l = (i for i in range(2 ** 24))
print(sys.getsizeof(l))
# 128
除了使用括号语法的生成器表达式外,还可以通过定义函数并使用yield关键字来创建生成器。
def fib(n):
  a, b = 0, 1
  for _ in range(n):
    a, b = b, a + b
    yield a

if __name__ == '__main__':
  for val in fib(20):
    print(val)
循环
列表循环
l = ['tic', 'tac', 'toe']

for index in range(len(l))
 print(index, l[index])

for val in l:
 print(val)

for index, val in enumerate(l):
 print(index, val)
字典循环
d = {'gallahad': 'the pure', 'robin': 'the brave'}

for key in d:
 print(key, d[key])

for key, val in d.items():
 print(key, val)
reversed
# [0, 2, 4, 6, 8]
for num in range(0, 10, 2):
 print(num)

# [8, 6, 4, 2, 0]
for num in reversed(range(0, 10, 2)):
 print(num)
zip
zip函数返回一个Tuple的迭代器,其第i个元素由参数中每一个可迭代对象的第i个元素组成。结果的长度等于所有参数中最短的那个序列的长度。
以上就是python中常用的数据结构介绍的详细内容,更多关于python 数据结构的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









