

Python批量读取指定字符与替换文件内容的实现方法

发布时间:2026-10-12| 2人浏览过
本文介绍如何使用Python批量读取NLP生成的指定字符文件,并通过冒号分隔符提取关键信息。同时提供通用代码示例,展示如何对TXT或XML文件进行批量字符串替换,适用于多种格式的文件处理场景。
1、背景
本文旨在展示如何从NLP生成的特定文件中提取并读取指定的字符内容。
2、待读取文件
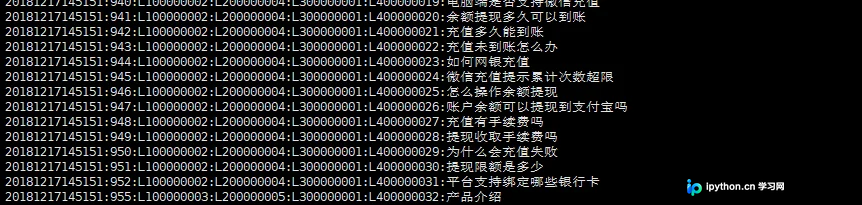
该文件以冒号(":")作为字段分隔符,且每行数据以换行符结尾。文件命名为XXX.train。
3、读取每一句中的汉字
...
file_train = os.path.join(rootDir,"data/train/rg_train_"+modle_date+"_"+aiscene+".train")
with open(file_train, 'r')as fp:
	textlist = fp.readlines()
	for text in textlist:
		if ":" in text:
			L4ID = text.split(":")[-2]
			Msg = text.split(":")[-1]
			if query_start == Msg.strip("\n"):
				print("Msg is in train:",Msg)
...
代码逻辑首先定位并获取目标文件,随后逐行读取文件内容,并以冒号(":")作为分隔符对每行数据进行分割处理。在分割后的列表中,索引-1代表最后一个元素,索引-2代表倒数第二个元素,据此提取所需字段。
无论处理的是txt、xml还是其他格式的文件,均可采用类似的逻辑实现文件中字符串的批量替换操作。
# -*- coding:utf-8 -*-
__author__ = 'ShawDa'

import glob

xmls = glob.glob('xml_files/*.xml')
for one_xml in xmls:
  print(one_xml)
  f = open(one_xml, 'r+', encoding='utf-8')
  all_the_lines = f.readlines()
  f.seek(0)
  f.truncate()
  for line in all_the_lines:
    line = line.replace('dog', 'pig')
    line = line.replace('cat', 'bike')
    f.write(line)
  f.close()
到此这篇关于Python 批量读取文件中指定字符的实现的文章就介绍到这了,更多相关Python 批量读取指定字符内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









