


Ruby 项目一旦开始多人协作,只靠本地手动执行测试和构建,很快就会遇到反馈慢、环境不一致、问题难回溯这些常见麻烦。把 GitLab CI 接进项目后,可以把测试、构建甚至打包部署统一放进流水线里执行。下面就从最基础的配置文件写法讲起,再说明缓存和多阶段流程分别适合解决什么问题,帮助你判断一套 Ruby CI 流程该如何落地。
GitLab CI 能为 Ruby 项目解决什么问题
GitLab CI 是 GitLab 自带的持续集成服务,核心做法是在项目根目录放置一个 .gitlab-ci.yml 文件,用它描述流水线中的执行步骤。对于 Ruby 项目来说,这个文件通常会负责安装依赖、执行测试,以及根据需要补上构建或部署任务。
它的价值主要体现在几个方面:
- 自动化测试:每次提交后都能自动运行测试,减少漏测带来的风险。
- 快速反馈:开发者可以尽快知道某次提交是否破坏了已有功能。
- 版本可追溯:每次构建都绑定具体代码版本,定位问题更直接。
- 环境一致性:借助统一镜像或容器环境,尽量避免“我本地没问题”的情况。
如果你的 Ruby 应用已经在使用 Bundler、RSpec 这类常见工具,那么接入 GitLab CI 的门槛并不高,通常从一份最小配置开始就够用了。
如何编写最小可用的 .gitlab-ci.yml
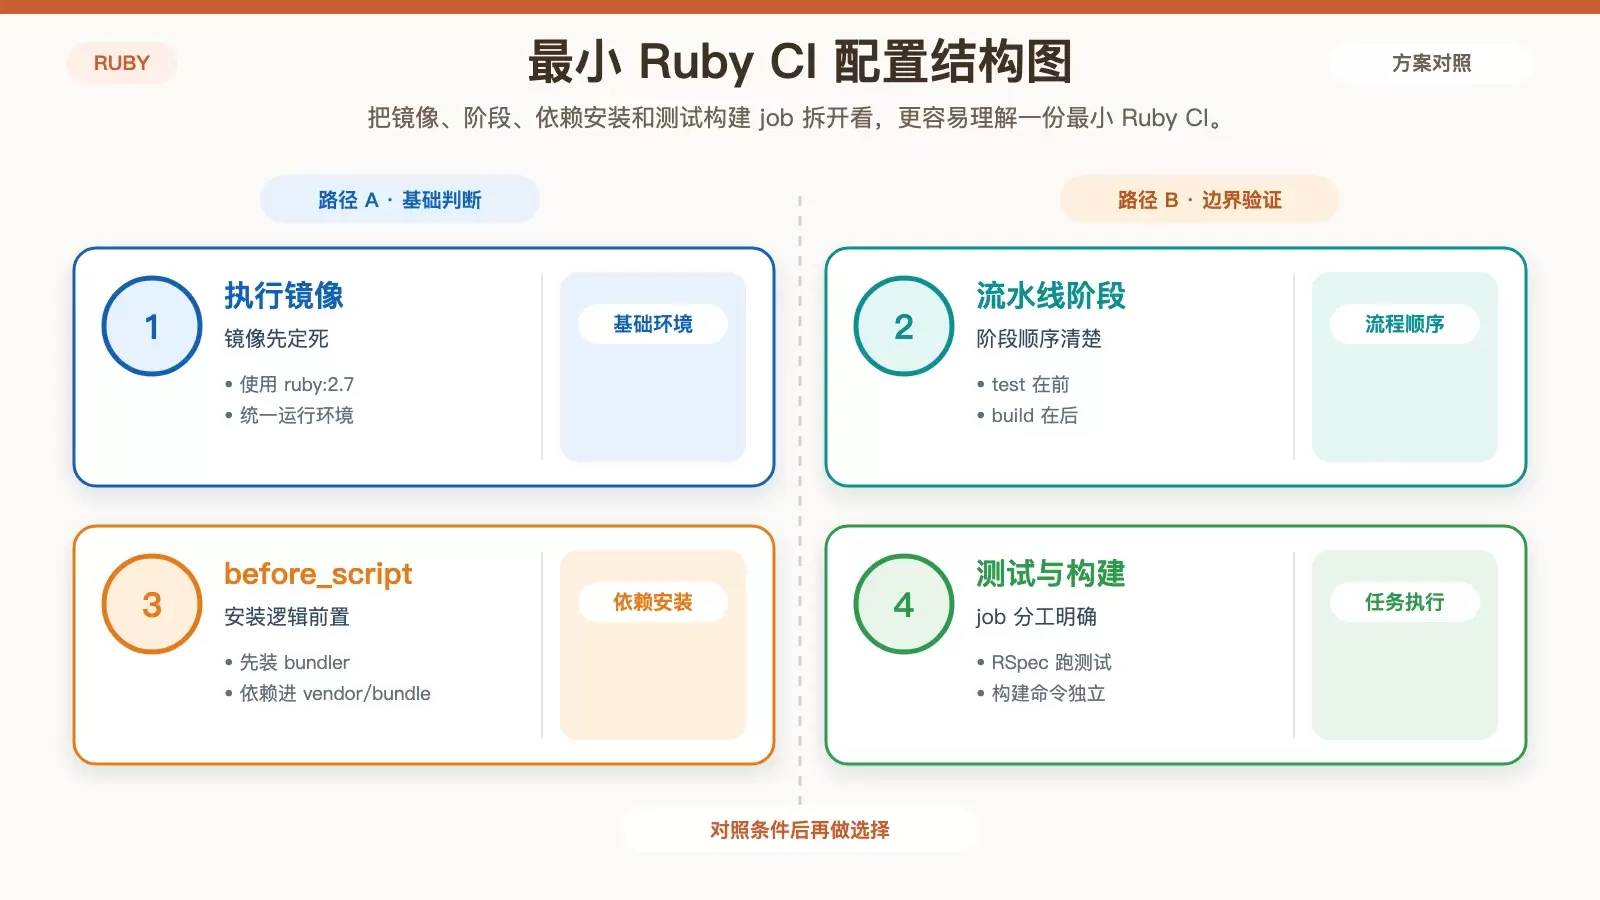
开始接入时,先创建一个最基础的 .gitlab-ci.yml 文件。它至少要说明使用什么镜像、流水线包含哪些阶段,以及每个 job 具体执行什么命令。
示例配置
image: ruby:2.7

stages:
  - test
  - build

cache:
  paths:
    - vendor/bundle/

before_script:
  - gem install bundler
  - bundle install --path vendor/bundle

test:
  stage: test
  script:
    - bundle exec rspec

build:
  stage: build
  script:
    - echo "Building the application..."
这份配置表达的是一条很典型的 Ruby 流水线:
- 通过
image: ruby:2.7指定运行环境。 - 使用
stages定义两个阶段:test和build。 - 在
before_script中先安装 Bundler,再执行bundle install --path vendor/bundle。 testjob 运行bundle exec rspec,用于执行测试。buildjob 则演示了如何追加一个构建步骤。
对很多项目来说,第一步不需要把流程设计得太复杂。只要先保证每次提交都能自动安装依赖并跑通测试,就已经能明显提升协作质量。后续再根据项目需要继续拆分任务,会比一开始堆很多阶段更容易维护。
为什么缓存能明显加快 Ruby 构建
Ruby 项目在 CI 中最常见的耗时点之一,就是重复安装 gem 依赖。如果每次流水线都从零开始下载和安装,执行时间会被明显拉长。GitLab CI 的缓存机制正是为这种场景准备的。
cache:
  paths:
    - vendor/bundle/
这里缓存的是 vendor/bundle/ 目录,也就是通过 Bundler 安装下来的依赖内容。这样配置后,GitLab CI 在后续构建时可以优先恢复这部分缓存,而不是每次重新安装所有 gem。
这项配置带来的直接收益有两点:
- 缩短流水线执行时间,尤其在依赖较多时更明显。
- 减少重复下载,提高 CI 资源利用率。
当然,缓存的作用是“加速”,不是替代依赖安装逻辑。也就是说,bundle install --path vendor/bundle 依然要保留,只是当缓存可用时,这一步会变得更快。
多阶段流水线适合哪些 Ruby 项目场景
当项目流程不再只有“跑测试”这么简单时,就可以考虑把流水线拆成多个阶段。GitLab CI 支持按顺序组织更复杂的工作流,例如先构建,再打包,最后部署。
示例:多阶段构建流程
stages:
  - build
  - package
  - deploy

build_job:
  stage: build
  script:
    - echo "Building the application..."

package_job:
  stage: package
  dependencies:
    - build_job
  script:
    - echo "Packaging the application..."
  artifacts:
    paths:
      - package.tar.gz

deploy_job:
  stage: deploy
  dependencies:
    - package_job
  script:
    - echo "Deploying the application..."
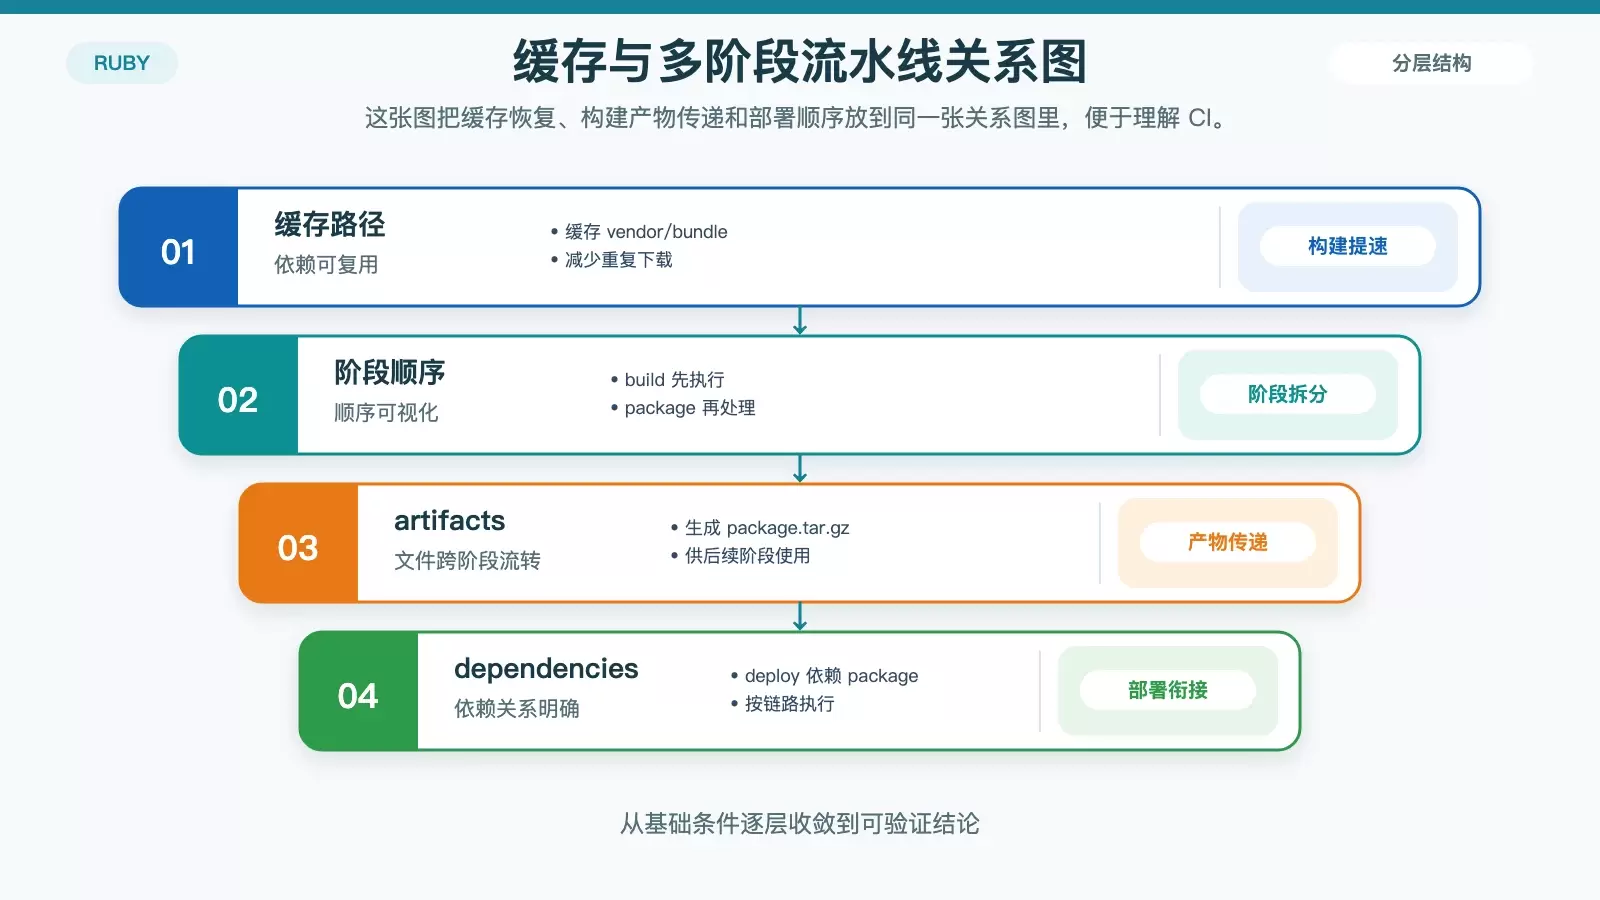
这段配置展示了一个比基础示例更完整的执行顺序:
build_job负责构建应用。package_job依赖build_job,在构建完成后进行打包。deploy_job再依赖package_job,用于最终部署。
其中有两个点值得特别注意:
1. 用 dependencies 明确上下游关系
通过依赖关系,可以让后续 job 只在前一个关键步骤完成后再继续执行。这样不仅顺序更清晰,也更符合真实的发布流程。
2. 用 artifacts 在阶段间传递产物
示例中的 package.tar.gz 被定义为构建产物,后续阶段可以基于它继续处理。这种做法非常适合需要打包、归档或发布可交付文件的 Ruby 项目。
如果你的应用后面还要生成 Docker 镜像、推送镜像仓库,或者接入部署环境,多阶段设计会比把所有命令塞进单个 job 更容易排错,也更便于扩展。
落地 Ruby + GitLab CI 时的实际判断
把 Ruby 应用接入 GitLab CI,通常可以按“先简单、后扩展”的方式推进:
- 先写一份最小配置,确保依赖安装和测试能自动执行。
- 再加入
cache,把vendor/bundle/缓存起来,缩短构建时间。 - 当流程开始涉及打包和部署时,再拆成多阶段流水线,并用
dependencies和artifacts串起上下游。
这样做的好处是,团队既能尽快获得自动化测试和快速反馈,也不会过早把 CI 配置写得过重。对大多数 Ruby 项目来说,这正是最实用的接入路径。









