

Python re.match、re.search与re.findall的区别及用法

假设你正在处理一批用户输入的日志或文本。输入内容形如 "状态码: 200, 耗时: 35ms",或者 "用户ID: 1001, 1002"。你需要从中提取数字。初学者使用标准库 re 时,往往会纠结于究竟该调用 match、search 还是 findall。如果用 match 去找第二个数字,会直接返回 None;用 search 只能抓到第一个数字;而用 findall 抓到所有结果后,如果模式带了分组括号,返回的结构又会发生变化。本文通过机制解析、直观对比和完整代码,明确这三个函数的差异与选型依据。
一、核心机制:扫描范围与返回类型的本质差异
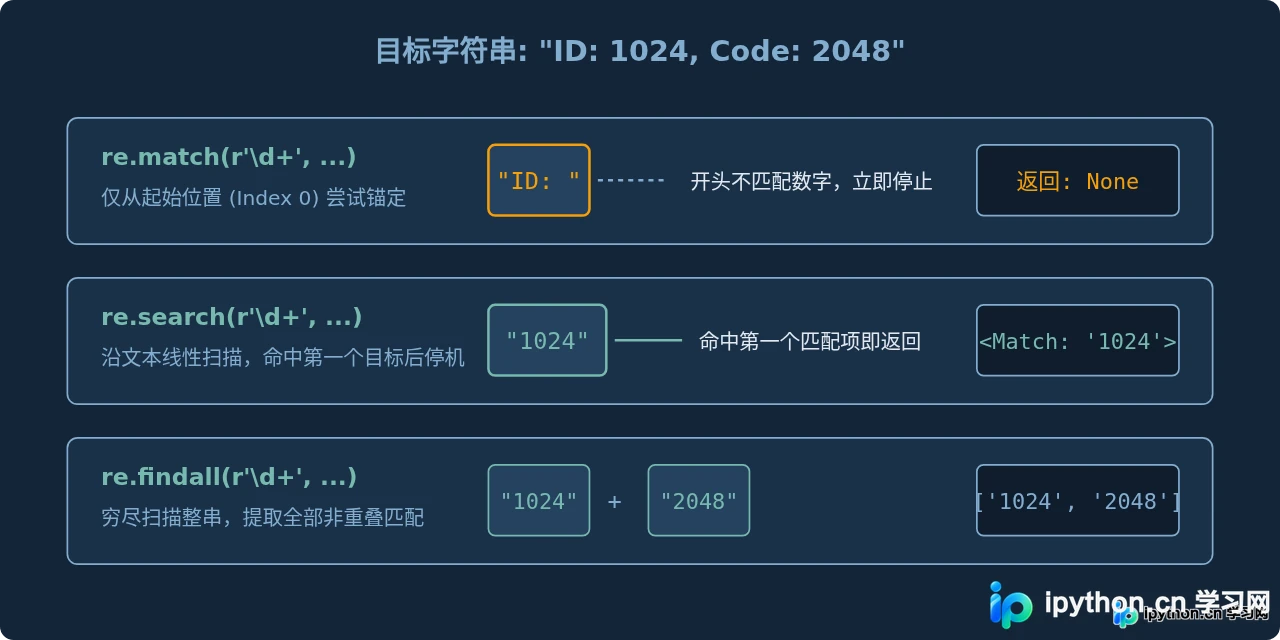
这三个函数最大的差别集中在两点:扫描字符串的起点与范围,以及匹配成功后的返回数据结构。
- re.match(pattern, string):只从字符串的开头(索引 0)开始比对。如果字符串开头的第一个字符就无法匹配模式,它会立即放弃并返回
None,即便目标模式出现在字符串正中间也不会去扫描。 - re.search(pattern, string):扫描整个字符串,找到第一个匹配的位置就停止比对。如果匹配成功,返回单个
Match对象;若全串都不包含模式,返回None。 - re.findall(pattern, string):遍历整个字符串,检索所有不重叠的匹配项。它不返回
Match对象,而是直接返回一个 Pythonlist(列表)。当全串没有匹配时,返回空列表[]而不是None。
二、各函数具体用法与代码实操
1. re.match:前缀校验与格式定界
re.match 的设计意图是检测字符串是否以特定模式开头。由于其严格从头比对的特性,常用于校验用户输入格式是否合规(如手机号、固定前缀的订单号)。
import re

text_valid = "SN-2026-9812: 检验通过"
text_invalid = "错误日志: SN-2026-9812 失败"

pattern = r"SN-\d{4}-\d+"

# 示例 1: 从开头完全符合模式
match_res1 = re.match(pattern, text_valid)
if match_res1:
    print("匹配成功:", match_res1.group())  # 输出: SN-2026-9812
    print("索引范围:", match_res1.span())   # 输出: (0, 12)

# 示例 2: 目标模式出现在中间
match_res2 = re.match(pattern, text_invalid)
print("匹配结果:", match_res2) # 输出: None注意:如果你的正则表达式开头写了 ^(锚定开头),其实使用 re.search 和 re.match 的效果是一致的。但在没有 ^ 时,re.match 依然只查开头。
2. re.search:定位局部关键信息
当你只关心目标文本中有没有某个关键词或数据片段,且只需要取第一个结果时,re.search 是最高效的选择。它扫描到第一个满足条件的结果便立刻终止检索。
import re

log_line = "2026-10-06 12:00:00 [ERROR] Connection timeout to 192.168.1.10 after 30s"

# 提取出现的首个 IP 地址
ip_pattern = r"\d{1,3}\.\d{1,3}\.\d{1,3}\.\d{1,3}"
search_res = re.search(ip_pattern, log_line)

if search_res:
    print("提取内容:", search_res.group())       # 输出: 192.168.1.10
    print("所在起始位置:", search_res.start())     # 输出: 48
    print("所在结束位置:", search_res.end())       # 输出: 60
3. re.findall:批量抽取与提取全部实例
re.findall 适用于收集全部符合条件的项。需要特别注意:re.findall 对小括号 ()(捕获组)极其敏感。是否有捕获组会直接改变返回列表内元素的类型。
import re

text = "apple: $15, banana: $8, orange: $12"

# 情况 A: 模式中无捕获组,返回完整匹配字符串组成的列表
res_no_group = re.findall(r"\$\d+", text)
print("无分组:", res_no_group)
# 输出: ['$15', '$8', '$12']

# 情况 B: 模式中有 1 个捕获组,仅返回组内内容
res_single_group = re.findall(r"\$(\d+)", text)
print("单分组:", res_single_group)
# 输出: ['15', '8', '12']

# 情况 C: 模式中有多个捕获组,返回元组列表
res_multi_groups = re.findall(r"([a-z]+):\s*\$(\d+)", text)
print("多分组:", res_multi_groups)
# 输出: [('apple', '15'), ('banana', '8'), ('orange', '12')]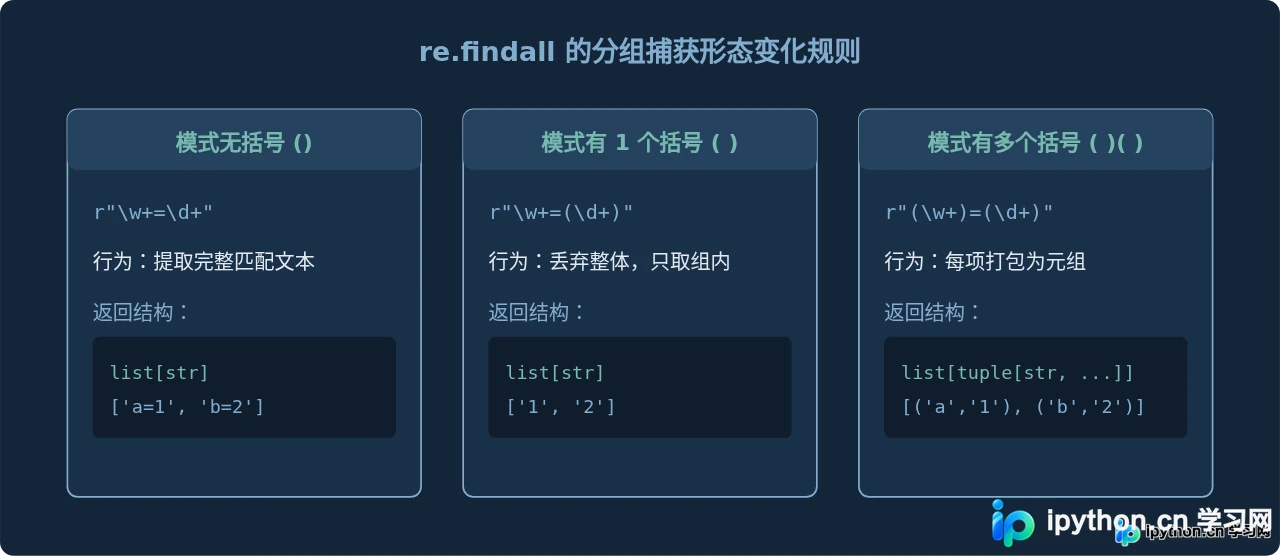
三、执行流程与防护:避免 NoneType 异常
re.match 和 re.search 返回的是 re.Match 实例或 None。如果未匹配成功直接调用 .group(),代码会抛出致命的 AttributeError: 'NoneType' object has no attribute 'group'。规范的处理方式是执行判断或使用海象运算符(Python 3.8+)。
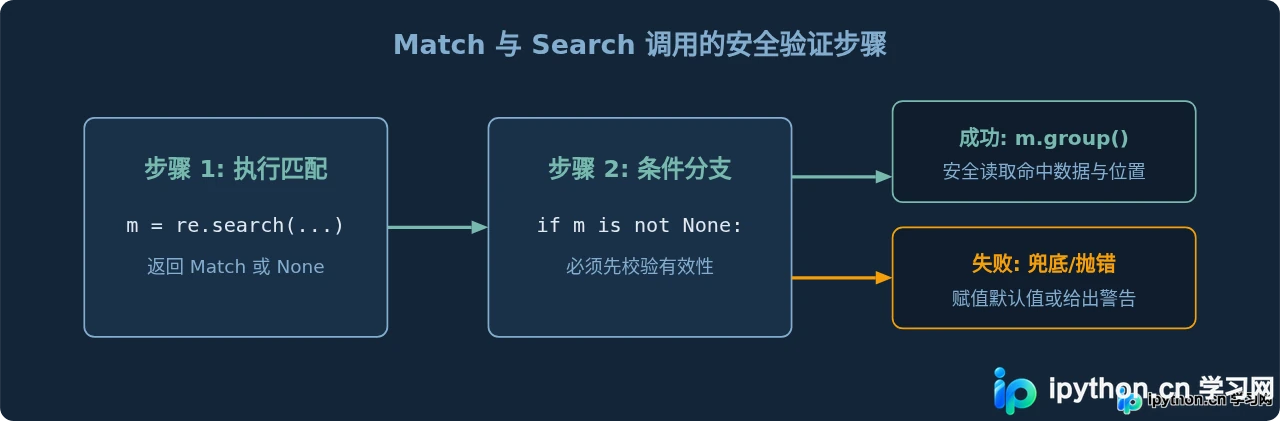
标准的安全处理范式如下:
# 推荐范式:海象运算符简洁写法 (Python 3.8+)
raw_text = "TaskID: 8879"
if match := re.search(r"\d+", raw_text):
    print("安全取得结果:", match.group())
else:
    print("未找到有效内容,执行默认逻辑")
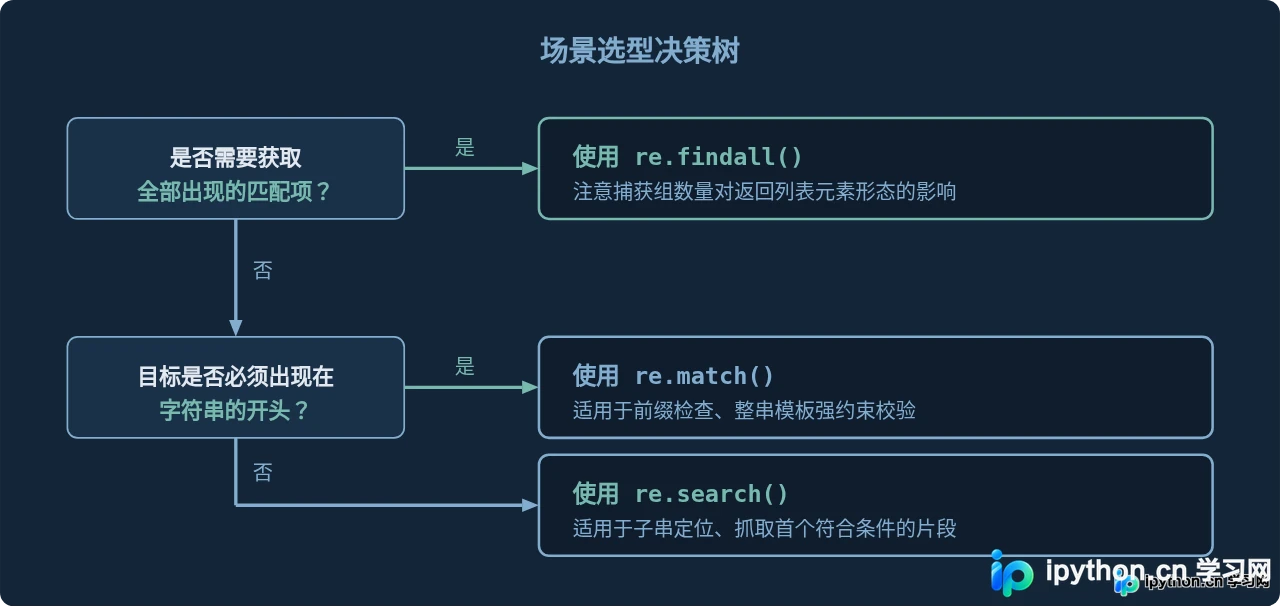
四、核心特性对比与选型指南
在实际编码时,可以参考下表列出的关键特性进行快速权衡:
| 函数 | 扫描范围 | 返回类型 | 未匹配时的返回值 | 典型适用场景 |
|---|---|---|---|---|
re.match() |
仅字符串起始处 (Index 0) | Match 对象 |
None |
前缀校验、整行格式校验 |
re.search() |
整串扫描(遇到首个匹配即停) | Match 对象 |
None |
检测包含关系、提取首个目标特征 |
re.findall() |
整串扫描(提取所有不重叠匹配) | list (字符串或元组) |
[] (空列表) |
批量抓取日志、抓取所有链接/数值 |
五、高频踩坑点与补充建议
除了选型之外,在实际项目中还需要注意以下细节:
- 想要非捕获分组时使用
(?:...):如果你使用re.findall只是为了让部分模式逻辑成组(例如(?:abc)+),而不需要提取该组,一定要加上?:,否则findall会只返回该组内部的字符串。 - 大数据量批量匹配建议考虑
re.finditer:当待搜索的长文本包含成千上万个匹配项,或者你需要获取每个匹配项的具体下标位置(span())时,findall无法提供位置且一次性将整个列表载入内存。此时使用re.finditer(pattern, string)返回迭代器,每次产出Match对象,内存占用更小。 - 预编译提升性能:当在循环或高频接口内重复使用同一个正则模式时,先使用
compiled_pattern = re.compile(pattern),再调用compiled_pattern.search(text)或match/findall,避免重复解析正则带来的开销。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









