

Python中os.linesep和\n有什么区别

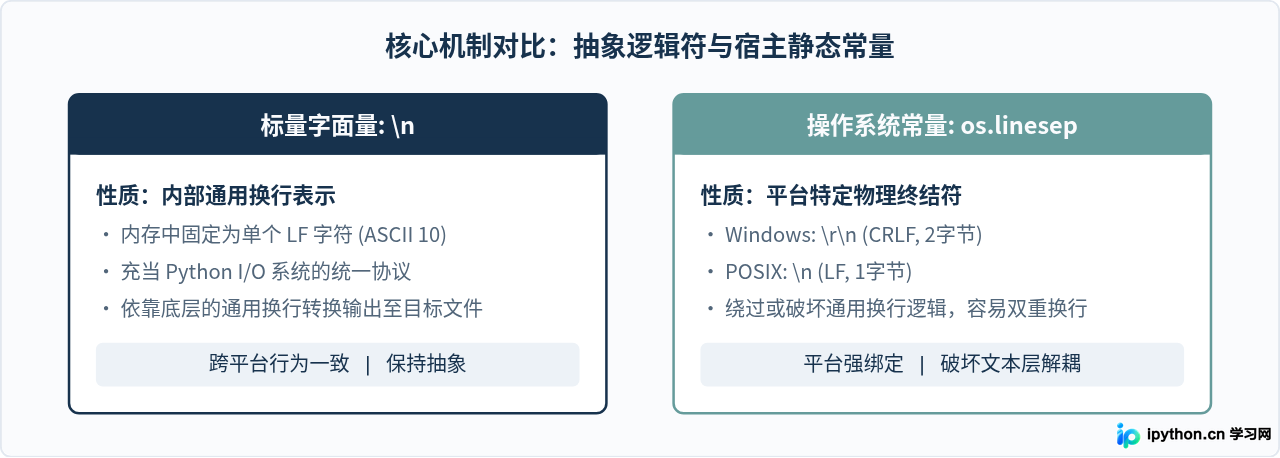
核心区别在于:\n 是通用的换行符字面量,也是 Python 内部处理文本的标准统一抽象;而 os.linesep 是一个固定字符串,仅表示当前宿主操作系统的默认物理换行符(Windows 下为 \r\n,POSIX 系统如 Linux 与 macOS 下为 \n)。在几乎所有文件读写和跨平台文本处理场景中,直接使用 \n 才是规范做法。
1. 核心属性与定义对比
很多刚从其他语言转向 Python 的开发者常有一种误解:认为为了实现跨平台兼容,写文件时必须用 os.linesep 拼接待换行文本。事实上,Python 官方文档中明确指出:写入文件时不要使用 os.linesep,应统一使用常规的 \n。
我们首先通过一段简明的代码,观察两者在运行时的具体表现:
import os

print("os.linesep 原始表示:", repr(os.linesep))
print("\\n 原始表示:", repr("\n"))
示例输出(Windows 环境):
os.linesep 原始表示: '\r\n'
\n 原始表示: '\n'
示例输出(Linux 或 macOS 环境):
os.linesep 原始表示: '\n'
\n 原始表示: '\n'从上面的结果可以看到,\n 永远稳定指向单个换行字符(ASCII 10),而 os.linesep 会随着运行平台的差异发生改变。下表清晰列举了两者的属性差异:
| 对比维度 | \n |
os.linesep |
|---|---|---|
| 本质定位 | 标准转义字符,Python 内部文本逻辑换行符 | os 模块导出的环境变量常量字符串 |
| Windows 取值 | \n (LF, 0x0A) |
\r\n (CRLF, 0x0D 0x0A) |
| Linux/macOS 取值 | \n (LF, 0x0A) |
\n (LF, 0x0A) |
| 受通用换行影响 | 是(由 I/O 层根据 newline 参数自动转换) |
否(会被 I/O 层视作普通字符串再次处理) |
| 常规文本读写推荐 | 强烈推荐(官方标准写法) | 不推荐(会导致换行符异常放大或冗余) |
2. Python 3 的通用换行符机制(Universal Newlines)
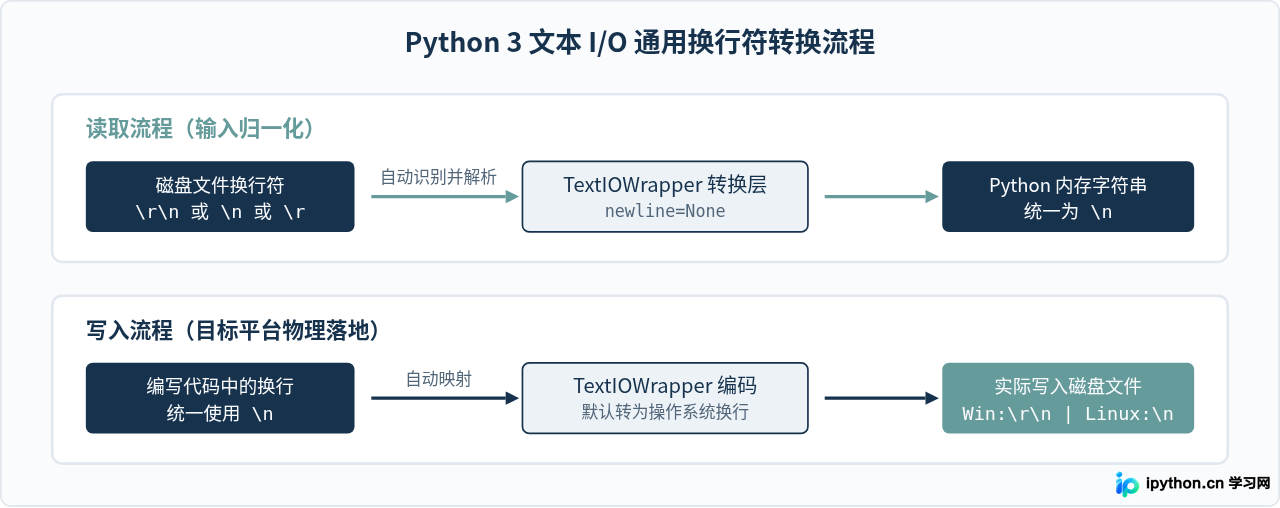
要真正搞明白为什么不能混用两者,必须理解 Python 3 是如何管理文件换行的。在 Python 3 中,以文本模式(mode='t',也就是默认模式)打开文件时,内置的 open() 函数具备“通用换行符”机制。
这个机制在读取与写入两个阶段分别发挥关键作用:
- 读取文件时:不管磁盘文件是 Windows 的
\r\n、旧 Mac 的\r还是 Linux 的\n,Python 都会将其自动规整为单个\n返回给内存中的字符串。 - 写入文件时:你在代码中写入的所有
\n,Python 都会依据当前系统的规范(或通过newline参数指定的值),自动转换为对应操作系统的物理换行符。在 Windows 下,写入的\n会自动转换为\r\n落地到磁盘。
3. 为什么在写文件时不应使用 os.linesep?
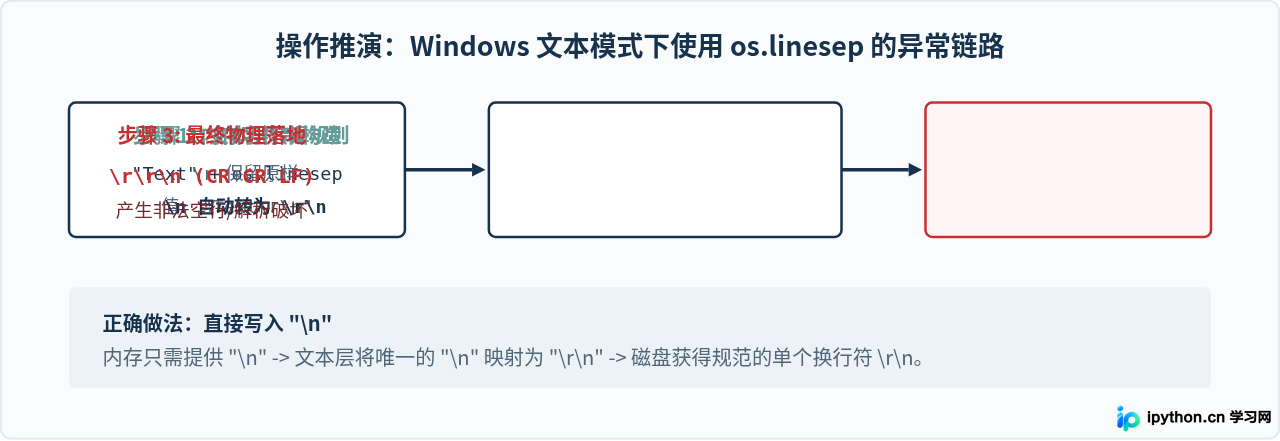
如果在 Windows 环境下的文本模式中错误使用了 os.linesep,会发生经典的“双重换行”灾难。
当我们在 Windows 下执行 f.write("Line 1" + os.linesep) 时:
os.linesep在 Windows 下求值为字符串\r\n。- 程序向
f.write()传入了"Line 1\r\n"。 - 文本写入转换机制介入:字符
\r被原样保留;紧随其后的\n则被系统认定为“需要转换为本操作系统标准的换行”,再次转换成了\r\n。 - 最终物理写入磁盘文件的字节序列变成了:
\r\r\n。
这个多出来的 \r(回车符)会导致一些编辑器在渲染时出现多余的空行,或者在与其他系统交互(如 Git、Linux 脚本执行)时产生难以察觉的解析错误。
二进制模式写入对比验证
为了证实这一底层行为,我们可以通过以下代码进行实验验证:以二进制模式(wb)读取刚写入的文件,直接查看物理磁盘上的真实字节。
import os

# 方式 A:错误写法(在文本模式中使用 os.linesep)
with open("test_linesep.txt", "w", encoding="utf-8") as f:
    f.write("Line1" + os.linesep)

# 方式 B:推荐写法(在文本模式中统一使用 \n)
with open("test_newline.txt", "w", encoding="utf-8") as f:
    f.write("Line1\n")

# 以二进制读取并验证底层字节
with open("test_linesep.txt", "rb") as f:
    print("使用 os.linesep 生成的文件字节:", f.read())

with open("test_newline.txt", "rb") as f:
    print("使用 \\n 生成的文件字节:", f.read())
在 Windows 环境下的输出结果为:
使用 os.linesep 生成的文件字节: b'Line1\r\r\n'
使用 \n 生成的文件字节: b'Line1\r\n'
对比清晰展示:在 Windows 平台下,使用 \n 反而得到了纯正符合操作系统的 \r\n 换行,而使用 os.linesep 则导致了损坏的 \r\r\n 字节流。
4. 场景选型决策指南
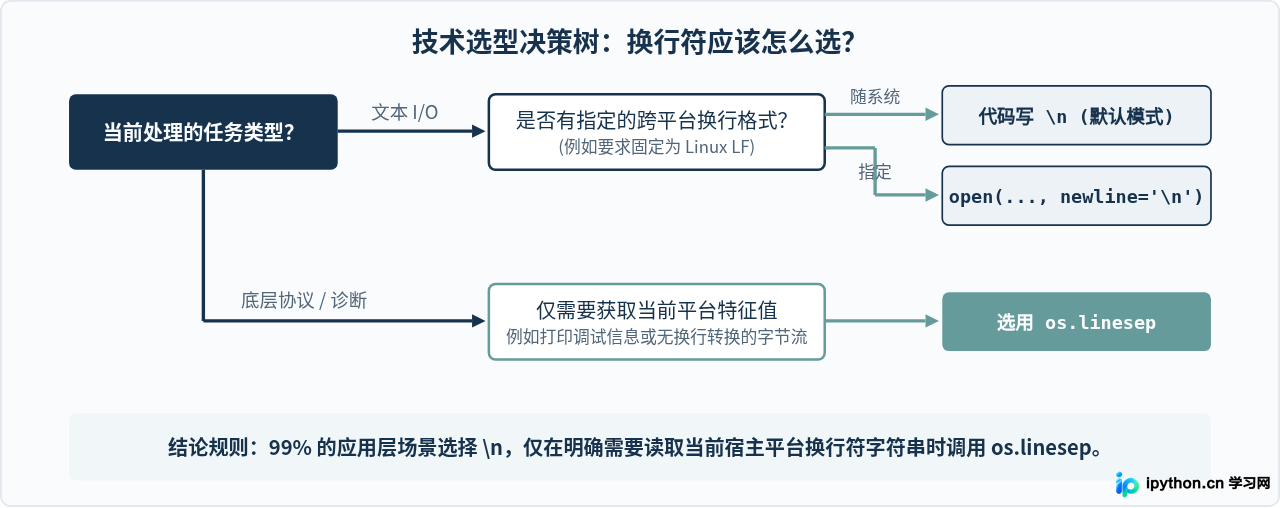
既然常规文件读写不应当使用 os.linesep,那么这个变量究竟在什么时候才有实际价值?
os.linesep 的本质是一个**描述当前运行环境特征的常量**。它主要用于不需要经过 Python 文本 I/O 翻译层处理的场景:
- 二进制协议或原始套接字组包:在需要直接以 bytes 或底层结构构造符合当前操作系统的二进制数据流时。
- 系统环境检测或调试输出:在诊断脚本中需要打印出当前宿主机器的换行符特征,或者配合某些古老的 C 扩展模块传递参数。
- 使用
newline=''控制模式时的特殊需求:如果使用open(..., newline='')禁用了 Python 的底层转换,又确实想手动拼接操作系统对应的物理终结符(不过这种场景下依然建议直接硬编码指定\r\n或\n,更具备可预测性)。
5. 跨平台文本处理的最佳实践
编写高质量跨平台 Python 代码时,换行符的处理通常遵循以下两条通用规则:
规则一:写常规文件时,始终在代码中统一使用 \n
依赖 Python 内置的转换层处理换行。当你需要向文件换行时,直接写入 \n 或使用 print(line, file=f)(其内部默认的 end 正是 \n)。
# 规范推荐写法
with open("data.txt", "w", encoding="utf-8") as f:
    f.write("首行数据\n")
    f.write("次行数据\n")
规则二:跨平台协同强制统一格式时,善用 newline 参数
在团队协作或编写自动化生成工具时,往往需要明确生成特定系统的文件(例如在 Windows 机器上生成需要部署到 Linux 服务器的 Shell 脚本或 Docker 配置文件,必须使用 LF 换行)。
此时不要通过拼接变量去解决,只需在 open() 时指定 newline='\n':
# 无论脚本在什么操作系统上运行,生成的文件都严格使用 LF (\n) 换行
with open("deploy.sh", "w", encoding="utf-8", newline="\n") as f:
    f.write("#!/bin/bash\n")
f.write("echo 'Service Starting...'\n")newline='',这是为了让标准库的 csv.writer 能够自行精确控制符合 RFC 4180 规范的换行(标准为 \r\n),避免产生每行下方的空白行。这进一步说明了 Python 社区将逻辑换行与物理控制交给标准参数、而非让用户手动拼接 os.linesep 的设计哲学。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









