

CentOS 7下Python调用Tesseract实现图像文字识别完整指南

本文详细介绍在CentOS 7环境下安装配置Tesseract OCR引擎,并通过Python结合Pillow和pytesseract库实现图像文字提取的方法。涵盖依赖安装、语言包配置、参数设置及代码实例,重点解析psm模式与中文识别注意事项,适用于爬虫验证码处理及基础文档数字化场景。
前言
在Python图像识别领域,Tesseract是最基础且广泛使用的工具之一,尤其在爬虫项目中处理验证码时应用频繁。
安装
网络上的安装教程大同小异,但在Windows系统中配置往往较为繁琐,涉及复杂的路径设置、环境变量配置以及不同于Linux的路径分隔符处理。因此,本教程基于CentOS 7系统进行讲解。
1. 依赖安装
yum install -y automake autoconf libtool gcc gcc-c++
2. 安装leptonica
Leptonica库主要用于图像的预处理和分析操作。
原则上,大多数库文件可以通过yum直接安装。若需获取特定版本,可前往官方源下载对应版本并按需编译安装。
wget http://www.leptonica.org/source/leptonica-1.74.4.tar.gz
tar -zxvf leptonica-1.74.4.tar.gz
cd leptonica-1.74.4/
./configure
make && make install
3. 安装tesseract
其他各版本可在官方渠道下载并自行编译,同时也提供可直接使用的文件。
yum install tesseract
4. 验证安装
tesseract --version
5. 语言包下载
前往tesseract-ocr/tessdata仓库下载所需的语言包,并将其移动至tessdata目录。可通过whereis tesseract命令查看具体目录路径,例如我的环境路径为/usr/share/tesseract/tessdata,执行mv *.traineddata /usr/local/share/tessdata/命令完成迁移。
6. 查看目前已下载的语言
tesseract --list-langs
使用
# tesseract
Usage:
 tesseract --help | --help-psm | --help-oem | --version
 tesseract --list-langs [--tessdata-dir PATH]
 tesseract --print-parameters [options...] [configfile...]
 tesseract imagename|stdin outputbase|stdout [options...] [configfile...]

OCR options:
 --tessdata-dir PATH  Specify the location of tessdata path.
 --user-words PATH   Specify the location of user words file.
 --user-patterns PATH Specify the location of user patterns file.
 -l LANG[+LANG]    Specify language(s) used for OCR.
 -c VAR=VALUE     Set value for config variables.
            Multiple -c arguments are allowed.
 --psm NUM       Specify page segmentation mode.
 --oem NUM       Specify OCR Engine mode.
NOTE: These options must occur before any configfile.
语法
tesseract imagename outputbase [-l lang] [-psm pagesegmode] [configfile...]
- imagename:指定待识别的图片文件名。
- outputbase:指定输出目标。若希望直接输出结果而非保存至文件,可使用stdout;否则,该参数将作为保存结果文件名的前缀。
- -l参数用于指定语言文件,默认使用英文。
- 执行tesseract --print-parameters可查看更多的参数信息。
- 使用-c参数可指定单个配置项的值,或将配置写入配置文件并置于命令末尾(支持加载多个配置文件)。
- psm参数用于指定图像识别的方式。
0:定向脚本监测(OSD)。
1:使用OSD进行自动分页。
2:自动分页,但不使用OSD或OCR(光学字符识别)。
3:全自动分页,但不使用OSD(此为默认模式)。
4:假设图像包含可变大小的文本列。
5:假设图像为垂直对齐文本的单个统一块。
6:假设图像为统一的文本块。
7:将图像视为单个文本行。
8:将图像视为单个词。
9:将图像视为圆中的单个词。
10:将图像视为单个字符。
python中使用
Tesseract安装完成后,可通过Python方便地调用,但需确保已安装pillow和pytesseract库作为支持。
python中转换
image_to_data(image, lang=None, config='', nice=0, output_type=Output.STRING)
- image Object:由Tesseract处理的图像,可以是PIL Image对象或NumPy数组。
- lang String:Tesseract语言代码字符串。
- config String:其他配置字符串,例如:config='--psm 6'。
- 语言文件可以叠加使用,用“+”符号隔开。
- 我们也可在此处设置tessdata路径,将其包含在config参数中即可。
- 更多配置项如config和psm的设置逻辑与命令行工具类似。
实例:
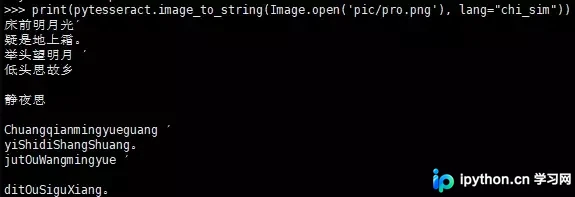
流程:首先打开图片,进行配置和转换。可通过Image的open方法或cv2的imread函数打开图片,建议对图片进行对比度增强和降噪等预处理,以提升识别效果。
from PIL import Image
import pytesseract
class Languages:
  CHS = 'chi_sim'
  ENG = 'eng'
def img_to_str(image_path, lang=Languages.ENG):
  return pytesseract.image_to_string(Image.open(image_path), lang)
print(img_to_str('pic/numu.png', lang=Languages.ENG))
print(img_to_str('pic/pro.png', lang=Languages.ENG))

总结
简单的文本识别效果尚可,但若涉及多空行、特殊符号等复杂情况,识别效果会下降。准确度方面,可通过训练字库达到理想效果。获取文本后,可利用re等库进行后续操作,应用场景广泛。2. 在验证码识别方面,tesserocr表现良好,使用较为便捷。
识别中文时可能会出现编码错误,这是识别过程中的一个潜在问题。网上有观点认为改变文本编码可解决此问题,但实际测试中往往无效,因此不建议直接对长文本图片进行转换处理。
对于图文处理需求,也可借鉴各大平台提供的API,如百度、腾讯、美团等均提供支持。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









