

Python自学避坑指南:初学者最容易忽视的5个核心概念
深入解析Python初学者最容易忽视的5个核心概念,包括变量引用机制、可变与不可变对象陷阱、LEGB作用域、迭代器与生成器以及模块导入与虚拟环境隔离,助你夯实底层认知、避免常见代码陷阱。
很多自学 Python 的初学者在掌握了基础语法、条件分支和循环之后,往往能快速写出几十行的小程序。但在编写稍复杂的逻辑时,常常会遇到诸如“修改变量却影响了其他数据”、“函数连续调用结果诡异累加”、“在局部作用域修改变量报错”、“程序处理大文件时内存爆满”或“模块明明写好却报 ModuleNotFoundError”等问题。这些坑点往往不是打字手误,而是源于对 Python 底层运作特性的忽略。本文梳理初学者最容易忽视的5个核心概念,通过直观的原理拆解、代码对照与步骤推导,帮助你在自学路径上少走弯路。
一、变量不是盒子,而是贴在对象上的“标签”
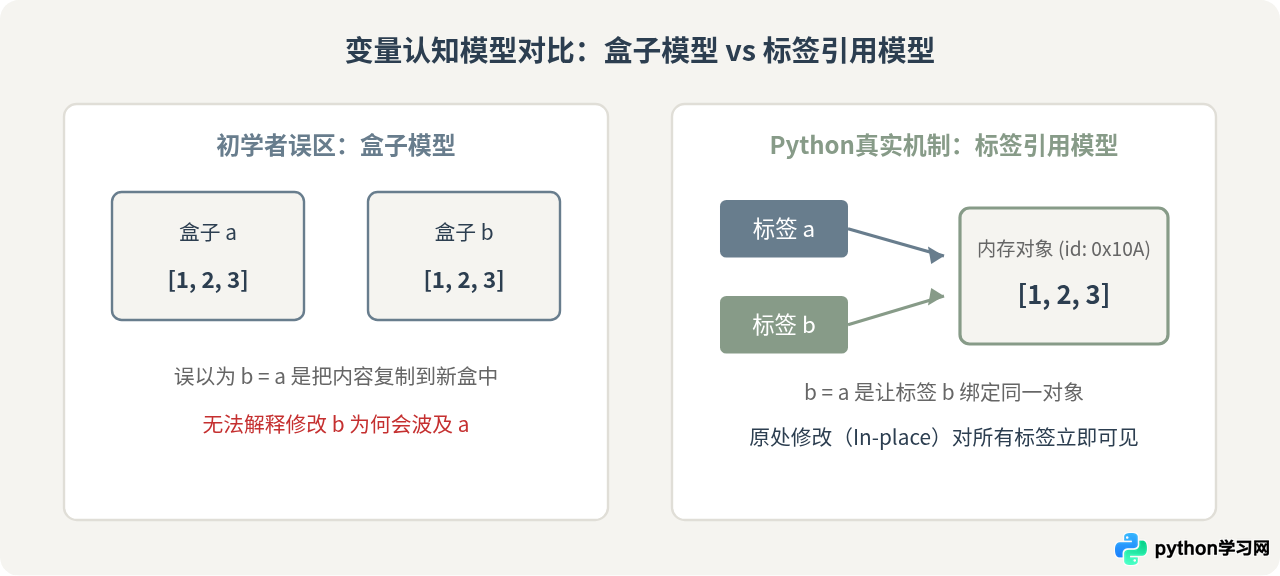
很多其他语言教学中常用“变量是一个存放数据的盒子”这一比喻,初学者习惯认为执行 a = 10 就是把数字 10 放进名为 a 的盒子。但在 Python 的实际底层架构中,所有数据都是堆内存中独立存在的“对象”,变量实质上是指向这些对象的“名字标签”(引用)。
理解这一机制对于排查数据篡改 Bug 至关重要。例如观察下面两段操作的显著差异:
# 场景一:直接赋值创建新引用与原处修改
a = [1, 2, 3]
b = a
b.append(4)
print(a)  # 输出示例:[1, 2, 3, 4]

# 场景二:重新赋值切断关联
x = [1, 2, 3]
y = x
y = [1, 2, 3, 4]
print(x) # 输出示例:[1, 2, 3]在场景一中,b = a 并没有开辟新的内存去复制一个列表,而仅仅是将名字标签 b 贴到了 a 目前所指的同一个列表对象上。当调用 b.append(4) 时,修改的是那个唯一的列表对象本体,因此通过 a 观察该对象也会看到修改结果。而在场景二中,y = [1, 2, 3, 4] 是创建了一个全新的列表对象,并将标签 y 撕下来贴到了新对象上,因此 x 指向的原对象不受任何影响。
二、可变类型与不可变类型:默认参数陷阱之源
在理解了标签引用的基础上,进一步划分数据类型是避坑的重中之重。Python 的内置类型严格划分为两大阵营:
- 不可变类型(Immutable):
int、float、str、tuple、bool等。一旦在内存中创建,其内部内容永远无法被改变。若对它们执行数学运算或拼接,Python 内部必然是创建新对象并重绑标签。 - 可变类型(Mutable):
list、dict、set等。支持在原内存地址上进行增加、删除或修改元素(如append()、pop())。
这一差异引出了 Python 初学者最经典的一个大坑——函数默认参数使用了可变对象。请看如下代码:
def add_item(item, target_list=[]):
    target_list.append(item)
    return target_list

print(add_item("苹果"))  # 输出示例:['苹果']
print(add_item("香蕉")) # 许多人以为是 ['香蕉'],实际输出:['苹果', '香蕉']原因剖析:Python 解释器在读取并执行 def add_item(...) 语句的那一瞬间(即函数定义期),就会对默认参数表达式求值,并创建一个唯一的空列表对象绑定在该函数对象的 __defaults__ 属性上。每次调用该函数且未传入该参数时,函数内部使用的都是这个早已创建好的常驻列表对象。因此,对它的修改会被永久保留下来。
避坑规范做法:永远使用不可变对象 None 作为占位哨兵值,在函数体内部进行动态判断与初始化:
def add_item_safe(item, target_list=None):
    if target_list is None:
        target_list = []  # 每次调用时独立新建一个列表对象
    target_list.append(item)
    return target_list

print(add_item_safe("苹果"))  # 输出示例:['苹果']
print(add_item_safe("香蕉"))  # 输出示例:['香蕉']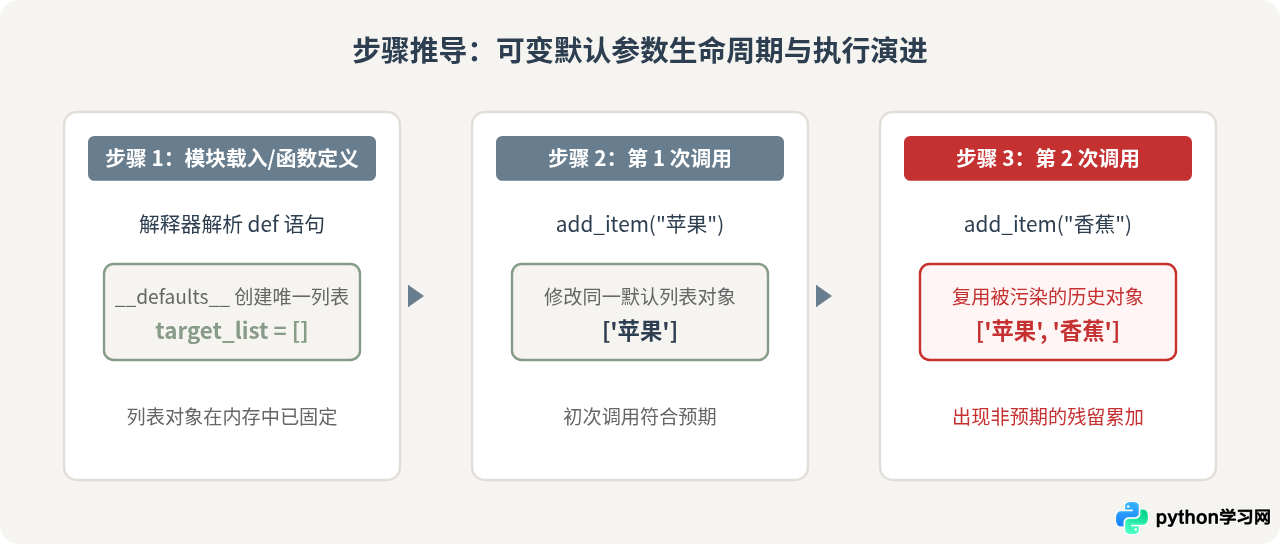
三、作用域与命名空间:LEGB 查找链与修改边界
在函数内部使用外部变量时,初学者经常遭遇 UnboundLocalError: local variable 'x' referenced before assignment。明明全局变量 x 就在上一行声明了,为什么函数内部访问还会报错?这需要理解 Python 的作用域查找规则 LEGB 以及变量绑定的静态判定机制。
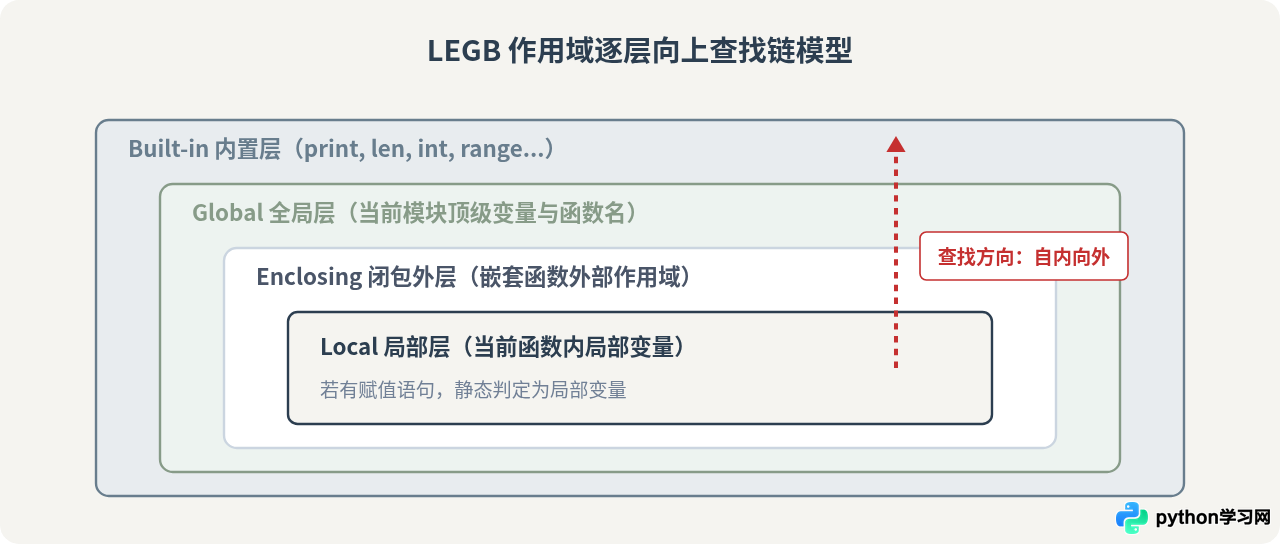
当 Python 寻找某个变量名称对应的对象时,会按照严格的先后次序逐层查找:
- L(Local):函数或方法内部的局部命名空间。
- E(Enclosing):嵌套函数中,外层闭包函数的命名空间。
- G(Global):当前模块文件的全局命名空间。
- B(Built-in):Python 自带的内置命名空间(如
len、print、range等)。
如果直到 B 层仍未找到,才会抛出 NameError。那么为什么下面这段代码会报错呢?
count = 10

def update_counter():
    print("当前计数:", count)  # 这里直接抛出 UnboundLocalError
    count = count + 1

update_counter()底层原因:Python 解释器在编译当前函数的作用域代码块时,会先静态扫描整个函数体。一旦发现函数体内存在 count = ... 的赋值语句,就会把 count 标记为当前函数的局部变量。因此,在执行到 print(count) 时,Python 根本不会向上去 Global 作用域寻找全局的 10,而是直接在 Local 作用域寻找,但此时 Local 的 count 尚未被赋值,于是抛出“引用了尚未赋值的局部变量”。
要修改全局变量,需显式声明 global count;在闭包中修改外层非全局变量,需使用 nonlocal。但在工程实践中,过多使用 global 会破坏函数的纯粹性,更推荐将状态作为参数传入并通过返回值传出。
四、迭代机制与生成器:从一次性加载到延迟求值
在处理列表和序列数据时,初学者最习惯的做法是使用列表推导式生成完整数据。然而,当数据量从几百条上升到几百万条时,这种写法往往会导致内存暴涨甚至触发操作系统 OOM(Out Of Memory)。
Python 处理大量数据的核心法宝是迭代器协议(Iterator Protocol)与生成器(Generator):
- 可迭代对象(Iterable):实现了
__iter__()方法,可以使用 for 循环遍历的对象,例如 list、dict、str。 - 迭代器(Iterator):实现了
__next__()方法,能够维持自身状态并逐个吐出下一个元素的对象。 - 生成器(Generator):带有
yield关键字的函数,或用圆括号包裹的生成器表达式(x for x in data)。
为了直观展现差异,我们对比在处理 1000 万个整数求和时的两种方式:
# 做法 A:列表推导式(急切求值,全量驻留内存)
# 内存消耗:创建拥有 1000 万个元素的列表,占用内存数百兆字节
total_a = sum([i * 2 for i in range(10_000_000)])

# 做法 B:生成器表达式(惰性求值/延迟计算)
# 内存消耗:极低,仅维持一个生成器状态指针,流式产生数据
total_b = sum(i * 2 for i in range(10_000_000))
生成器函数在遇到 yield 时会暂停执行并将计算结果返回,保存当前的寄存器与局部变量状态;直到下一次被 next() 调用时,才从暂停位置继续向下执行。这种“需要一个算一个”的特性,使程序在处理大日志文件读取、流式数据管道和无限序列时具备极高的高效性与鲁棒性。
五、模块导入与虚拟环境机制:摆脱依赖混乱
许多初学者的代码只在单个 .py 文件里运行,一旦开始拆分多文件、引入第三方开源库时,就会频繁遭遇两大痛点:一是跨文件导入报 ModuleNotFoundError 或重复执行,二是全局安装库版本冲突。
1. 理解 if __name__ == '__main__': 的本质
Python 中的每个模块文件都有一个内置属性 __name__。当该文件被直接在终端中运行(如 python script.py)时,解释器会自动将其 __name__ 设置为 "__main__";而当该文件作为模块被其他文件 import script 时,其 __name__ 则是它的文件名 "script"。这个条件分支的核心价值是:确保测试或主流程代码只有在直接运行本文件时才执行,作为模块导入时不被自动触发。
2. 导入路径查找规则:sys.path
Python 导入模块时不是在全盘搜索,而是按顺序遍历 sys.path 列表。该列表的第一个路径永远是当前启动脚本所在的目录。初学者常犯的错误是在子目录运行时试图直接导入同级其他子包,结果因为启动路径不同导致找不到模块。养成在项目根目录下通过模块模式运行(例如 python -m package.module)能够有效规避这一路径混乱。
3. 虚拟环境(venv)的必要性
绝不要在系统自带的全局 Python 环境下直接使用 pip install。不同项目依赖不同版本的库(例如项目 A 需要 requests==2.25.0,项目 B 需要 requests==2.31.0),全局安装必然互相覆盖。使用标准库的 venv 模块为每个项目创建独立隔离的环境,是专业开发者的必备习惯:
# 在项目根目录下创建独立虚拟环境
python3 -m venv .venv

# 激活虚拟环境(macOS/Linux)
source .venv/bin/activate

# 激活虚拟环境(Windows)
.venv\Scripts\activate

# 在隔离环境中安装依赖
pip install requests
六、5大核心概念避坑速查总结
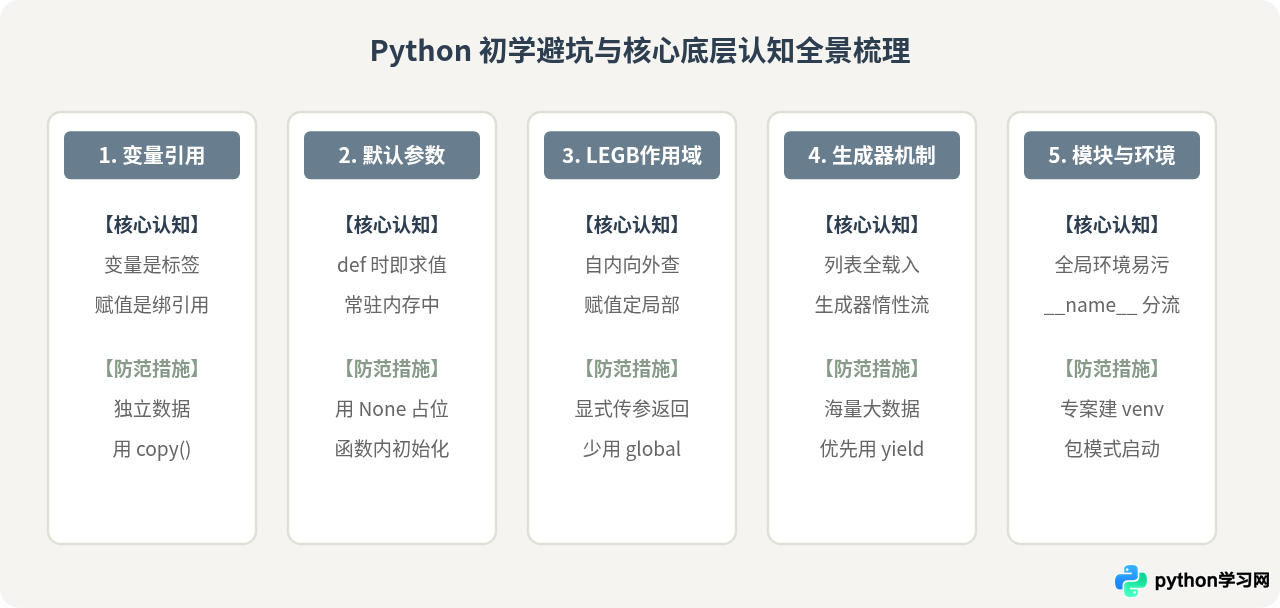
下表总结了这5个核心概念的常见误区与其对应的规范做法:
| 核心概念 | 常见误区与症状 | 规范做法与安全实践 |
|---|---|---|
| 变量引用 | 以为赋值是数据复制,原处修改意外污染其他变量 | 区分浅拷贝与深拷贝,明确原处修改与重新赋值的差异 |
| 默认参数 | 在 def 参数中直接写 lst=[] 导致历史数据残留 |
使用 None 作为哨兵值,在函数体内部动态初始化 |
| LEGB作用域 | 局部赋同名变量导致提前引用报 UnboundLocalError | 理清静态扫描机制,谨慎使用 global,优先通过传参与返回值通信 |
| 生成器机制 | 海量数据全部转成列表占用数百兆内存甚至 OOM | 改用 yield 生成器或生成器表达式,按需流式惰性计算 |
| 环境与导入 | 全局 pip 安装导致库冲突,跨模块导入路径混乱 | 使用 venv 隔离项目依赖,统一在项目根路径以 -m 模式启动 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









