

Python集合运算指南:怎么计算交集、并集、差集与对称差集
全面讲解Python中集合的交集、并集、差集与对称差集运算,对比重载运算符与内置方法的底层区别、原地更新技巧及工程实战避坑指南,配有精美文氏图与流程图。
set)是兼具高效性能与简洁语法的核心数据结构。计算交集、并集、差集与对称差集主要有两种途径:使用直观的重载运算符(&、|、-、^),或者调用内置的集合方法(.intersection()、.union()、.difference()、.symmetric_difference())。本文将直接梳理这四种运算的数学含义、具体代码实现、运算符与内置方法的底层差异,以及在工程实践中的性能与选型考量。
一、核心概念与四种集合运算的数学本质
在深入具体代码之前,需要明确 Python 集合的底层本质:set 是由哈希表(Hash Table)驱动的无序且无重复元素的数据容器。正因为哈希表的特性,在集合中检索某个元素是否存在的平均时间复杂度为 O(1),这使得集合运算在处理数以万计的数据筛选时,执行效率远高于嵌套循环的列表推导。
Python 提供的四种核心集合运算直接对应了经典离散数学中的集合操作:
- 交集(Intersection,数学记号 ∩):获取同时存在于两个集合中的公共元素,剔除所有单侧独有的项。
- 并集(Union,数学记号 ∪):将两个集合的所有元素合并,利用集合特性自动剔除重复项,得到两者的全集。
- 差集(Difference,数学记号 \ 或 -):从一个基准集合中扣除包含在另一个集合中的所有元素(具有明确的方向性,A 减 B 与 B 减 A 结果通常不同)。
- 对称差集(Symmetric Difference,数学记号 △):获取仅属于集合 A 或仅属于集合 B 的元素,即排除两者的公共重合部分,等价于“并集减去交集”。
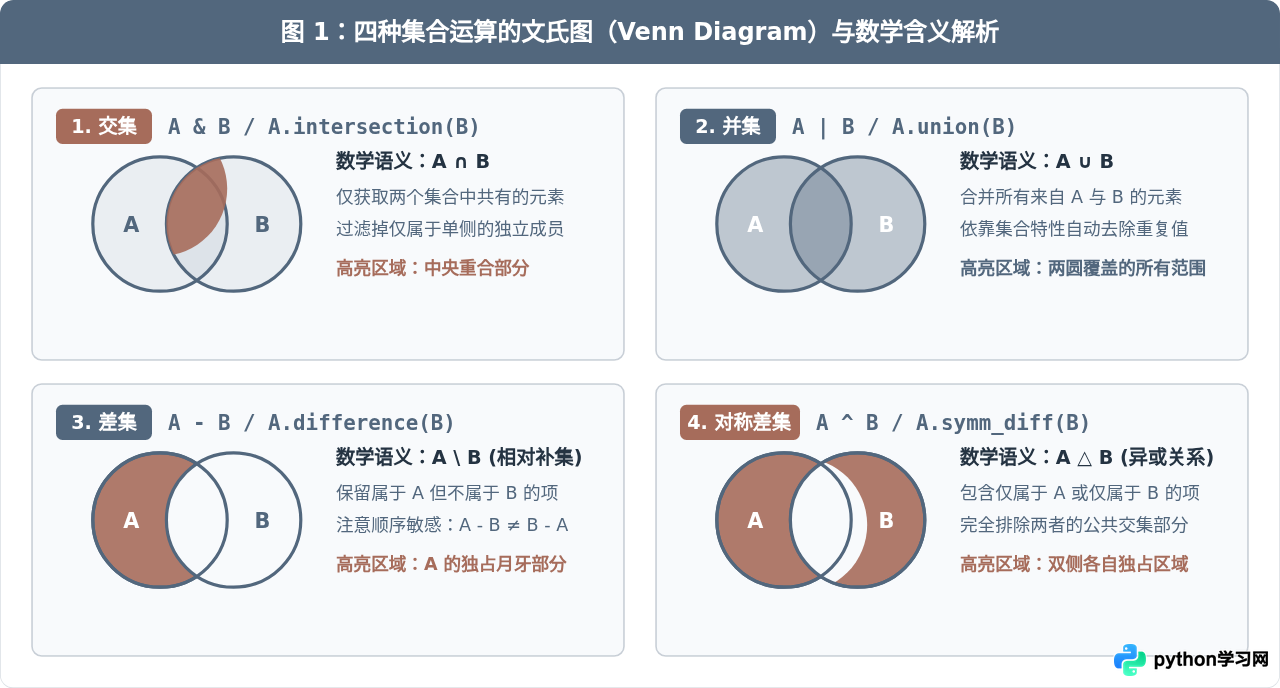
为了让初学者更直观地把握这四种关系,如上图所示,文氏图用两个重叠的圆形直观展示了不同运算所选取的取值区域。理解这四幅图的着色范围,就掌握了集合计算的全部逻辑核心。
二、四种基本运算的计算方法与完整示例
在 Python 代码中,每种集合运算都提供了“运算符”与“内置方法”两套对应的实现形式。以下我们通过具体业务场景和标准数据,逐一演练其调用方式与输出结果。
1. 交集运算:寻找共有元素
典型场景:查找同时开通了两个业务模块的付费用户、核对跨部门协作的共同责任人、提取双向好友列表。
语法:运算符 set_a & set_b 或方法 set_a.intersection(iterable)。
# 示例:查找两个部门共有员工名单
dev_team = {"Alice", "Bob", "Charlie", "David"}
ops_team = {"Charlie", "David", "Eva", "Frank"}

# 方式 1:使用重载运算符 &
common_members_op = dev_team & ops_team

# 方式 2:使用内置方法 intersection()
common_members_fn = dev_team.intersection(ops_team)

print("运算符求交集:", common_members_op)
print("方法求交集:", common_members_fn)方法求交集: {'Charlie', 'David'}
2. 并集运算:汇总全量去重
典型场景:多渠道访问用户 ID 合并、全量资产清点、多级分类标签聚合。
语法:运算符 set_a | set_b 或方法 set_a.union(iterable)。
# 示例:汇总两个推广渠道收集到的不重复客户邮箱
channel_a_emails = {"u1@test.com", "u2@test.com", "u3@test.com"}
channel_b_emails = {"u3@test.com", "u4@test.com", "u5@test.com"}

# 汇总并集
all_emails_op = channel_a_emails | channel_b_emails
all_emails_fn = channel_a_emails.union(channel_b_emails)

print("全量邮箱数量:", len(all_emails_op))
print("并集结果:", all_emails_op)并集结果: {'u1@test.com', 'u2@test.com', 'u3@test.com', 'u4@test.com', 'u5@test.com'}
3. 差集运算:定向排除指定项
典型场景:统计未按时提交周报的人员清单、筛选待补缴费用的客户、核对尚未分配工单的备件。
语法:运算符 set_a - set_b 或方法 set_a.difference(iterable)。
特别提醒:差集运算具有强烈的“方向性”。A - B 含义是“属于 A 但排除 B”,而 B - A 含义是“属于 B 但排除 A”。两者除非原本完全相等,否则计算结果必定不同。
# 示例:应到学生与实到学生比对
expected_students = {"Zhang", "Li", "Wang", "Zhao", "Qian"}
actual_students = {"Zhang", "Wang", "Zhao"}

# 计算缺席人员:expected 排除 actual
absent_students = expected_students - actual_students

# 反向计算:属于实际到场但不在应到名单中的异常人员
unexpected_students = actual_students - expected_students

print("缺席人员名单 (expected - actual):", absent_students)
print("未登记入场 (actual - expected):", unexpected_students)未登记入场 (actual - expected): set()
4. 对称差集运算:提取各自独有项
典型场景:双向数据同步中的差异检测、对比生产环境与测试环境的配置项变动、筛选仅参加了一场活动的独立用户。
语法:运算符 set_a ^ set_b 或方法 set_a.symmetric_difference(iterable)。
# 示例:对比两台服务器上开启的服务端口差异
server1_ports = {22, 80, 443, 8080}
server2_ports = {22, 80, 3306, 6379}

# 对称差集:找出仅在某一台服务器上开启的独有端口
port_diff_op = server1_ports ^ server2_ports
port_diff_fn = server1_ports.symmetric_difference(server2_ports)

print("仅单台开启的非公共端口:", port_diff_op)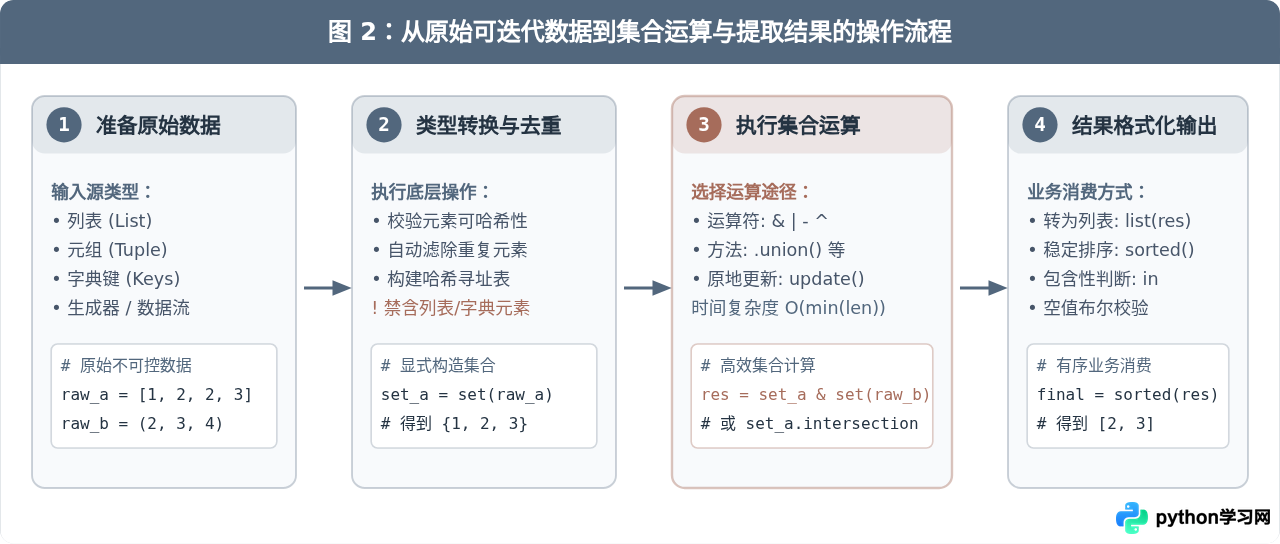
在实际生产代码中,原始数据往往并不是已经包装好的 set,而是来自于数据库查询的列表、网络请求返回的 JSON 数组或文件读取的行迭代器。如上图所示,规范的操作流程遵循“准备原始数据 → 转换为集合去重 → 执行选型运算 → 结果格式化输出”四个严谨步骤。
三、关键差异与进阶技巧:运算符与内置方法的核心区别
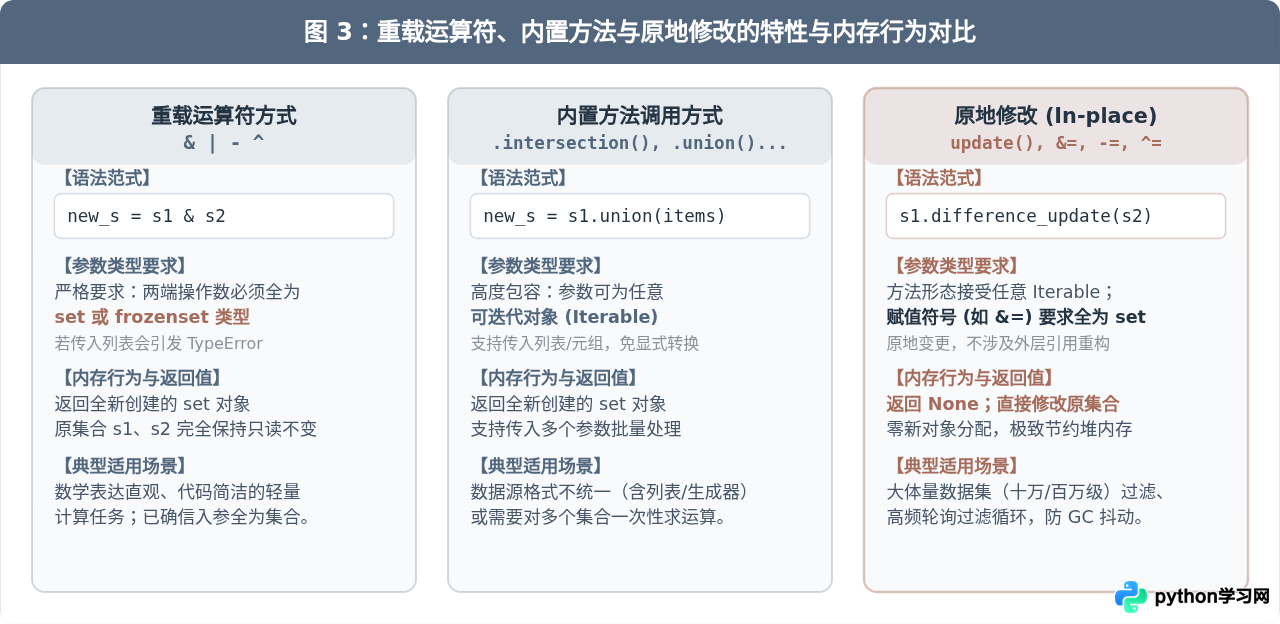
许多初学者常有疑问:既然 & 与 .intersection() 效果一致,为什么 Python 标准库要同时保留两套语法?实际上,这两者在入参类型宽容度、原地更新支持以及链式表达方面存在至关重要的区别。
1. 参数类型宽容度对比
重载运算符(&、|、-、^):严格要求运算符两端的所有操作数都必须是 set 或 frozenset 实例。如果一方是列表或元组,Python 解释器会直接抛出 TypeError: unsupported operand type(s) 异常。
内置方法(intersection、union 等):只要求主调对象(即点号前面的变量)是集合,而括号内的参数可以是任意可迭代对象(Iterable),包括列表、元组、字典键甚至生成器表达式。方法内部会自动将其视作集合进行匹配,省去了开发者显式编写 set(...) 转换的样板代码。
registered_users = {"alice", "bob", "charlie"}
csv_login_list = ["bob", "charlie", "david"]  # 这是一个普通的 list

# 错误用法:运算符无法直接与列表计算
# err = registered_users & csv_login_list  # 抛出 TypeError

# 正确用法 1:内置方法直接支持传入列表
valid_logins_fn = registered_users.intersection(csv_login_list)

# 正确用法 2:运算符必须显式先将列表转换为 set
valid_logins_op = registered_users & set(csv_login_list)

print("有效登录人员:", valid_logins_fn)2. 原地修改(In-place Mutation)与内存节约
在处理数据量庞大(如百万级元素)或者处于高频循环体内的集合时,每次运算如果都生成一个全新的集合对象,将频繁触发内存申请与垃圾回收(GC),造成显著的性能损耗。
Python 针对四种集合运算,分别提供了专用的“原地修改”方法与复合赋值运算符:
- 交集原地更新:
s.intersection_update(t)等价于s &= t - 并集原地更新:
s.update(t)等价于s |= t - 差集原地更新:
s.difference_update(t)等价于s -= t - 对称差集原地更新:
s.symmetric_difference_update(t)等价于s ^= t
所有原地修改方法的返回值均为 None!切忌写出形如 res = my_set.update(other) 的代码,这会导致 res 变为 None,并且原集合已经被修改。
3. 多集合批量运算
当需要对三个或更多的数据集进行聚合或交集计算时,内置方法支持一次性接收多个参数,内部以 C 级循环连续优化处理,代码更加整洁,也避免了产生过多的中间临时对象。
group1 = {1, 2, 3, 4, 5}
group2 = [3, 4, 5, 6]
group3 = (4, 5, 6, 7)
group4 = {5, 6, 7, 8}

# 使用内置方法:同时求四组数据的交集(只有 5 在所有组中存在)
all_common = group1.intersection(group2, group3, group4)

# 使用内置方法:同时合并四组数据
all_combined = group1.union(group2, group3, group4)

print("四组共同交集:", all_common)
print("四组合并并集元素数:", len(all_combined))四组合并并集元素数: 8
四、常见陷阱与避坑指南
1. 元素不可哈希(Unhashable Type)引发崩溃
集合要求所有被包含的元素必须是“可哈希”(Hashable)的,这意味着元素的值在其生命周期内不可变,并实现 __hash__() 协议。因此,列表(list)、字典(dict)以及普通集合(set)本身都不能作为集合的元素。
如果需要构建“包含集合的集合”,应使用不可变集合类型 frozenset;若需要包含序列,应使用不可变的元组(tuple)。
# 错误做法:包含列表会引发 TypeError
# bad_set = {[1, 2], [3, 4]}  # TypeError: unhashable type: 'list'

# 正确做法:使用不可变元组或 frozenset
valid_set_of_tuples = {(1, 2), (3, 4)}
valid_set_of_sets = {frozenset([1, 2]), frozenset([3, 4])}
2. 空集合声明的语法误区
在 Python 中,一对空的大括号 {} 默认用于创建空字典(dict),而非空集合。若要初始化一个真正的空集合,必须显式调用构造器函数 set()。
empty_var = {}
print("类型判断 empty_var:", type(empty_var))  # <class 'dict'>

real_empty_set = set()
print("类型判断 real_empty_set:", type(real_empty_set))  # <class 'set'>
3. 集合元素的无序性与确定性输出
集合内部元素依赖哈希分布,迭代输出的顺序由底层散列表桶位置决定,并且可能因 Python 版本的哈希随机种子(Hash Randomization)在不同运行实例中略有差异。因此,在需要将集合运算结果用于打印报告、持久化存储或顺序依赖的断言测试时,必须使用 sorted() 显式排序并转换为列表。
五、总结与工程选型速查表
综合以上分析,在实际 Python 研发与数据处理流程中,推荐对照下表快速选择最适宜的集合计算方案:
| 运算类型 | 符号写法 | 方法写法 | 原地修改写法 | 核心核心逻辑 |
|---|---|---|---|---|
| 交集 | A & B | A.intersection(B) |
A &= B 或 A.intersection_update(B) |
仅提取两方重合共有的元素 |
| 并集 | A | B | A.union(B) |
A |= B 或 A.update(B) |
聚合所有成员并自动过滤重复 |
| 差集 | A - B | A.difference(B) |
A -= B 或 A.difference_update(B) |
以 A 为基准排除所有包含在 B 中的项 |
| 对称差集 | A ^ B | A.symmetric_difference(B) |
A ^= B 或 A.symmetric_difference_update(B) |
提取各自独占的元素,剔除所有公共交集 |
黄金选型准则:
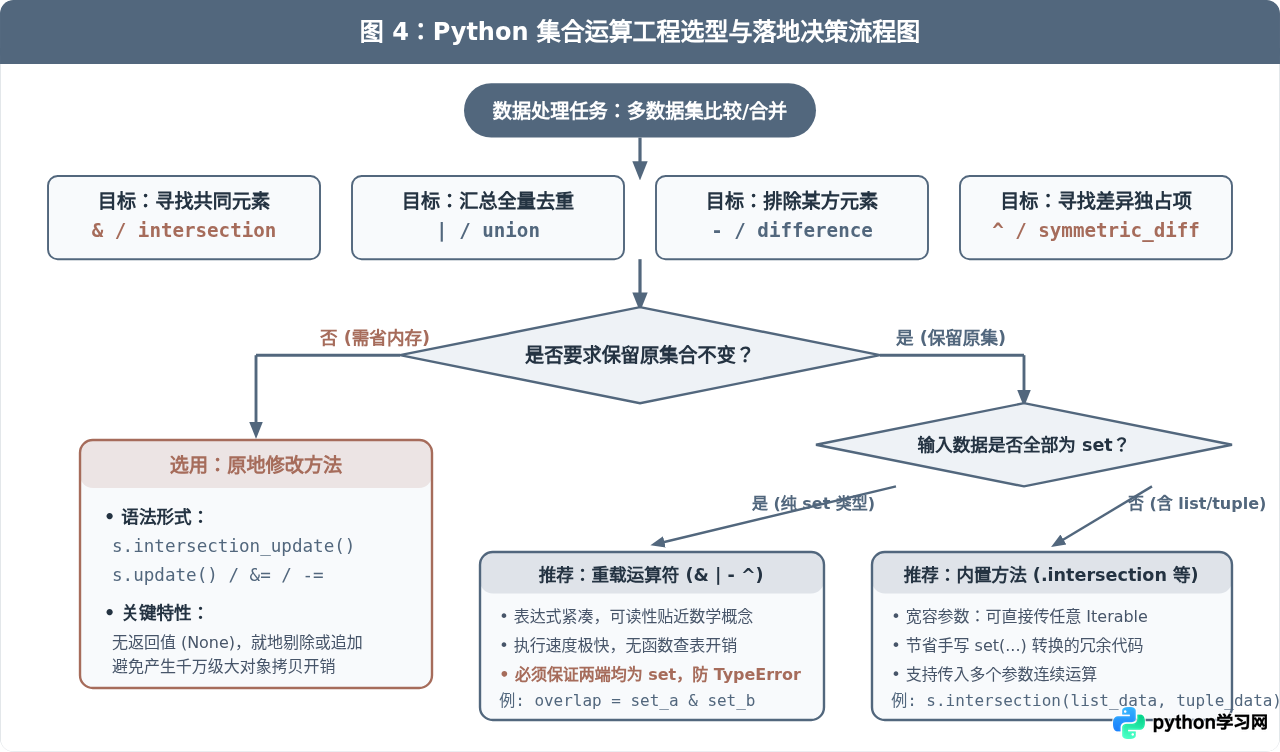
如果在简单清晰的算法逻辑或数学模型中,且入参已被保证全为 set,推荐优先采用重载运算符(&、|、-、^),代码直观紧凑;
当处理上游来源复杂的原始数据(掺杂列表、生成器),或需要对三组以上数据进行批处理时,首选内置方法;
对于百万级日志流、大规模特征工程等极端性能敏感或内存紧缺的场景,务必使用原地更新方法以规避对象分配开销。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









