

怎么使用@pytest.mark.parametrize实现pytest参数化测试
详细讲解如何使用 @pytest.mark.parametrize 装饰器实现 pytest 参数化测试,涵盖单参数、多参数、自定义测试用例ID、笛卡尔积组合以及 pytest.param 细粒度标记等核心用法与工程避坑实践。
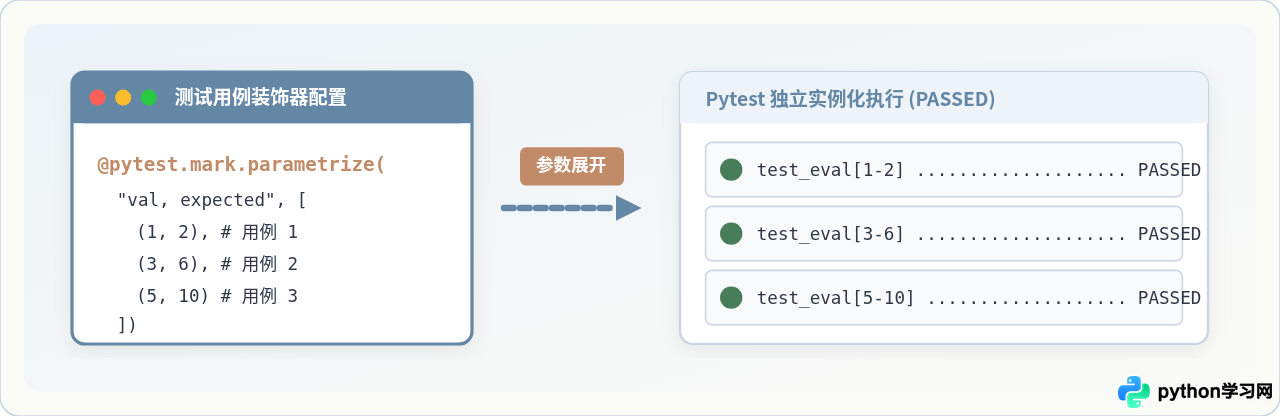
for 循环遍历数据集,一旦某一组数据断言失败,整个循环就会中断退出,导致后续用例无法执行。@pytest.mark.parametrize 正是解决这一问题的核心工具:它在测试收集阶段将数据集解包,自动生成互相隔离的测试用例实例,确保每个参数组合独立运行、独立报错。
一、参数化测试的核心机制与基础语法
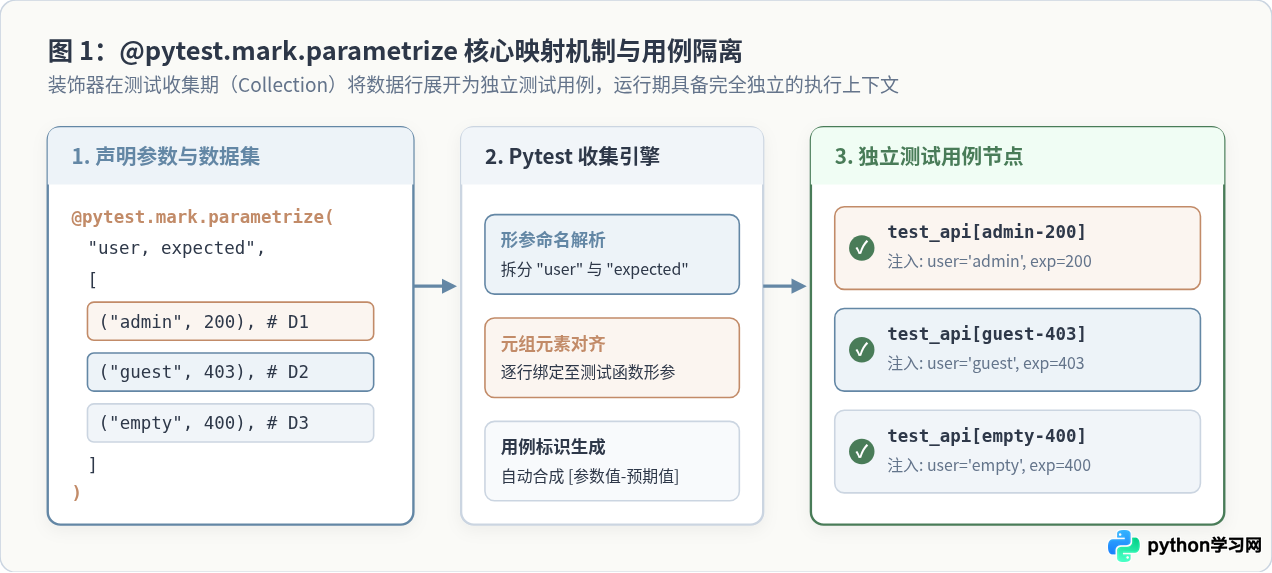
pytest 参数化的本质是在测试执行前的用例收集阶段(Collection Phase),由框架读取装饰器中定义的数据集,根据数据项的数量动态构建对应数量的测试用例描述符(Test Items)。每个生成的用例拥有唯一的节点标识(Node ID),在测试报告中以单独的条目呈现。
使用 @pytest.mark.parametrize 时,最基础的调用必须传入两个核心参数:
argnames(参数名字符串或列表):指定要注入到测试函数中的形参名称,多个参数可用英文逗号分隔(如"input_val, expected"),或者传入字符串列表(如["input_val", "expected"])。argvalues(数据列表):包含具体测试数据的可迭代对象(通常是列表)。对于单参数,列表中为具体数据值;对于多参数,列表中每个元素通常为包含对应字段的元组(Tuple)。
单参数基础示例
假设我们需要验证一个字符串清洗函数 is_valid_username,测试不同的非法输入是否均能被识别:
import pytest

def is_valid_username(name):
    # 用户名规则:长度在 4 到 16 位之间的非空字母字符串
    if not isinstance(name, str):
        return False
    return 4 <= len(name) <= 16 and name.isalpha()

# 使用单参数参数化测试多个非法输入
@pytest.mark.parametrize("invalid_name", [
    "",           # 空字符串
    "abc",        # 长度不足 4 位
    "admin_123",  # 包含非字母下划线与数字
    "toolongusernamethatexceedssixteen",  # 超长字符串
    None,         # 非字符串类型
])
def test_invalid_username(invalid_name):
    assert is_valid_username(invalid_name) is False
在终端执行 pytest -v 后,pytest 不会将上述代码当作 1 个测试执行,而是自动将其展开为 5 个相互独立的测试用例:
test_demo.py::test_invalid_username[] PASSED
test_demo.py::test_invalid_username[abc] PASSED
test_demo.py::test_invalid_username[admin_123] PASSED
test_demo.py::test_invalid_username[toolongusernamethatexceedssixteen] PASSED
test_demo.py::test_invalid_username[None] PASSED
每个测试用例名称后方自动追加了方括号 [...],里面标明了当前测试所注入的具体参数值。即使其中某一个输入断言失败,其余 4 个用例仍会照常运行并汇报结果。
二、多参数联动与元组解包
在绝大多数真实业务测试中,输入通常不止一个,并且往往需要同时提供“预期结果”或“错误码”。此时需要同时定义多个参数名,并在数据集合中使用元组进行 1:1 的数据对齐。
argnames 可以用英文逗号分隔的字符串表示(如 "a, b, expected"),也可以使用列表 ["a", "b", "expected"];而 argvalues 中的每一个子元素必须是一个包含相同数量元素的元组或列表。pytest 会自动执行序列解包,把第 1 个元素赋值给 a,第 2 个赋值给 b,第 3 个赋值给 expected。
import pytest

def calculate_discount(price: float, member_level: str) -> float:
    discount_map = {"regular": 1.0, "silver": 0.9, "gold": 0.8}
    discount = discount_map.get(member_level, 1.0)
    return round(price * discount, 2)

# 多个参数联动:原价、会员等级、预期折后金额
@pytest.mark.parametrize("price, member_level, expected", [
    (100.0, "regular", 100.0),
    (100.0, "silver", 90.0),
    (100.0, "gold", 80.0),
    (250.5, "gold", 200.4),
    (100.0, "unknown_vip", 100.0),  # 未知等级按原价计算
])
def test_calculate_discount(price, member_level, expected):
    result = calculate_discount(price, member_level)
assert result == expectedargnames 声明的形参个数完全一致。如果参数名为 3 个,而数据列表中某个元组只提供了 2 个值,pytest 会在用例收集期直接抛出 ValueError: ... values were not the same length as ... parameters 异常,测试无法启动。
三、单装饰器多参数 vs 叠加装饰器(笛卡尔积)
除了单个装饰器中定义多个参数外,pytest 允许在同一个测试函数上连续堆叠多个 @pytest.mark.parametrize 装饰器。这两种写法的数学行为与应用场景截然不同:
- 单装饰器多参数(1:1 配对):每个元组是一行独立的业务测试数据。如果有 3 行元组,最终就运行 3 个用例。各参数间是强关联、严格绑定的。
- 多装饰器堆叠(笛卡尔积组合):每个装饰器负责一个维度的入参。pytest 会将它们进行全排列交叉组合。如果有两个装饰器,数据量分别为 M 和 N,则最终生成的测试用例数量为
M × N。
import pytest

# 叠加两个装饰器:测试两种用户类型在三种状态下的鉴权表现
@pytest.mark.parametrize("role", ["admin", "editor"])
@pytest.mark.parametrize("status", ["active", "suspended", "pending"])
def test_user_matrix(role, status):
    # 总共生成 2 * 3 = 6 个独立测试
    assert len(role) > 0 and len(status) > 0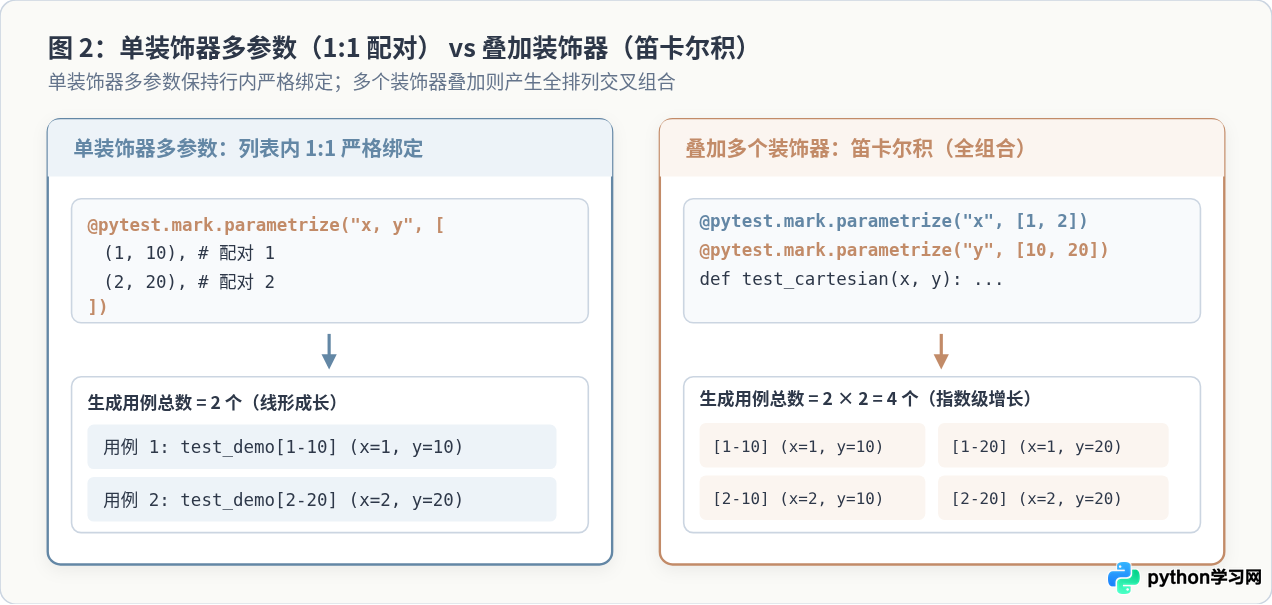
5 × 5 × 5 = 125 个测试用例。如果测试函数涉及数据库操作、HTTP 外部请求等重型耗时调用,笛卡尔积会极易导致测试执行时间呈爆炸式增长。除非确实需要进行跨维度的组合兼容性验证,否则应优先使用单装饰器 1:1 明确配对。
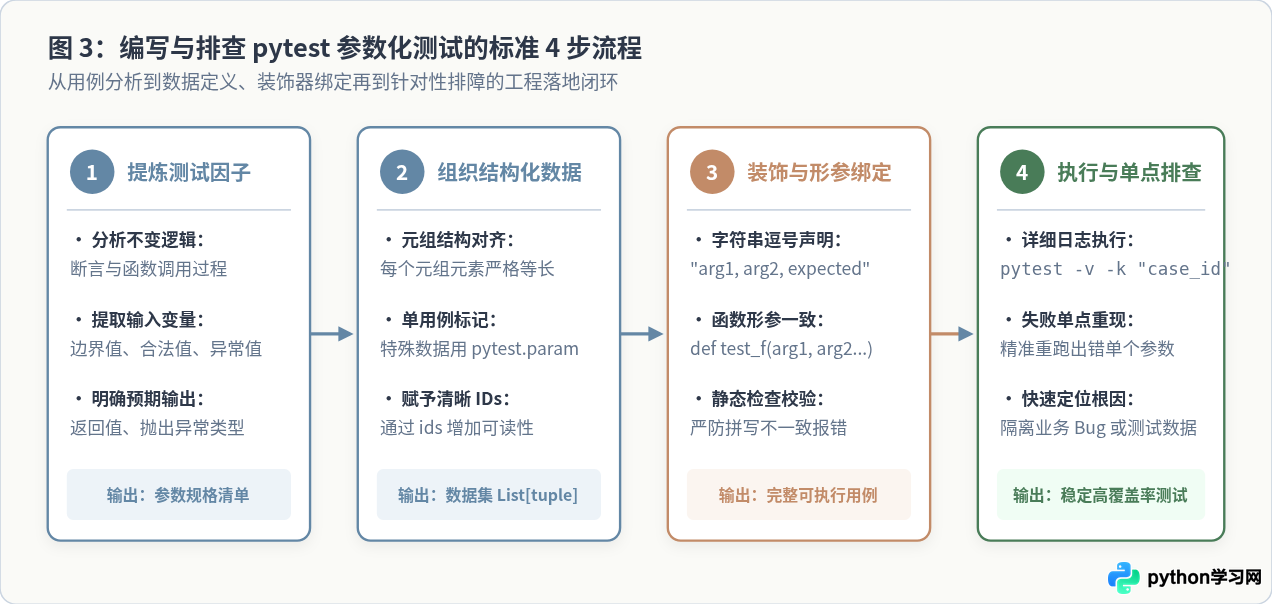
四、编写与调试参数化测试的标准步骤
在实际工程项目中落地参数化测试,建议遵循以下标准四步流程:
| 阶段 | 核心任务 | 输入 / 操作 | 预期产出 |
|---|---|---|---|
| 第 1 步:提炼因子 | 区分固定业务断言逻辑与可变输入数据 | 识别边界值、极端值与非法输入 | 参数名与期望值清单 |
| 第 2 步:组织数据 | 将数据整理为标准元组列表 | 构造 List[Tuple],对异常用例打标 |
结构化数据集 |
| 第 3 步:绑定装饰器 | 配置参数名并保持与函数形参完全一致 | 编写 @pytest.mark.parametrize |
就绪的测试用例代码 |
| 第 4 步:执行与调试 | 运行 pytest 并针对单个失败项精准重跑 | pytest -v -k "case_name" |
通过验证的高覆盖率测试 |
调试技巧:利用 Node ID 精准复现失败单条用例
当参数化测试包含 50 组数据时,如果第 37 组数据失败,千万不要重新运行整个套件。可以复制 pytest 报错日志中的用例后缀标识,使用 -k 选项仅运行该特定用例:
# 仅运行包含特定参数值的单条用例进行断点调试
pytest test_demo.py -v -k "admin_123"
五、进阶技巧:ids 自定义用例标识与 pytest.param 细粒度标记
1. 使用 ids 提升用例可读性与解决中文乱码
默认情况下,pytest 会将参数的 str() 结果作为用例标识。如果参数包含复杂对象、超长文本或者非 ASCII 字符(如中文),测试控制台可能显示为十六进制转义符(如 中文)或难以辨认的长字符串。
此时可以通过 ids 参数显式指定每个测试用例的名称。ids 既可以是一个字符串列表,也可以是一个接受单个参数返回字符串的 Callable 函数。
import pytest

# 方式 A:直接提供与数据行等长的字符串列表
@pytest.mark.parametrize(
    "user_id, expected_role",
    [
        (1, "super_admin"),
        (2, "editor"),
        (99, "guest"),
    ],
    ids=["root-user", "normal-editor", "anonymous-visitor"]
)
def test_user_permission(user_id, expected_role):
    assert get_role(user_id) == expected_role
执行时,pytest 显示的测试项将清晰直观:
test_user_permission[root-user] PASSED
test_user_permission[normal-editor] PASSED
test_user_permission[anonymous-visitor] PASSED
如果数据集动态产生,无法预先写死 ids 列表,可以传入自定义函数:
def id_generator(val):
    if isinstance(val, dict):
        return f"payload_{val.get('action')}"
    return str(val)

@pytest.mark.parametrize("payload", [{"action": "create"}, {"action": "delete"}], ids=id_generator)
def test_action_dispatch(payload):
    ...
2. 使用 pytest.param 为特定数据行打标签
有时某一组测试数据由于已知未修复的 Bug 暂时无法通过,或者该用例在特定操作系统上需要被跳过。如果直接在整个测试函数上标注 @pytest.mark.xfail,会导致所有参数组合都被标记为预期失败,掩盖了其他正常用例的退化。
通过 pytest.param(*values, id=None, marks=()),我们可以精准对单行数据施加标签或单独定义 ID:
import sys
import pytest

@pytest.mark.parametrize("ip, expected", [
    pytest.param("127.0.0.1", True, id="ipv4_loopback"),
    pytest.param("192.168.1.1", True, id="ipv4_lan"),
    # 仅针对此条已知 Bug 数据标记为预期失败 (xfail)
    pytest.param(
        "::1", True,
        id="ipv6_loopback",
        marks=pytest.mark.xfail(reason="IPv6 module refactor pending (BUG-1042)")
    ),
    # 仅在非 Windows 环境下跳过此用例
    pytest.param(
        "invalid_ip_format", False,
        id="malformed_str",
        marks=pytest.mark.skipif(sys.platform == "win32", reason="Windows parser diff")
    ),
])
def test_ip_validator(ip, expected):
    assert validate_ip(ip) == expected
六、与 Fixture 联动:使用 indirect 间接参数化
通常情况下,参数化传递的数据直接注入到测试函数的参数中。但在复杂的集成测试中,测试函数往往依赖 pytest.fixture 来完成初始化工作(例如连接数据库、创建临时文件或生成带有特定权限的用户会话)。
通过在 @pytest.mark.parametrize 中设置 indirect=True,pytest 会将参数传递给同名的 Fixture,由 Fixture 在内部通过 request.param 提取参数,进行资源准备并返回组装后的对象给测试函数。
import pytest

# 声明一个夹具,接收参数并动态创建资源
@pytest.fixture
def database_connection(request):
    db_type = request.param
    # 前置设置:依据参数初始化不同数据库实例
    conn = {"type": db_type, "status": "connected"}
    yield conn
    # 后置清理
    conn["status"] = "closed"

# 使用 indirect 指定 database_connection 参数先通过夹具处理
@pytest.mark.parametrize(
    "database_connection, query",
    [
        ("sqlite", "SELECT 1"),
        ("postgres", "SELECT 1"),
    ],
    indirect=["database_connection"]  # 仅该参数由夹具消费,query 仍作为普通参数直传
)
def test_db_query(database_connection, query):
    assert database_connection["status"] == "connected"
    assert len(query) > 0
七、高频避坑要点
- 形参与参数名拼写不一致:
@pytest.mark.parametrize("param_a", [...])中的param_a必须与测试函数定义中的def test_func(param_a):字符完全一致。若拼写有偏差,pytest 会误以为该形参是未定义的 fixture,从而报错fixture 'param_a' not found。 - 单参数字符串未加引号或多写逗号:传单参数时,很多初学者误写成
@pytest.mark.parametrize("val,", [1, 2]),末尾多出的逗号会导致 pytest 将其识别为两个参数名称(其中第 2 个参数名为空字符串),从而产生结构解包异常。 - 在数据集内复用可变默认对象:如果测试数据列表中直接放入了可变字典或列表
([{'counter': 0}]),由于 Python 模块加载时列表只初始化一次,当某一个用例在执行过程中就地修改了该字典内容(counter += 1),后续用例执行时接收到的将是被污染后的脏数据,导致用例间出现非预期的耦合。建议使用只读元组,或在测试函数内部执行深拷贝。 - 中文字符集显示转义:在 pytest 6 及以前版本中,中文 ids 会默认被转义显示为 ASCII。若要保持控制台和报告中正常呈现中文,可在项目根目录的
pytest.ini中增加配置项:[pytest] disable_test_id_escaping_and_forfeit_all_rights_to_community_support = true
八、全景特性与场景选型总结
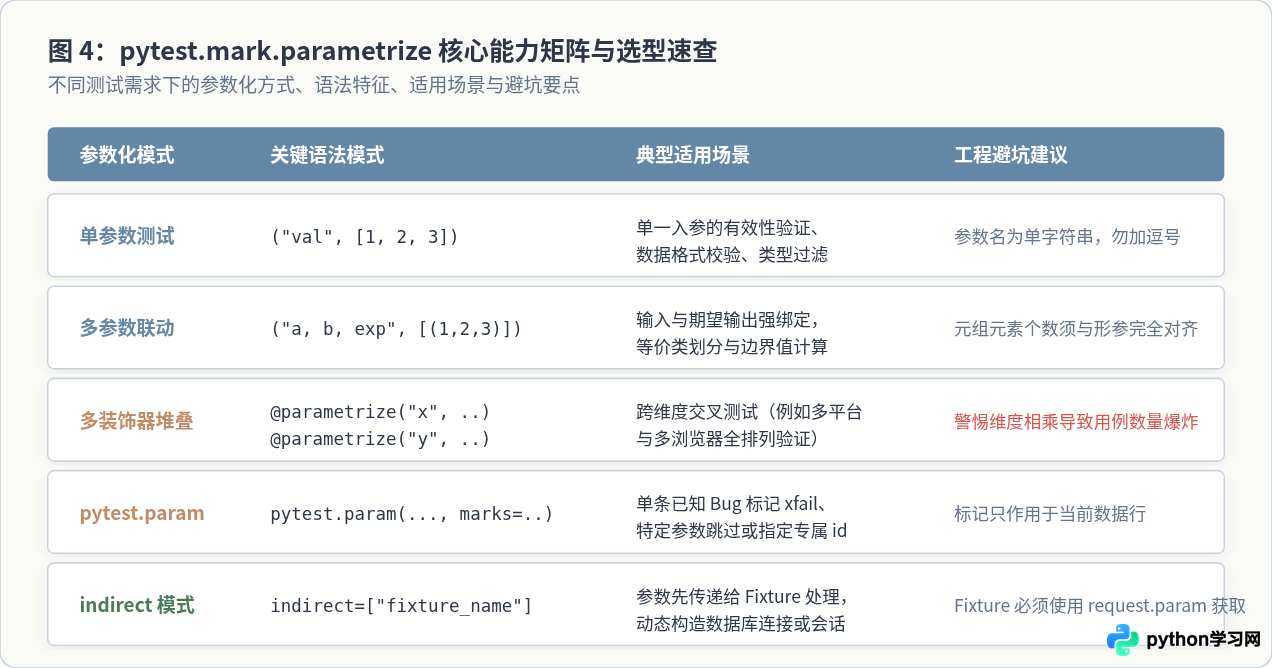
@pytest.mark.parametrize 是编写整洁、健壮且易于扩展的自动化测试用例的基础工具。通过合理选用单参数、多参数、自定义 ids、单用例标记以及 indirect 夹具模式,可以有效覆盖大部分输入边界与组合场景。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









