

Python批量读取文件夹内CSV并分别生成新文件
详细讲解如何使用Python批量读取指定文件夹内的所有CSV文件,完成数据清洗与转换后,分别输出为独立的新文件。包含pathlib与pandas标准实现、内置csv流式处理、中文编码与异常隔离等实战技巧。
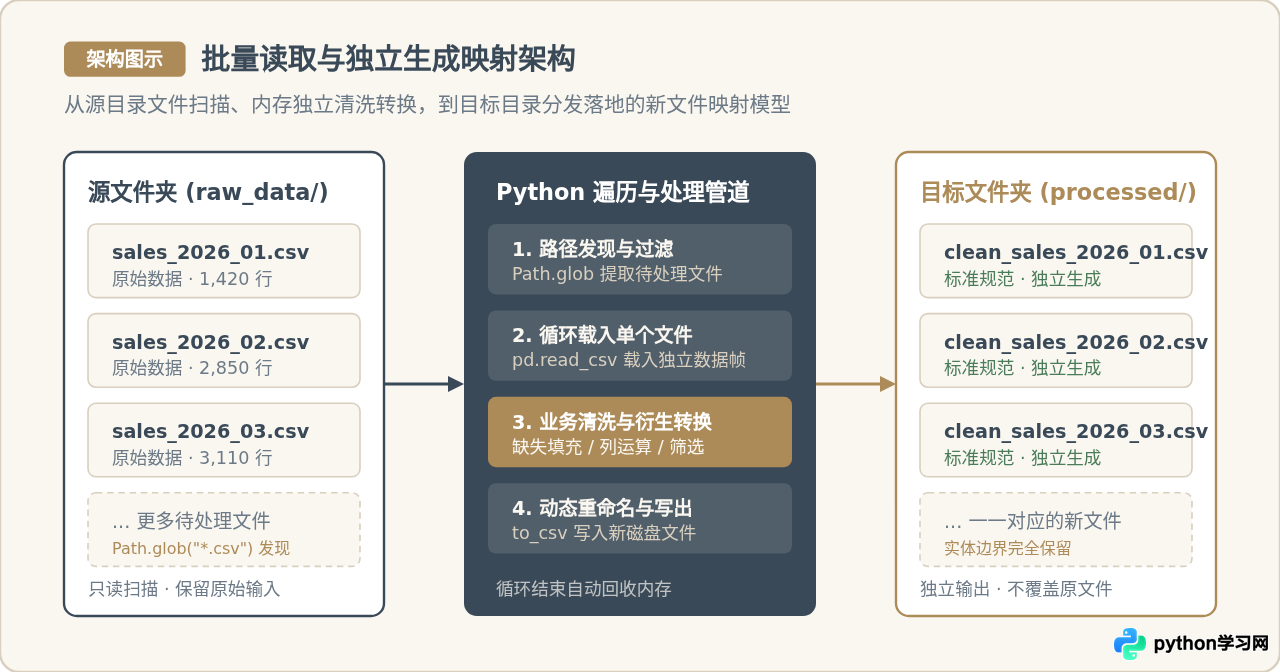
pathlib 扫描目标文件夹中的全部 CSV 文件路径;在循环中逐一读取单个文件内容;在内存中执行清洗与加工;随后动态构建新文件名与目标路径;最后分别写出到新的磁盘目录中。本文将通过详尽的代码与典型场景,带你掌握这一标准流程与生产级容错设计。
一、批处理架构与输入输出路径设计
许多刚接触批处理的开发者容易把“批量处理”误写为“将所有文件合并成一个大文件”。虽然数据合流也是常见需求,但“分别生成新文件”承担着完全不同的业务使命:
- 业务边界隔离:例如按天存储的销售流水、各分支机构的财务对账单或不同物联网传感器的采集日志,数据本身具有天然的物理隔离属性,下游系统往往要求维持原有的分块结构。
- 内存平稳受控:逐个读取并分别输出,意味着每个循环结束后当前文件占用的内存就可以被立即释放,即便文件夹中总共有上千个文件,也不会导致内存持续暴涨。
- 追溯与可恢复性:单文件独立生成新文件时,若中途某个文件因数据异常报错,已生成的文件完好无损,且便于排查是哪一个具体输入导致了异常。
二、方案一:基于 pathlib 与 pandas 的标准处理方案
在进行中等规模数据清洗时(单文件通常在几 MB 到几百 MB 之间),推荐使用标准库 pathlib 结合第三方数据分析库 pandas。pathlib.Path 提供了跨操作系统的路径操作语义,而 pandas 则拥有极为丰富的矢量化数据变换能力。
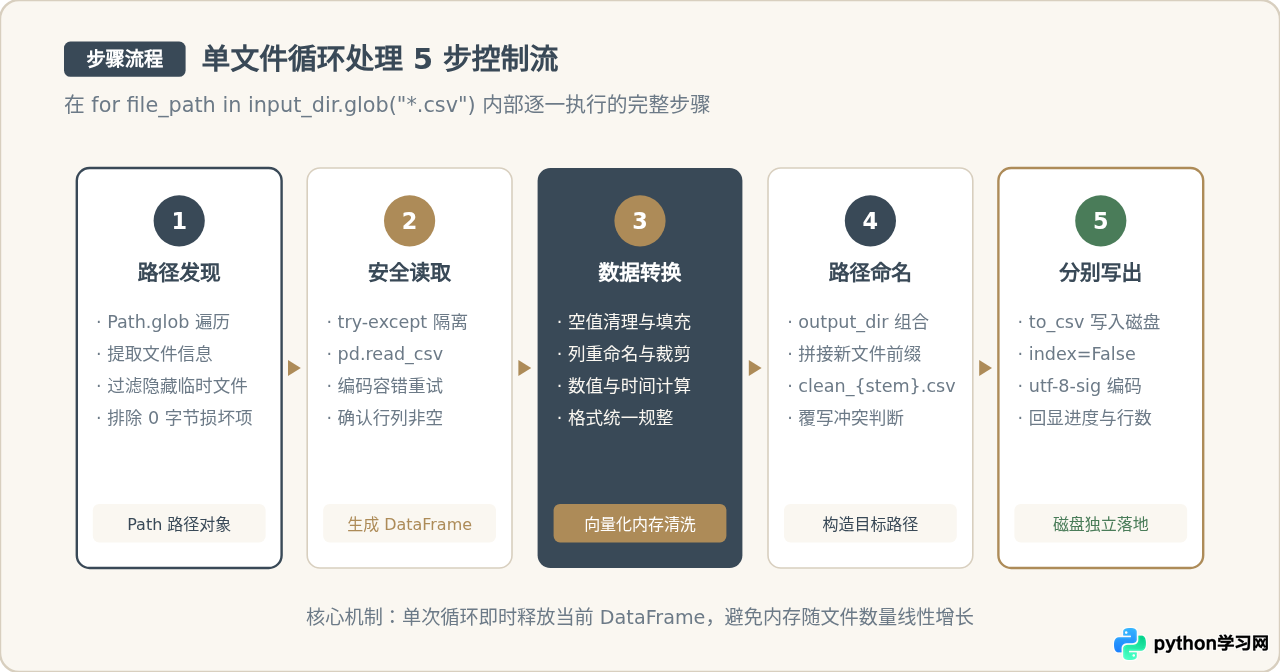
1. 关键步骤解析
- 确定目录与自动创建:使用
Path("raw_data")定义输入目录,使用Path("processed_data")定义输出目录。在执行任何写入前,调用output_dir.mkdir(parents=True, exist_ok=True),确保目标目录真实存在,避免因目录不存在而抛出FileNotFoundError。 - 路径遍历:通过
input_dir.glob("*.csv")遍历所有匹配的 CSV 文件。如果只需要当前层级,使用glob;如果需要递归遍历子文件夹中的 CSV,可以使用rglob("*.csv")。 - 构建对应的新文件名:借助
file_path.name(包含后缀的文件名)或file_path.stem(纯文件名),可以灵活地构造输出路径。例如output_dir / f"clean_{file_path.stem}.csv"。 - 读取与数据转换:调用
pd.read_csv()读取,执行需要的业务逻辑(例如删除空行、重命名列、时间格式标准化、增加计算列等)。 - 分别写出与索引处理:调用
df.to_csv(out_path, index=False, encoding="utf-8-sig")落地文件,务必设置index=False避免自动多出一列无意义的自增索引。
2. 完整实现代码(pandas 版)
以下代码假设我们需要对 raw_data/ 文件夹内的所有销售表格进行处理,统一剔除包含缺失订单号的无效记录,增加一列计算“总金额 = 单价 * 数量”,并将处理结果保存到 processed_data/ 文件夹中,文件名前缀加上 clean_:
from pathlib import Path
import pandas as pd

def batch_process_csv_pandas(source_folder: str, target_folder: str, prefix: str = "clean_") -> None:
    """
    批量读取 source_folder 内所有 CSV 文件,清洗转换后分别生成新文件至 target_folder。
    """
    src_path = Path(source_folder)
    dst_path = Path(target_folder)

    # 1. 确保源目录存在
    if not src_path.is_dir():
        print(f"[错误] 源目录不存在: {src_path}")
        return

    # 2. 确保目标目录已创建
    dst_path.mkdir(parents=True, exist_ok=True)

    # 3. 扫描全部 CSV 文件(不包含隐藏临时文件)
    csv_files = [f for f in src_path.glob("*.csv") if not f.name.startswith(".")]

    if not csv_files:
        print(f"[提示] 未在 {src_path} 下找到任何 CSV 文件")
        return

    print(f"[开始] 发现 {len(csv_files)} 个 CSV 文件,准备开始批量处理...")

    success_count = 0
    fail_count = 0

    for idx, file_path in enumerate(csv_files, start=1):
        # 构造新文件名与完整目标路径
        new_filename = f"{prefix}{file_path.name}"
        output_file = dst_path / new_filename

        try:
            # 读取原始 CSV,指定 utf-8-sig 以兼容各平台
            df = pd.read_csv(file_path, encoding="utf-8-sig")

            # --- 业务转换逻辑开始 ---
            # 示例 1: 剔除关键列存在缺失的脏数据
            if "order_id" in df.columns:
                df = df.dropna(subset=["order_id"])

            # 示例 2: 若包含单价与数量列,计算总金额
            if "unit_price" in df.columns and "quantity" in df.columns:
                df["total_amount"] = df["unit_price"] * df["quantity"]

            # 示例 3: 新增数据处理时间批次标记
            df["processed_at"] = pd.Timestamp.now().strftime("%Y-%m-%d %H:%M:%S")
            # --- 业务转换逻辑结束 ---

            # 分别保存为独立的新文件,不写入额外索引
            df.to_csv(output_file, index=False, encoding="utf-8-sig")

            success_count += 1
            print(f"[{idx}/{len(csv_files)}] 成功: {file_path.name} -> {output_file.name} (共 {len(df)} 行)")

        except Exception as exc:
            fail_count += 1
            print(f"[{idx}/{len(csv_files)}] 失败: {file_path.name},原因: {exc}")

    print(f"\n[完成] 批量生成任务结束。成功: {success_count} 个,失败: {fail_count} 个。")

# 执行示例
if __name__ == "__main__":
    batch_process_csv_pandas("raw_data", "processed_data", prefix="clean_")
[开始] 发现 3 个 CSV 文件,准备开始批量处理...
[1/3] 成功: sales_2026_01.csv -> clean_sales_2026_01.csv (共 1412 行)
[2/3] 成功: sales_2026_02.csv -> clean_sales_2026_02.csv (共 2840 行)
[3/3] 成功: sales_2026_03.csv -> clean_sales_2026_03.csv (共 3105 行)

[完成] 批量生成任务结束。成功: 3 个,失败: 0 个。
三、方案二:基于 Python 原生 csv 模块的轻量流式处理
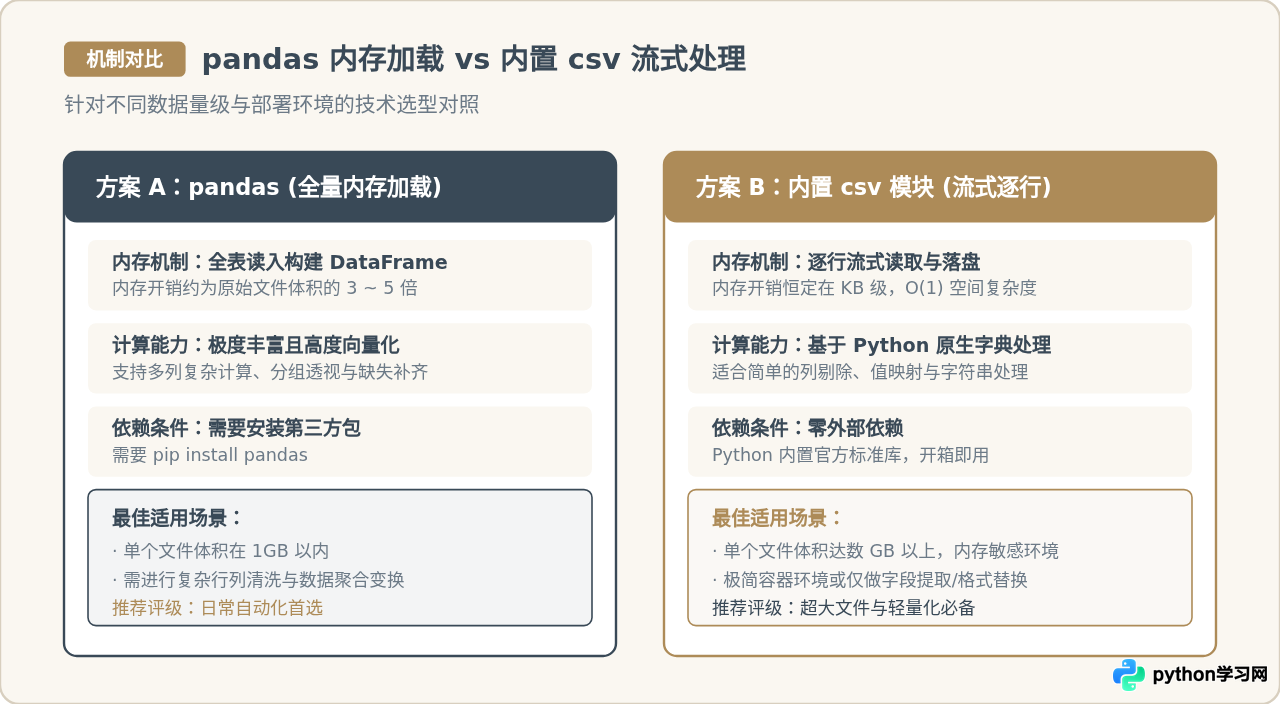
在某些特定场景下,我们可能无法或不需要使用 pandas。例如:在受限的生产服务器或容器环境中不允许安装庞大的第三方依赖;或者单个 CSV 文件非常庞大(单个文件达到 5GB~20GB),直接使用 pandas.read_csv() 会因内存不足(OOM)直接导致程序崩溃。
此时,Python 官方标准库自带的 csv 模块便成为最佳方案。通过 csv.DictReader 和 csv.DictWriter,我们可以实现“边读单行、边清洗、边写出新文件”的纯流式模型,内存占用始终恒定在几 KB 左右。
完整实现代码(内置 csv 模块版)
import csv
from pathlib import Path

def batch_process_csv_native(source_folder: str, target_folder: str) -> None:
    src_path = Path(source_folder)
    dst_path = Path(target_folder)
    dst_path.mkdir(parents=True, exist_ok=True)

    csv_files = [f for f in src_path.glob("*.csv") if not f.name.startswith(".")]

    for file_path in csv_files:
        output_file = dst_path / f"stream_{file_path.name}"

        # 打开输入与输出文件流
        # newline='' 是标准库 csv 在读写时的必须设置,防止多出空行
        with open(file_path, mode="r", encoding="utf-8-sig") as infile, \
             open(output_file, mode="w", newline="", encoding="utf-8-sig") as outfile:

            reader = csv.DictReader(infile)
            if not reader.fieldnames:
                continue

            # 扩展表头:在原表头基础上增加处理时间列
            fieldnames = list(reader.fieldnames) + ["is_valid"]
            writer = csv.DictWriter(outfile, fieldnames=fieldnames)
            writer.writeheader()

            for row in reader:
                # 执行行级过滤与衍生字段计算
                row["is_valid"] = "YES" if row.get("status") == "active" else "NO"
                writer.writerow(row)

        print(f"流式处理完成: {output_file.name}")
四、生产级落地陷阱与防御性设计
在个人电脑上测试几个样例文件时,代码通常能正常运行;但一旦迁移到生产环境处理成百上千个历史数据时,往往会遭遇各种边界问题。必须在代码中融入防御性设计:
| 潜在风险点 | 产生原因与具体表现 | 确定性防御方案 |
|---|---|---|
| Windows Excel 乱码 | 保存为纯 utf-8 时,Windows Excel 打开不会自动识别无 BOM 的 UTF-8 编码,导致中文全部变成乱码。 |
统一在 to_csv 或 open 时指定 encoding="utf-8-sig",写入文件头部签名。 |
| 脏文件阻断全局流程 | 某一个 CSV 文件破损、非文本格式或权限受限,导致整个脚本崩溃退出,后续几百个文件无法被处理。 | 在循环体内部建立 try...except 异常隔离沙箱,记录错误日志后 continue,保证任务队列不中断。 |
| 同名覆盖风险 | 若直接指定输出目录但忘记重命名,当源目录与目标目录相同或误操作时,会将原始数据直接覆盖且不可逆。 | 明确区分 source_dir 与 target_dir;严格为新文件增加 prefix/suffix 前后缀标识。 |
| 空文件与隐藏文件干扰 | Mac 系统自动生成的 ._xxx.csv 隐藏文件或 0 字节文件被误读为数据表,抛出 EmptyDataError。 |
在遍历时使用 if not f.name.startswith(".") and f.stat().st_size > 0 前置过滤。 |
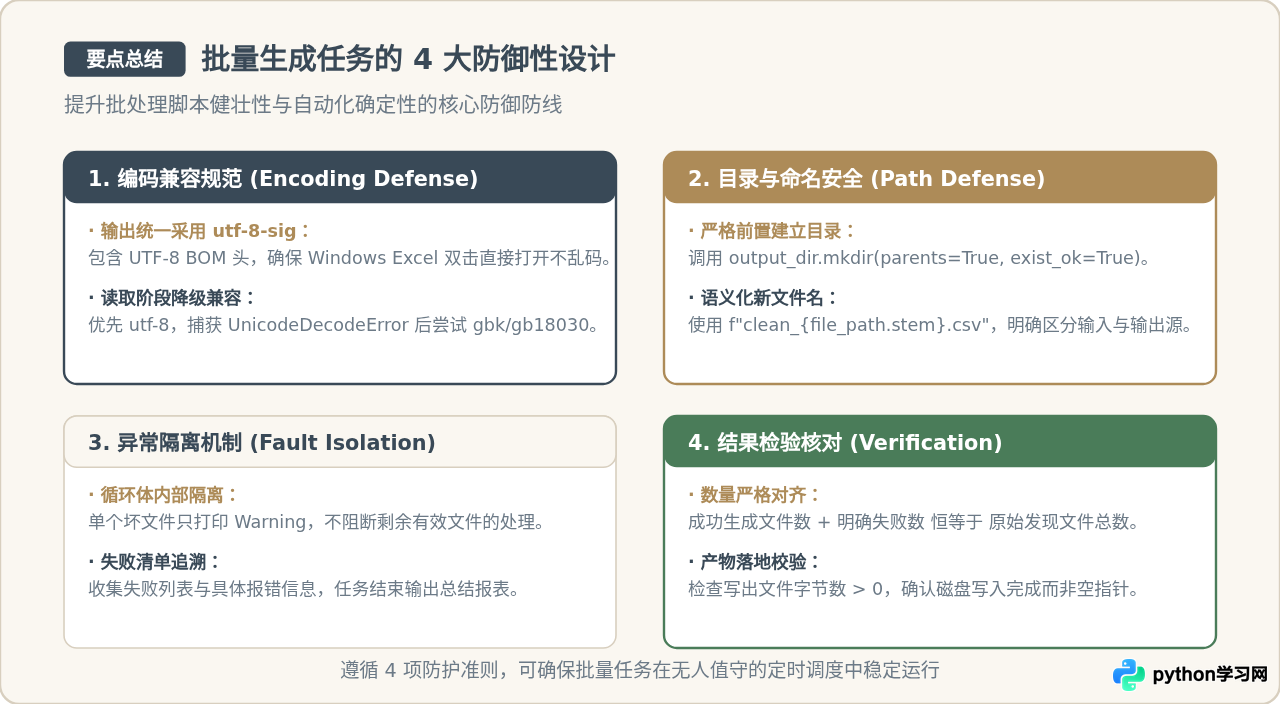
五、工程化模版与检验总结
将上述所有防御性实践汇聚为一体,我们可以得到一个标准的工程化脚本。该脚本支持自动识别多种常见中文编码、自动跳过无效与隐藏文件,并在控制台输出格式化的执行统计报表:
from pathlib import Path
import pandas as pd
from typing import List, Tuple

def robust_read_csv(file_path: Path) -> pd.DataFrame:
    """尝试以不同常见中文编码读取 CSV"""
    for enc in ("utf-8-sig", "utf-8", "gbk", "gb18030"):
        try:
            return pd.read_csv(file_path, encoding=enc)
        except (UnicodeDecodeError, UnicodeError):
            continue
    raise ValueError(f"无法使用常见编码解析文件: {file_path.name}")

def run_batch_generation(src_dir: str, out_dir: str, prefix: str = "cleaned_") -> None:
    source = Path(src_dir)
    target = Path(out_dir)
    target.mkdir(parents=True, exist_ok=True)

    # 过滤掉隐藏文件与空文件
    valid_files = [
        f for f in source.glob("*.csv")
        if not f.name.startswith(".") and f.stat().st_size > 0
    ]

    total = len(valid_files)
    print(f"=== 批量处理任务启动 | 目标总数: {total} ===")

    success_files: List[Tuple[str, int]] = []
    failed_files: List[Tuple[str, str]] = []

    for idx, item in enumerate(valid_files, start=1):
        target_file = target / f"{prefix}{item.name}"
        try:
            df = robust_read_csv(item)

            # --- 自定义数据处理区 ---
            # 示例:统一列名去除首尾空格
            df.columns = [c.strip() for c in df.columns]
            # --- 自定义数据处理区结束 ---

            df.to_csv(target_file, index=False, encoding="utf-8-sig")
            success_files.append((item.name, len(df)))
            print(f"[{idx}/{total}] 成功生成 -> {target_file.name}")
        except Exception as e:
            failed_files.append((item.name, str(e)))
            print(f"[{idx}/{total}] 处理跳过 -> {item.name}: {e}")

    print("\n=== 任务执行汇总 ===")
    print(f"总处理: {total} | 成功: {len(success_files)} | 失败: {len(failed_files)}")
    if failed_files:
        print("失败文件清单:")
        for name, reason in failed_files:
            print(f" - {name}: {reason}")

if __name__ == "__main__":
    run_batch_generation("raw_data", "output_data")
通过将文件发现、单文件生命周期控制、异常隔离以及规范编码落地串联起来,你不仅能够快速实现“批量读取并分别生成新文件”的基础需求,还能让脚本在面对脏数据、编码分歧与大批量并发时保持极高的确定性与可靠性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









