

Python中计算n的3次方(立方)的三种常用写法
系统讲解Python中计算n的3次方(立方)的三种常用写法:幂运算符**、内置函数pow()与math模块的math.pow()。深入分析语法规范、数据类型保留、运算符优先级陷阱、大数溢出机制与工程选型建议。
n ** 3、调用Python内置函数 pow(n, 3),以及引入数学模块调用 math.pow(n, 3)。这三种写法在语法形式、底层执行机制、返回值类型以及边界溢出处理上各有侧重。本文将逐一拆解每种写法的具体使用步骤、运算原理、类型表现与注意事项,帮助你在实际开发中做出恰当的选择。
写法一:使用双星号幂运算符(**)
双星号 ** 是Python内置的算术幂运算符,也是日常编码中计算立方的最直接、最符合Python惯用风格(Pythonic)的写法。它的语法最为精简,无需引入任何外部模块或函数,可以直接对整数、浮点数以及复数执行乘方运算。
1. 基本语法与代码示例
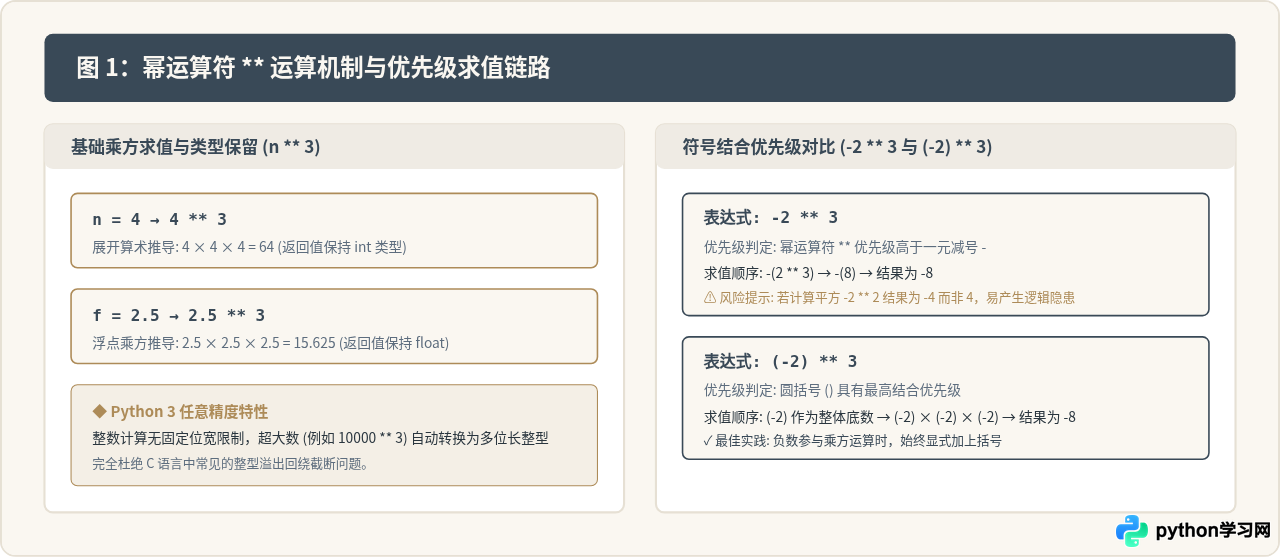
当执行 n ** 3 时,Python解释器在编译期会将其识别为乘方算子,在字节码层面直接映射为 BINARY_POWER 指令。运算过程中输入操作数的类型将被完整保留:如果 $n$ 是整数,计算结果将保持为整数;如果 $n$ 是浮点数,计算结果则为浮点数。
# 基本整数立方计算
n = 4
result = n ** 3
print("4的立方为:", result)
print("返回值类型:", type(result))
# 示例输出:
# 4的立方为: 64
# 返回值类型: <class 'int'>

# 浮点数立方计算
f = 2.5
f_result = f ** 3
print("2.5的立方为:", f_result)
print("返回值类型:", type(f_result))
# 示例输出:
# 2.5的立方为: 15.625
# 返回值类型: <class 'float'>
2. 运算符优先级与负数立方的陷阱
在处理负数的立方时,许多初学者容易遇到符号结合优先级的陷阱。在Python的运算符优先级规则中,幂运算符 ** 的优先级高于单目减号(负号 -)。这意味着表达式 -2 ** 3 在求值时,解释器实际上会优先计算 2 ** 3 得到 8,随后再附加负号得到 -8。
虽然对于奇数次方(如3次方),-2 ** 3 与 (-2) ** 3 的最终数学结果恰好都等于 -8,但在偶数次方(如平方)下二者结果截然不同:-2 ** 2 等于 -4,而 (-2) ** 2 才等于 4。因此,当变量本身带有负号字面量时,严谨的做法始终是使用圆括号包裹底数,写作 (-2) ** 3,以保证语义清晰明确。
写法二:使用内置函数 pow(n, 3)
Python提供了一个随时可用的全局内置函数 pow()。与双星号运算符类似,使用 pow() 同样不需要显式 import 任何模块。但在很多涉及动态参数传递或函数式编程(如 map())的场景下,函数调用的形式比运算符更加自然。
1. 函数定义与基本调用
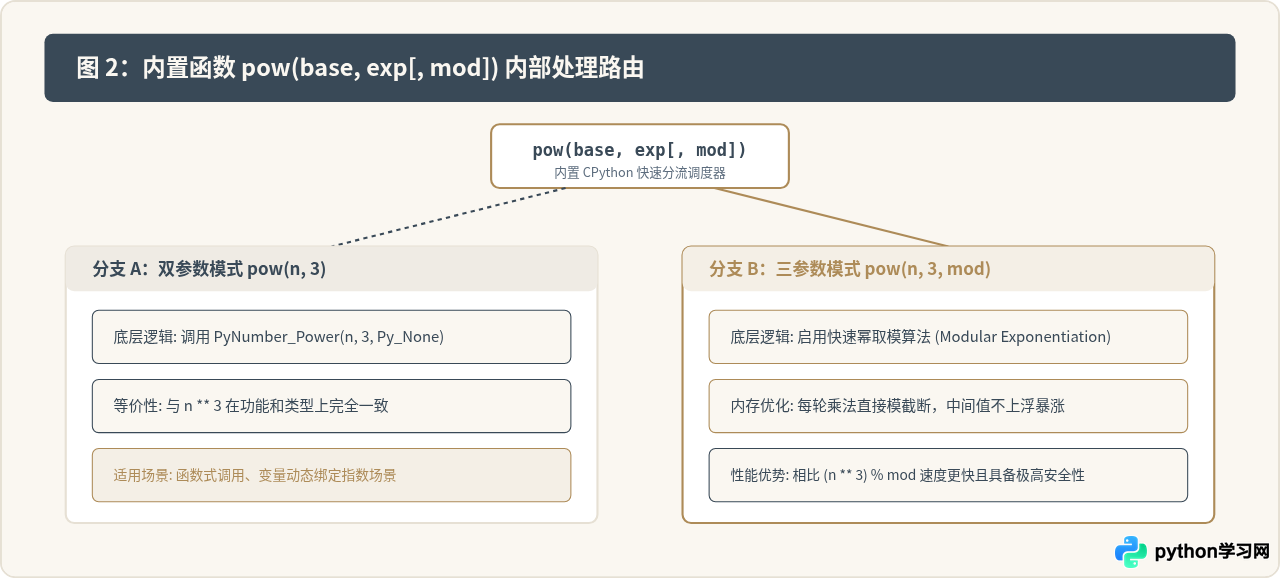
pow() 的完整原型为 pow(base, exp[, mod])。当只传入两个参数时,pow(n, 3) 等价于 n ** 3。它同样会遵循类型的自适应原则:整数输入得到整数输出,浮点数输入得到浮点数输出。
# 使用内置函数 pow 计算立方
number = 5
cubic_val = pow(number, 3)
print("5的立方为:", cubic_val)
print("数据类型:", type(cubic_val))
# 示例输出:
# 5的立方为: 125
# 数据类型: <class 'int'>

# 在高阶函数中配合使用
numbers = [1, 2, 3, 4]
cubes = list(map(lambda x: pow(x, 3), numbers))
print("批量计算立方:", cubes)
# 示例输出:
# 批量计算立方: [1, 8, 27, 64]
2. 三参数模式在算法中的特殊优势
内置 pow() 相比 ** 运算符的一个显著优势在于它支持可选的第三个参数:模数 mod。当调用 pow(n, 3, m) 时,它执行的是模幂运算(即等价于数学上的 $(n^3) \pmod m$)。
在底层实现中,pow(n, 3, m) 采用了快速幂取模算法,在乘法的每一步都会直接进行取模,避免了中间产生巨大数字占用内存或耗费计算资源。相比手写 (n ** 3) % m,三参数 pow() 不仅计算速度明显更快,而且能彻底防止极端大数场景下的内存剧增。
写法三:使用标准库 math.pow(n, 3)
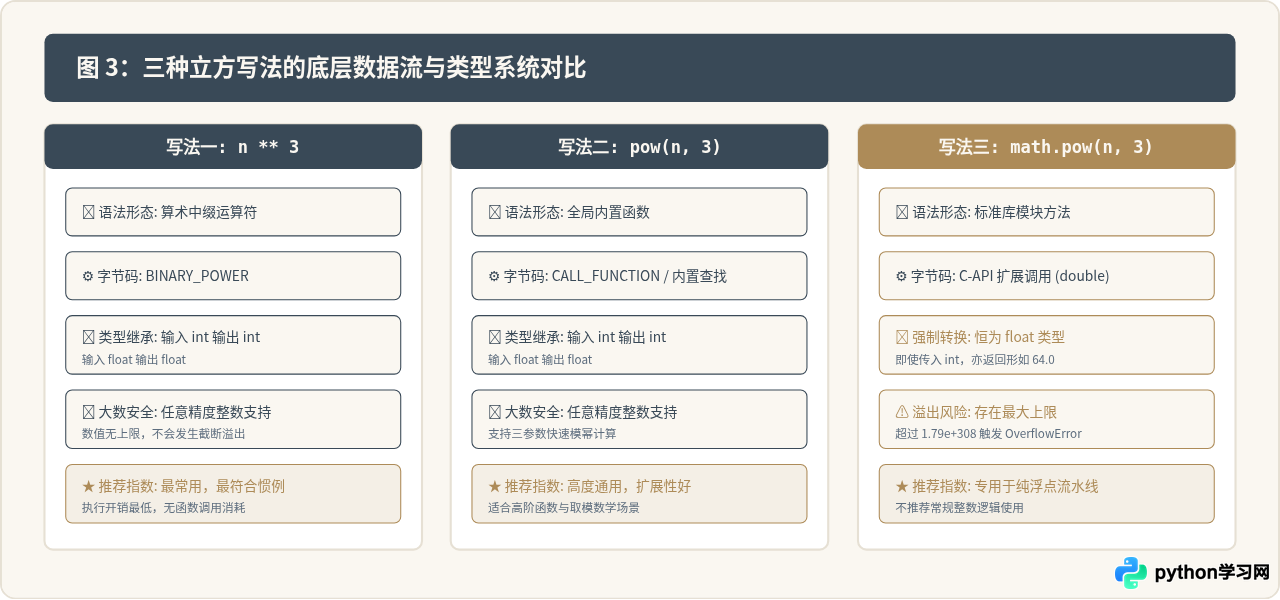
第三种常用写法是借助Python标准库中的 math 模块。通过 import math 并调用 math.pow(n, 3) 即可完成计算。与前两种写法相比,math.pow() 存在一个本质区别:它的返回值始终是浮点数(float)。
1. 模块导入与使用方式
math.pow() 封装了底层 C 运行时库(C standard library)的 double pow(double, double) 函数。无论传入的参数是整型还是浮点型,Python都会在调用底层 C 函数前将其强制转换为双精度浮点数(C double),因此计算结果必然为浮点型。
# 引入标准数学库
import math

n = 4
result = math.pow(n, 3)
print("计算结果:", result)
print("数据类型:", type(result))
# 示例输出:
# 计算结果: 64.0
# 数据类型: <class 'float'>
2. 浮点精度上限与大数溢出(OverflowError)
由于底层完全基于 IEEE 754 双精度浮点数规范实现,math.pow() 的表示范围受到浮点数指数大小的严格限制(最大值大约为 $1.79 \times 10^{308}$)。当输入的 $n$ 非常大时,计算 $n^3$ 会直接抛出 OverflowError: math range error。
而在同样的输入下,前述的 n ** 3 和 pow(n, 3) 会无缝切换到Python的任意精度大整数算法,绝不会抛出溢出错误。因此在科学计算或金融分析中,若明确需要浮点数协同计算,可使用 math.pow();但如果是纯整数运算,应优先避免使用它。
三种写法的关键差异与横向对比
为了在实际编码中快速选择最合理的写法,我们需要从语法成本、依赖引入、返回值类型、性能开销以及大数安全性等维度进行综合考量。
| 对比维度 | 写法一:n ** 3 |
写法二:pow(n, 3) |
写法三:math.pow(n, 3) |
|---|---|---|---|
| 模块依赖 | 无(原生运算符) | 无(内置全局函数) | 需要 import math |
| 输入为 int 的返回值 | int(如 64) |
int(如 64) |
float(如 64.0) |
| 输入为 float 的返回值 | float |
float |
float |
| 大数运算安全性 | 极高(任意精度,不溢出) | 极高(任意精度,不溢出) | 受限(超出双精度上限抛 OverflowError) |
| 模幂支持 | 需配合 %:(n**3)%m |
原生支持:pow(n, 3, m) |
不支持模数参数 |
| 执行效率(微基准) | 最快(直接字节码级算术指令) | 快(有轻微函数栈调用开销) | 快(跨模块与 C 扩展调用开销) |
在纯运行速度方面,由于 ** 属于语言层面的原生操作符,其直接生成 BINARY_POWER 虚拟机指令,跳过了函数查找与栈帧开销,在微基准测试中耗时通常略短于另外两者。但对于绝大部分业务代码而言,这一纳秒级的差距完全可以忽略,代码的可读性与正确性才是首要考量。
开发中容易出现的三个常见误区
误区一:混淆位异或运算符 ^ 与乘方
在很多数学软件(如 MATLAB)或文本编辑习惯中,符号 ^ 常被用来表示幂运算。但在Python中,^ 是按位异或运算符(Bitwise XOR)。
例如,执行 4 ^ 3 不会得到 64,而是得到 7(二进制下 0100 ^ 0011 = 0111)。因为该表达式在语法上完全合法,解释器不会产生任何报错,这往往会导致极其隐蔽的计算错误。在Python中计算乘方,务必使用双星号 **。
误区二:在需要整型索引处使用了 math.pow()
因为 math.pow(n, 3) 必定返回浮点数,如果在后续流程中将结果直接用作列表索引或切片步长,会引发 TypeError: list indices must be integers or slices, not float:
import math

items = ["A", "B", "C", "D", "E"]
# 错误用法: math.pow 返回 4.0,不能直接作为索引
idx = math.pow(1, 3)  # 值为 1.0 (float)
# print(items[idx])  # 抛出 TypeError

# 正确做法: 使用 ** 或 pow() 保持整型
valid_idx = 1 ** 3    # 值为 1 (int)
print("提取元素成功:", items[valid_idx])
# 示例输出:
# 提取元素成功: B
误区三:忽略极大整数的计算耗时
虽然 ** 与 pow() 支持任意精度大整数,不会产生数值溢出,但当底数极大时,大整数乘法运算和随后转换为十进制字符串的耗时会显著上升。在编写涉及超大规模数值的算法时,应当评估计算复杂度,或结合 pow(n, 3, mod) 及时进行模截断。
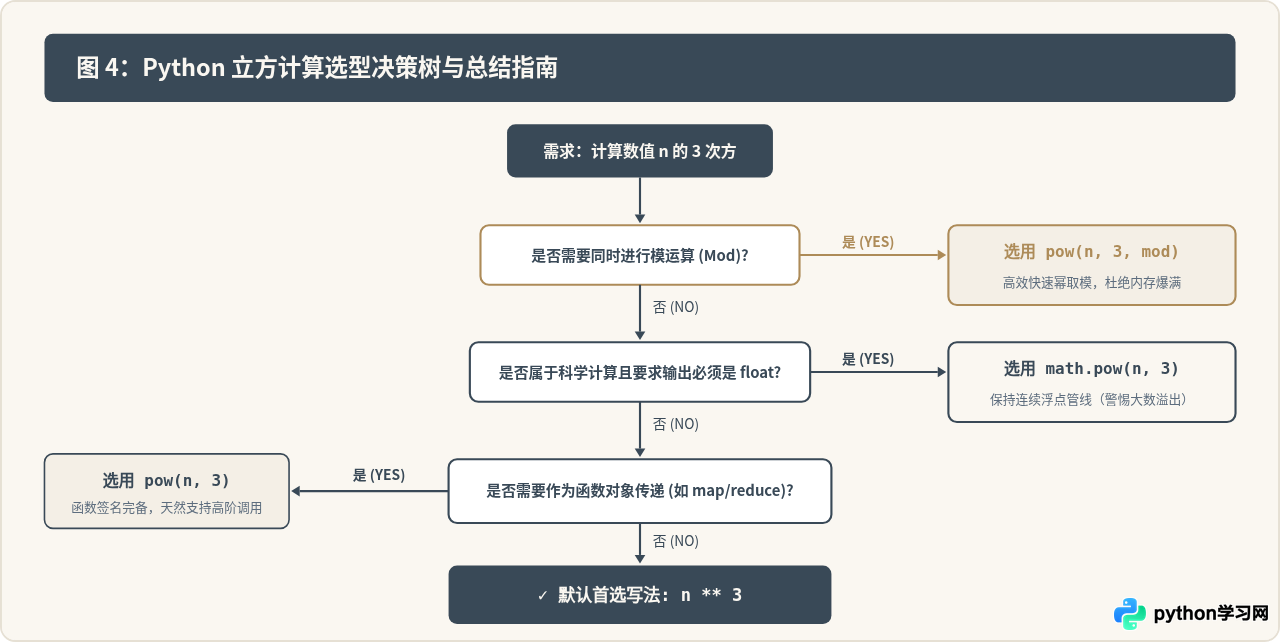
总结与实践建议
综上所述,Python为计算数值的3次方提供了灵活多样且严谨的工具链:
- 常规场景优先使用
n ** 3:语法最紧凑,意图最明确,执行速度最快,且完美保留整型或浮点型的原有属性。 - 高阶函数与模幂运算使用
pow(n, 3)或pow(n, 3, m):在需要作为函数传递或进行带模数的数论计算时,它是最理想的解决方案。 - 明确要求浮点数参与的科学计算使用
math.pow(n, 3):当上下文深度绑定浮点数值体系且确信数值不会超过双精度浮点上限时使用。
理解这三种写法在底层实现机制与类型系统上的细微差异,不仅有助于写出简洁规范的Python代码,更能有效避免隐式类型转换和精度越界等工程隐患。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









