

Python爬虫100例典型场景:电商价格监控与新闻聚合采集实现

在自动化数据抓取领域,电商价格监控与新闻资讯聚合是两类工程目标截然不同却高度典型的场景。电商监控的核心要求是抓取时延短、对动态价格接口解析精准、能在价格跨越阈值时可靠触发告警;新闻聚合的核心要求则是多源兼顾、列表到详情的联动穿透、增量去重以及正文与发布时间的标准化清洗。本文针对这两类场景的真实业务需求,逐一讲解从请求构建、接口逆向、数据提取到去重调度的具体实现过程。
一、典型场景特征对比与系统架构设计
理解场景特征是编写高效爬虫的前提。电商系统为了防止爬虫比价并减轻服务器渲染压力,价格数据往往不直接嵌入在HTML源码中,而是通过异步XHR/Fetch请求从专用定价引擎获取,或经过客户端JavaScript混淆计算后写入DOM。新闻资讯类站点则注重搜索引擎收录(SEO),通常保留完整的服务端渲染HTML,但不同媒体站点的DOM排版格式千差万别,要求爬虫具备通用的结构化抽取能力与精准的增量去重机制。
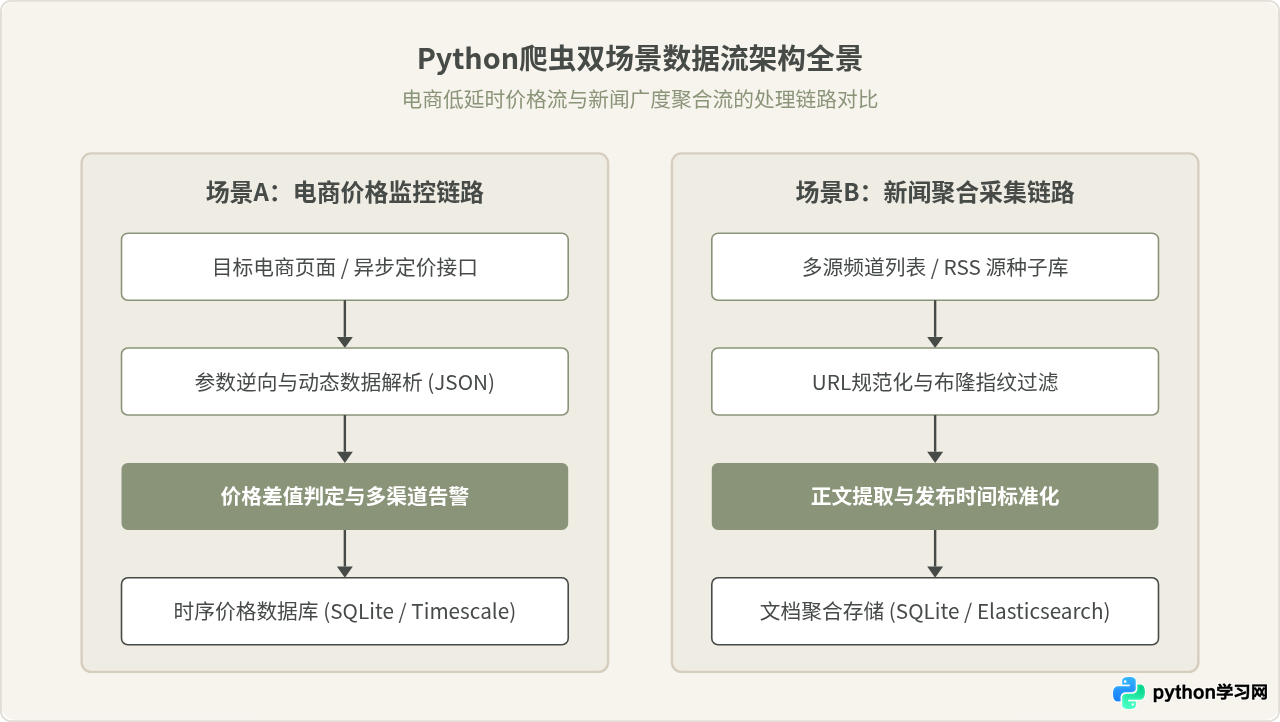
从数据流来看,电商价格监控聚焦于单一维度的深度时序变化,关键是请求伪装度与抗风控能力;新闻聚合则注重横向广度的数据汇聚,关键是URL指纹判重效率与异构页面的容错解析能力。
二、场景一:电商价格监控的采集实现
1. 动态价格获取原理与抓包分析
初学者抓取电商网页时,最常见的失误是直接向商品详情页URL发起GET请求并尝试用XPath匹配价格节点,结果往往获得空字符串或“--”等占位字符。这是因为现代电商平台将商品描述(静态或SSR)与商品实时报价(动态微服务接口)拆分为独立的请求。
排查与定位真实价格接口的固定步骤如下:
- 使用浏览器开发者工具(F12)打开“Network”(网络)面板,过滤“Fetch/XHR”类型。
- 在搜索框中直接搜索网页上显示的价格数字(如
3999.00)或商品SKU编号。 - 定位返回JSON格式数据的接口,核对请求方法、Query参数、Headers(特别是
Referer、Origin以及自定义鉴权Token)。 - 若价格接口具备签名机制(如URL中附带
sign或_token参数),则需要检查该Token是通过页面内联的<script>初始化参数生成,还是由独立JS加密脚本计算得到。
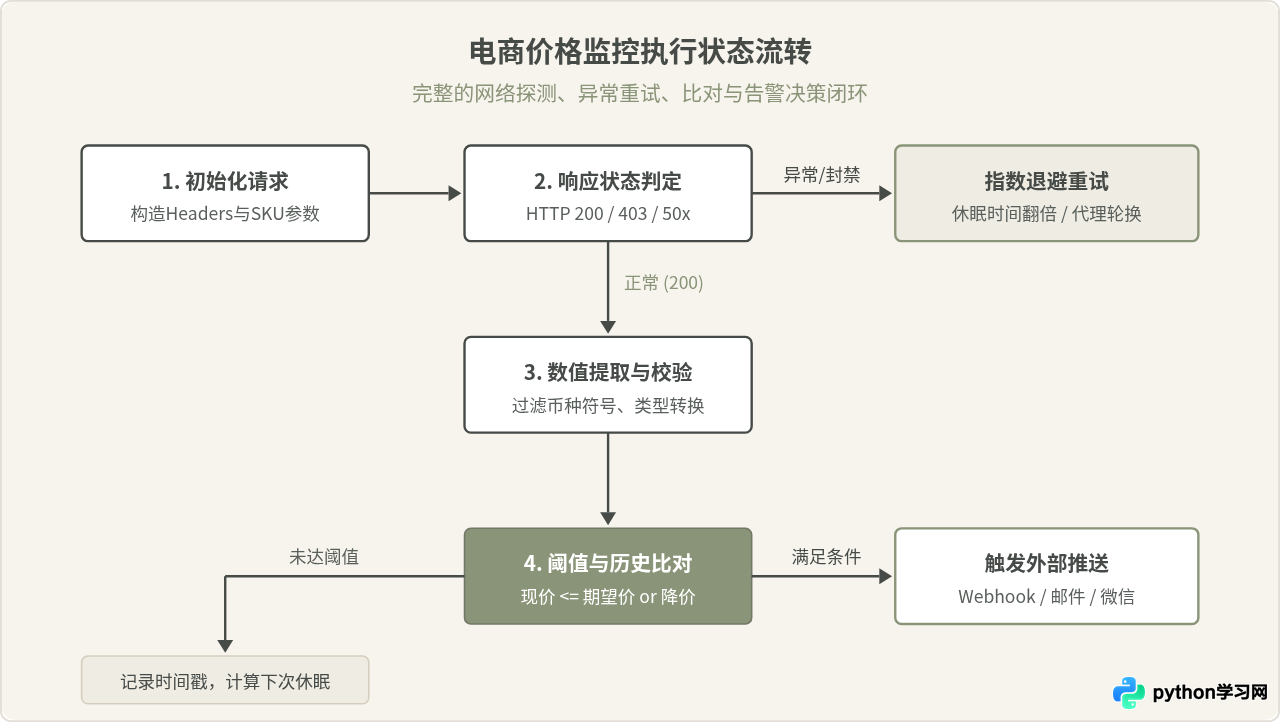
很多开发者认为“每秒轮询一次就能做到零延迟降价通知”,这在生产环境中是典型的误区。一方面,电商平台具有灵敏的频次限流(Rate Limiting),极高频的单一IP访问会在数分钟内触发WAF拦截或重定向至滑块验证码;另一方面,电商价格属于低频变动数据(通常由促销活动或运营调价触发),高频轮询99.9%的流量都是无意义损耗。正确的做法是采用“动态梯度退避策略”:在常规时段设置5~15分钟的巡检间隔,在接近促销整点(如双11零点、大促秒杀节点)前临时缩短轮询窗口,并辅以指数退避重试机制。
2. 核心代码实现:价格抓取与差价检测
以下代码展示了一个完整的电商价格监控单元,包含Session保持、请求头伪装、JSON接口解析、浮点数精度处理及差价阈值触发:
import requests
import time
import logging
from typing import Optional, Dict, Any

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

class PriceMonitor:
    def __init__(self, sku_id: str, target_price: float):
        self.sku_id = sku_id
        self.target_price = target_price
        self.session = requests.Session()
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
            "Accept": "application/json, text/plain, */*",
            "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
            "Referer": f"https://item.example.com/{sku_id}.html"
        })
        self.last_price: Optional[float] = None

    def fetch_price(self) -> Optional[float]:
        # 模拟典型的电商价格API请求路径
        api_url = "https://api.example.com/mall/v2/pricing/get_sku_price"
        params = {
            "sku": self.sku_id,
            "channel": "pc",
            "timestamp": int(time.time() * 1000)
        }

        try:
            resp = self.session.get(api_url, params=params, timeout=8)
            if resp.status_code == 200:
                data = resp.json()
                # 兼容返回结构:{"code": 0, "data": {"price": "2999.00", "status": "on_sale"}}
                if data.get("code") == 0 and "data" in data:
                    raw_price = data["data"].get("price")
                    return float(raw_price)
                else:
                    logging.warning(f"接口返回业务错误: {data.get('message', '未知错误')}")
            elif resp.status_code == 403:
                logging.error("遭遇风控拦截 (HTTP 403),需要切换代理或延长间隔")
            else:
                logging.warning(f"请求失败,HTTP状态码: {resp.status_code}")
        except requests.exceptions.RequestException as e:
            logging.error(f"网络请求异常: {e}")
        except (ValueError, TypeError) as e:
            logging.error(f"价格数据转换异常: {e}")

        return None

    def evaluate_price(self, current_price: float) -> None:
        logging.info(f"商品 [SKU:{self.sku_id}] 当前价格: ¥{current_price:.2f}")

        if current_price <= self.target_price:
            self.trigger_alert(current_price, "已达到预期目标价格!")

        if self.last_price is not None and current_price < self.last_price:
            drop_amount = self.last_price - current_price
            self.trigger_alert(current_price, f"较上次检测降价 ¥{drop_amount:.2f}")

        self.last_price = current_price

    def trigger_alert(self, price: float, reason: str) -> None:
        # 在此处对接企业微信机器人、钉钉Webhook或邮件告警
        logging.warning(f"【降价提醒触发】商品SKU: {self.sku_id} | 现价: ¥{price:.2f} | 原因: {reason}")
三、场景二:新闻聚合采集的实现
1. 列表页与详情页的联动机制
新闻聚合系统通常由“列表采集器”与“详情提取器”两部分组成。列表采集器定期巡检各个新闻频道的聚合页或RSS源,获取最新发布的文章链接,并经过判重过滤器;通过过滤的全新链接会被推入任务队列,由详情提取器下载具体HTML并解析文章标题、正文文本、作者及标准化时间。
一些开发者倾向于使用如
readability-lxml 或 goose3 等开源正文提取算法,期望“一劳永逸”地通吃所有新闻站点。通用抽取器基于文本密度分布和标签加权启发式规则,对排版规范的新闻通稿准确率较高;但在面对图文混排、嵌入式视频播放器、画廊式相册或包含大量相关推荐模块的现代富媒体页面时,容易出现误截断或将广告文本混入正文的情况。工程推荐方案:采用“主规则精准匹配 + 启发式通用降级”策略。对重点源站点(Top 20)配置精确的XPath规则树,对长尾未知站点使用通用提取器保底。
2. 增量采集与指纹去重(MD5与布隆过滤器)
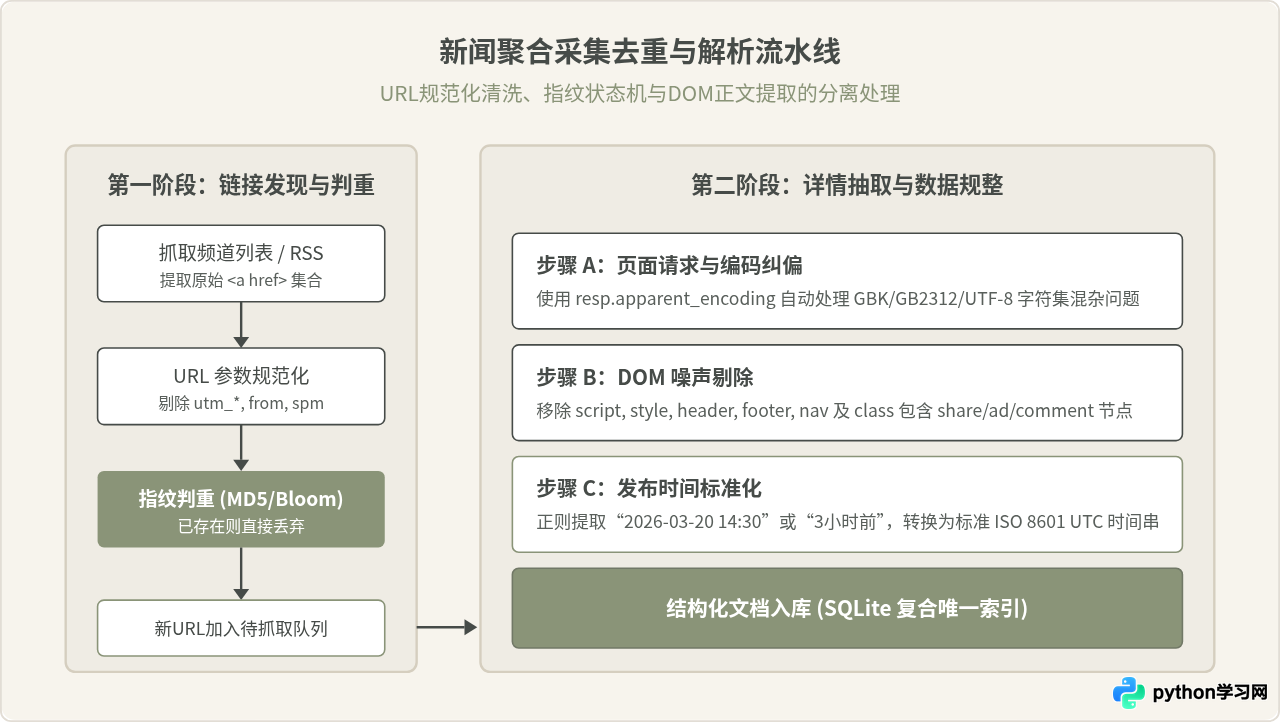
新闻网站更新频繁,但绝大多数历史链接长期保持不变。如果每次采集都请求全部详情页,不仅严重消耗自身带宽和存储,还会对目标站造成不必要的压力。增量采集的核心在于构建URL指纹识别机制:
- URL规范化清洗:新闻链接常附带跟踪参数(如
?spm=...&from=feed&utm_source=...)。在计算指纹前必须剥离这些无关参数,将https://news.example.com/a/1001?from=rss规范化为https://news.example.com/a/1001。 - 哈希指纹存储:对规范化后的URL计算MD5(32位十六进制字符串),单机小规模采集可保存在内存
set或 SQLite 唯一索引中;多实例或千万级数据场景下,可使用 Redis 布隆过滤器(Bloom Filter),在极小内存开销下实现 \(O(1)\) 时间复杂度的重复判别。
3. 核心代码实现:新闻列表爬取与正文清洗
以下代码演示了从列表解析、规范化去重、DOM杂质清除到提取标准正文的完整流程:
import hashlib
import re
from urllib.parse import urljoin, urlparse, urlunparse
import requests
from bs4 import BeautifulSoup
from typing import List, Dict, Optional, Set

class NewsAggregator:
    def __init__(self, base_url: str):
        self.base_url = base_url
        self.session = requests.Session()
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36"
        })
        self.seen_fingerprints: Set[str] = set()

    def normalize_url(self, raw_url: str) -> str:
        """剥离查询参数中的跟踪后缀,保证同一文章指纹唯一"""
        full_url = urljoin(self.base_url, raw_url)
        parsed = urlparse(full_url)
        # 仅保留协议、域名和路径,清空query与fragment
        clean_url = urlunparse((parsed.scheme, parsed.netloc, parsed.path, "", "", ""))
        return clean_url

    def get_fingerprint(self, url: str) -> str:
        """计算规范化URL的MD5哈希作为持久化唯一标识"""
        return hashlib.md5(url.encode("utf-8")).hexdigest()

    def fetch_news_list(self, list_url: str) -> List[str]:
        """抓取列表页并提取所有未见过的文章链接"""
        new_links = []
        try:
            resp = self.session.get(list_url, timeout=10)
            resp.encoding = resp.apparent_encoding
            soup = BeautifulSoup(resp.text, "html.parser")

            # 根据常见的超链接规则过滤,例如 /article/ 或 .html 结尾
            for a_tag in soup.find_all("a", href=True):
                href = a_tag["href"]
                if re.search(r"/(article|news)/\d+", href) or href.endswith(".html"):
                    norm_url = self.normalize_url(href)
                    fp = self.get_fingerprint(norm_url)
                    if fp not in self.seen_fingerprints:
                        self.seen_fingerprints.add(fp)
                        new_links.append(norm_url)
        except requests.exceptions.RequestException as e:
            print(f"列表页抓取失败: {e}")
        return new_links

    def parse_article(self, article_url: str) -> Optional[Dict[str, str]]:
        """下载新闻详情页并提取清洗后的正文与标题"""
        try:
            resp = self.session.get(article_url, timeout=10)
            resp.encoding = resp.apparent_encoding
            soup = BeautifulSoup(resp.text, "html.parser")

            # 1. 提取标题
            title_node = soup.find("h1") or soup.find("title")
            title = title_node.get_text().strip() if title_node else "无标题"

            # 2. 清除干扰节点
            for tag in soup(["script", "style", "nav", "header", "footer", "aside"]):
                tag.decompose()
            for extra in soup.find_all(class_=re.compile(r"(comment|share|ad-|advert|recommend)")):
                extra.decompose()

            # 3. 提取主体段落
            paragraphs = []
            main_content = soup.find("article") or soup.find(class_=re.compile(r"(content|article-body|main-text)"))
            search_scope = main_content if main_content else soup

            for p in search_scope.find_all("p"):
                txt = p.get_text().strip()
                if len(txt) > 15:  # 过滤版权声明或无意义简短标注
                    paragraphs.append(txt)

            content = "\n\n".join(paragraphs)
            if not content:
                return None

            return {
                "url": article_url,
                "title": title,
                "content": content,
                "fingerprint": self.get_fingerprint(article_url)
            }
        except Exception as e:
            print(f"详情页解析异常 [{article_url}]: {e}")
            return None
四、自动化调度与轻量持久化整合
单次执行的代码只能用于验证逻辑,生产级爬虫必须整合调度循环与数据持久化。对于中小型任务,SQLite 是最理想的轻量存储方案,它无需安装额外数据库服务,单个文件即可保障ACID事务。
1. SQLite 数据表结构设计
| 字段名称 | 数据类型 | 约束 / 索引 | 作用说明 |
|---|---|---|---|
id |
INTEGER | PRIMARY KEY AUTOINCREMENT | 自增主键 |
fingerprint |
VARCHAR(32) | UNIQUE INDEX | URL规范化MD5指纹,实现数据库级幂等防重 |
title |
VARCHAR(255) | NOT NULL | 商品名或新闻标题 |
val_metric |
REAL | DEFAULT 0.0 | 监控数值指标(电商记录当前价格,新闻可存字数) |
raw_content |
TEXT | NULL | 提取的正文文本或商品详细JSON快照 |
created_at |
DATETIME | DEFAULT CURRENT_TIMESTAMP | 首次采集入库时间 |
2. 定时调度与平滑退避控制
电商价格监控适合使用定时调度库(如 APScheduler)以固定的时间表轮询,或使用带随机抖动的死循环:
import random
import time

def run_scheduler_loop(interval_seconds: int = 300):
    """
    带随机时间抖动的常驻轮询调度器
    避免固定间隔导致请求特征在服务端流量分析中呈现明显的周期峰值
    """
    logging.info("监控服务已启动...")
    while True:
        try:
            # 1. 执行具体监控逻辑
            monitor_task()
        except Exception as err:
            logging.error(f"任务周期执行出错: {err}")

        # 引入 ±15% 的随机浮动
        jitter = random.uniform(-0.15, 0.15) * interval_seconds
        sleep_duration = max(10, interval_seconds + jitter)
        logging.info(f"等待下一次调度,休眠 {sleep_duration:.1f} 秒...")
        time.sleep(sleep_duration)
五、生产环境稳定性保障与避坑总结
在长期运行过程中,爬虫系统面对的不是静态页面,而是动态变化的网络环境与不断升级的反爬策略。以下是保证电商与新闻爬虫长期健壮运行的四层防护策略:
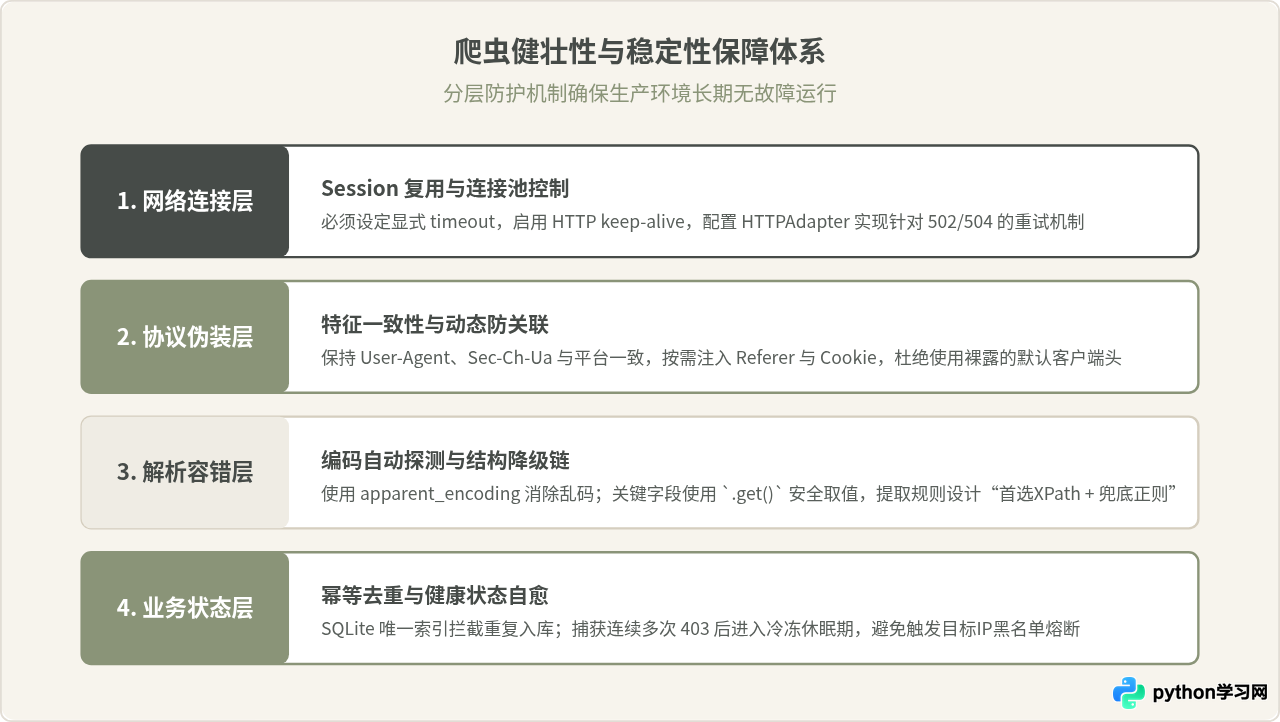
- 编码识别陷阱:国内老牌新闻站点常用
GBK或GB2312编码,直接读取resp.text经常出现中文乱码。应显式调用resp.encoding = resp.apparent_encoding,或者从resp.content读取二进制数据后由 BeautifulSoup 自动探测编码。 - 网络超时与重试退避:网络波动和反爬限流常常导致请求假死。所有请求必须加上
timeout=(3.05, 10)(连接超时与读取超时),并在捕获requests.exceptions.Timeout后采用指数退避(2秒、4秒、8秒),切忌无间隔强行重发。 - 合法合规与友好抓取:始终遵守目标站点的
robots.txt协议及合理频率限制,严禁对目标服务发起拒绝服务级别的并发压力。数据采集应仅用于合规的个人监控、学术分析或内部聚合,不得侵犯版权与商业秘密。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









