

适合Python零基础的3个练手小项目:猜数字与简易计算器实现

许多初学者在学完 Python 的变量、循环与条件判断后,常常陷入“看教程能懂、自己写却不知道从何下手”的困境。脱离语法碎片的有效方式,是通过轻量、目标清晰的小项目建立完整的程序交互闭环。本文精选 3 个针对零基础学习者的实用练手项目:猜数字游戏、简易四则运算计算器以及文本词频统计器。通过完整的可运行代码、逐步拆解和实现机制对比,帮助读者真正掌握控制流、函数封装及集合操作的实际运用。
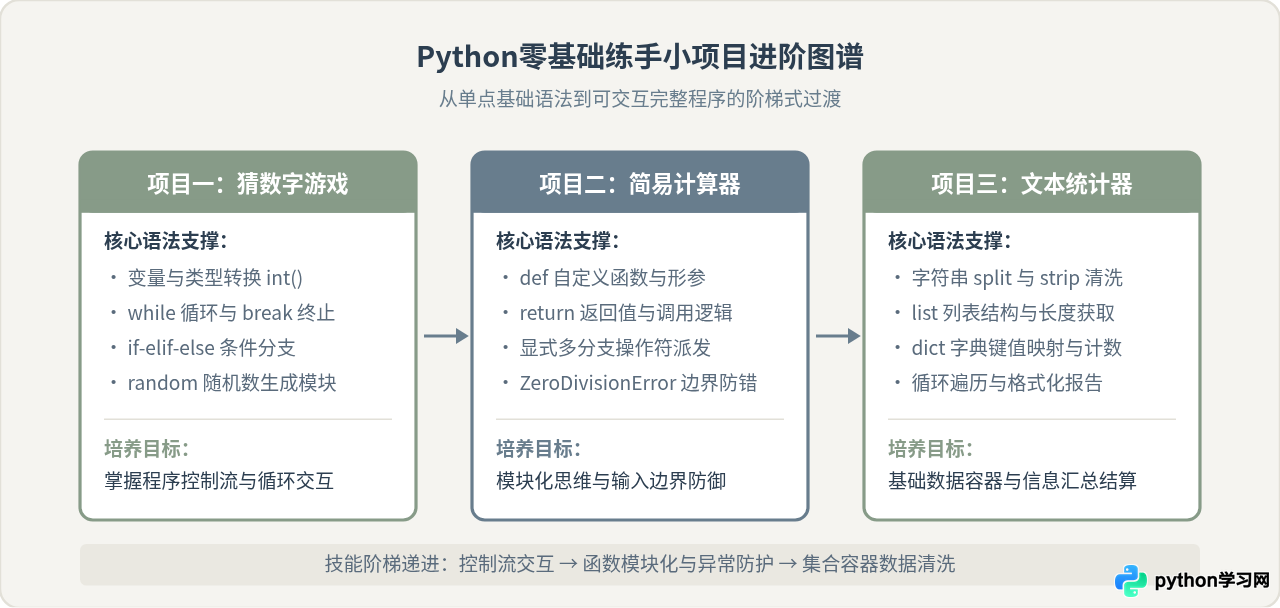
一、项目一:猜数字游戏(掌握变量、循环与条件分支)
猜数字是编程学习中最经典的入门项目。计算机在指定区间内随机生成一个整数,用户通过控制台不断输入猜测值,程序根据大小关系给出反馈,直至猜中为止。这个小项目能够完整串联控制台输入输出、类型转换、循环维持以及分支比对。
1. 完整实现代码
在任意目录下创建 guess_number.py 文件,输入以下完整代码:
import random

def play_guess_game():
    target = random.randint(1, 100)
    attempts = 0
    print("=== 欢迎来到猜数字游戏 ===")
    print("系统已生成 1 到 100 之间的随机整数,请开始猜测。")

    while True:
        user_input = input("请输入你猜的数字(输入 q 退出):").strip()

        if user_input.lower() == 'q':
            print(f"游戏结束,正确答案是 {target}。")
            break

        try:
            guess = int(user_input)
        except ValueError:
            print("输入无效!请输入有效的整数或输入 q 退出。")
            continue

        attempts += 1

        if guess < target:
            print("太小了,再试一次!")
        elif guess > target:
            print("太大了,再试一次!")
        else:
            print(f"恭喜你,猜对了!答案就是 {target}。")
            print(f"你总共尝试了 {attempts} 次。")
            break

if __name__ == "__main__":
    play_guess_game()
2. 执行流程与关键控制逻辑
程序的生命周期由 while True 循环驱动。每一次用户输入都会经历两层校验:第一层是检查是否触发退出字符 'q';第二层是尝试将字符串转化为整型数字。若用户输入的是字母或符号,int() 函数会触发 ValueError,程序通过 try-except 捕获并提示重新输入,避免程序崩溃。
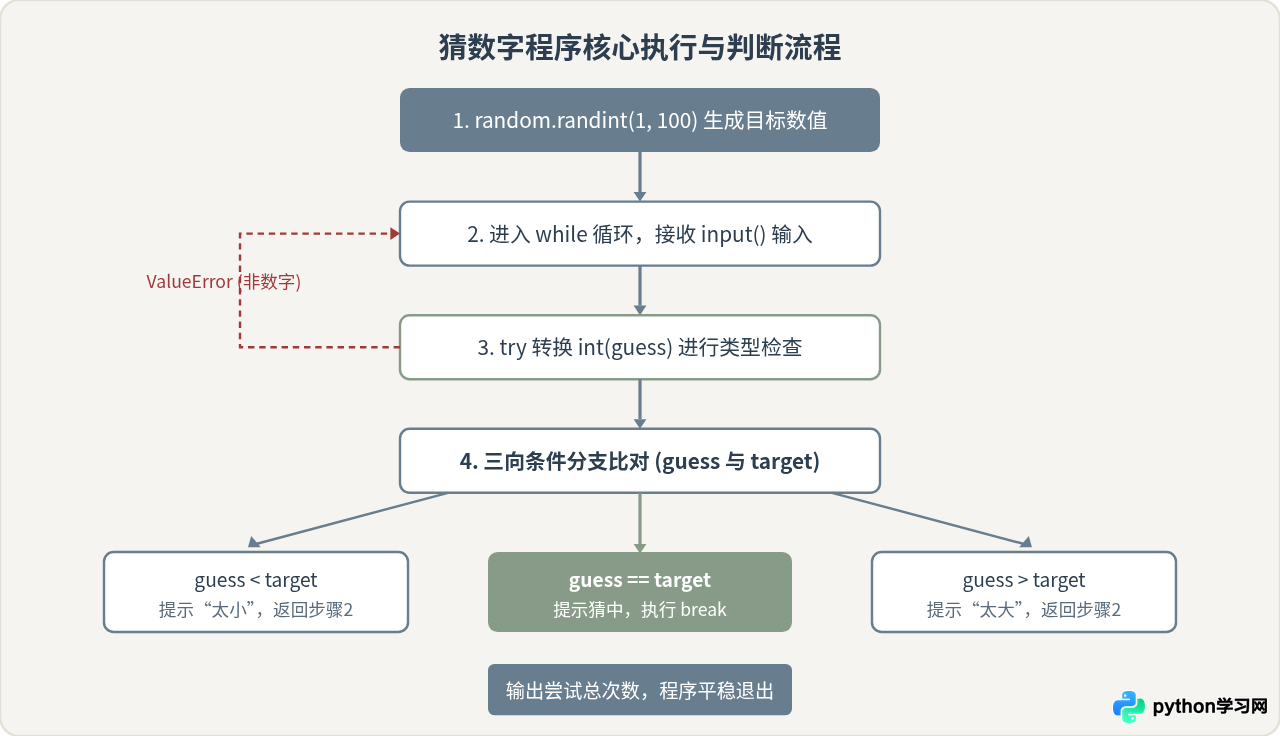
python3 guess_number.py 即可启动。初学者最常见的失误是忘记对 input() 的返回值进行类型转换。在 Python 中,input() 始终返回字符串,直接拿字符串与整型变量做 < 或 > 比较会触发 TypeError。
二、项目二:简易计算器(掌握函数封装与输入验证)
很多初学者在写计算器时,容易把所有的逻辑平铺在全局代码中。简易计算器项目的核心价值,在于让零基础学习者第一次体会到“函数封装”的好处:把加、减、乘、除分别抽离成独立的运算单元,让主程序专注于用户交互与参数派发。
1. 完整实现代码
创建 calculator.py 文件并写入如下代码:
def add(x, y):
    return x + y

def subtract(x, y):
    return x - y

def multiply(x, y):
    return x * y

def divide(x, y):
    if y == 0:
        raise ZeroDivisionError("除数不能为零")
    return x / y

def run_calculator():
    operations = {
        '+': add,
        '-': subtract,
        '*': multiply,
        '/': divide
    }

    print("=== 简易四则运算计算器 ===")
    print("支持的操作符:+  -  *  /  (输入 exit 退出)")

    while True:
        op = input("\n请选择运算符 (+, -, *, /) 或 exit: ").strip()
        if op.lower() == 'exit':
            print("计算器已退出。")
            break

        if op not in operations:
            print(f"无效运算符 '{op}',请重新输入支持的四则运算符号。")
            continue

        try:
            num1 = float(input("请输入第一个数字: ").strip())
            num2 = float(input("请输入第二个数字: ").strip())
        except ValueError:
            print("错误:输入的数字格式不合法,请输入常规数字。")
            continue

        try:
            calc_func = operations[op]
            result = calc_func(num1, num2)
            print(f"计算结果: {num1} {op} {num2} = {result}")
        except ZeroDivisionError as err:
            print(f"运算错误: {err}")

if __name__ == "__main__":
    run_calculator()
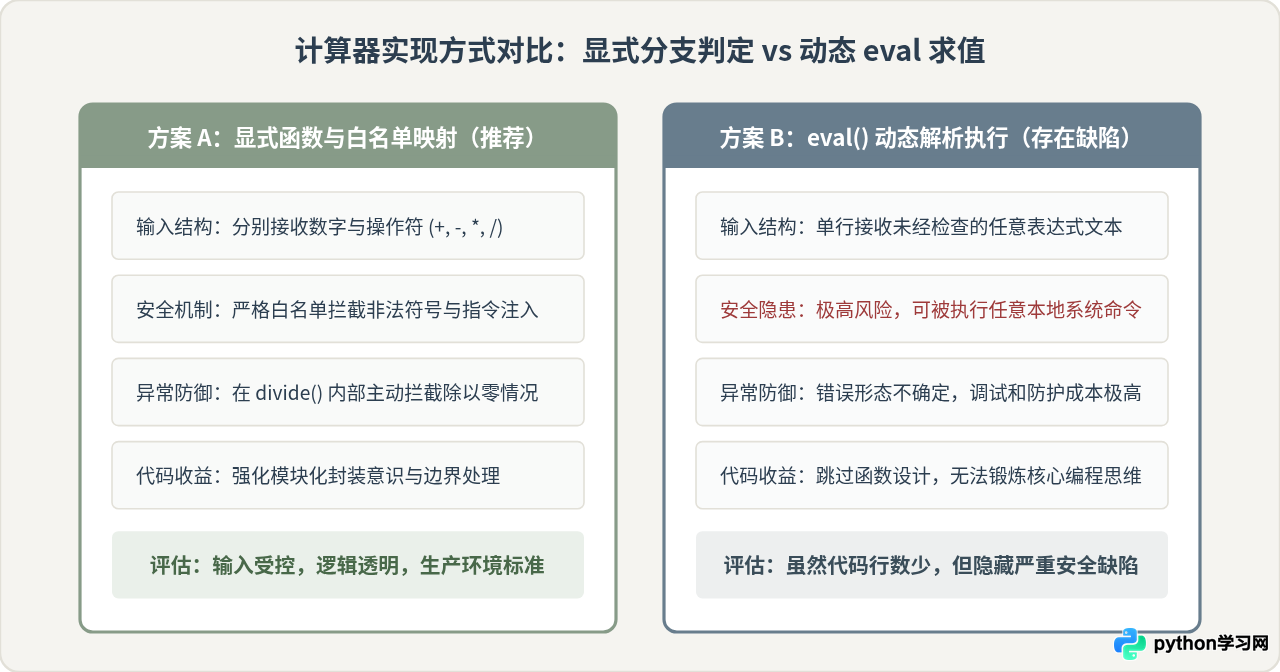
2. 两种实现方案的对比分析:显式分支 vs 动态 eval()
在初学者群体中,常常有人为了追求代码简短,直接采用内置函数 eval(input()) 来解析数学表达式。在输入条件相同的环境下,对比这两种实现方式的关键差异具有重要的工程意义:
- 安全性差异:
eval()会把传入的字符串当作 Python 原生代码执行。若恶意用户输入__import__('os').system('rm -rf /')或执行任意系统命令,程序将毫无防备地直接执行;而显式运算符分发(如字典映射或if-elif)属于严格的白名单机制,只接受预设的操作符,彻底隔绝代码注入风险。 - 错误可控性差异:
eval()在遇到除零、非法字符或语法缺失时,抛出的错误类型复杂繁多(SyntaxError、NameError、ZeroDivisionError等),初学者难以精准拦截;显式分支则在执行前完成了数据类型解析和操作符校验,异常原因清晰明了。 - 架构思维差异:显式编写加减乘除函数能帮助学习者理解形参、实参和
return返回值的流动过程,这是构建大型程序不可替代的基本功。
三、项目三:简易文本与词频统计器(巩固容器操作与数据汇总)
前两个项目侧重于数字计算与控制流。第三个项目则进入真实开发中非常频繁的领域——非结构化文本处理。通过统计输入文本的字符数、单词总数、行数以及高频词汇分布,让零基础学习者熟练运用字符串方法(split、strip)、列表和字典键值累加。
1. 完整实现代码
创建 text_analyzer.py 文件并输入:
import string

def analyze_text(text):
    if not text.strip():
        return {
            "char_count": 0,
            "word_count": 0,
            "line_count": 0,
            "top_words": []
        }

    lines = text.splitlines()
    line_count = len(lines)
    char_count = len(text)

    # 清洗标点符号并将英文转为小写
    clean_text = text.lower()
    for p in string.punctuation:
        clean_text = clean_text.replace(p, " ")

    words = [w for w in clean_text.split() if w]
    word_count = len(words)

    # 统计词频
    frequency = {}
    for word in words:
        frequency[word] = frequency.get(word, 0) + 1

    # 排序提取出现频率前 5 的高频词
    sorted_words = sorted(frequency.items(), key=lambda item: item[1], reverse=True)
    top_words = sorted_words[:5]

    return {
        "char_count": char_count,
        "word_count": word_count,
        "line_count": line_count,
        "top_words": top_words
    }

def main():
    print("=== 简易文本与词频统计器 ===")
    print("请输入需要分析的文本(输入完成后,另起一行输入 END 并回车结束):\n")

    input_lines = []
    while True:
        line = input()
        if line.strip() == "END":
            break
        input_lines.append(line)

    full_text = "\n".join(input_lines)
    result = analyze_text(full_text)

    print("\n" + "=" * 25 + " 分析报告 " + "=" * 25)
    print(f"总字符数 (含空格换行): {result['char_count']}")
    print(f"总行数:               {result['line_count']}")
    print(f"有效词数:             {result['word_count']}")
    print("-" * 60)
    print("高频词前 5 位统计:")
    if result["top_words"]:
        for rank, (word, freq) in enumerate(result["top_words"], start=1):
            print(f"  {rank}. 词语: '{word}' -> 出现 {freq} 次")
    else:
        print("  (无有效词汇)")
    print("=" * 60)

if __name__ == "__main__":
    main()
2. 核心机制解析
在处理文本时,frequency[word] = frequency.get(word, 0) + 1 这一行代码是 Python 字典计数的最经典惯用写法。dict.get(key, default) 在键不存在时返回默认值 0,避免直接访问 frequency[word] 时抛出 KeyError 异常。随后利用 sorted() 对键值对元组进行降序排序,完成了基础的数据分析流水线。
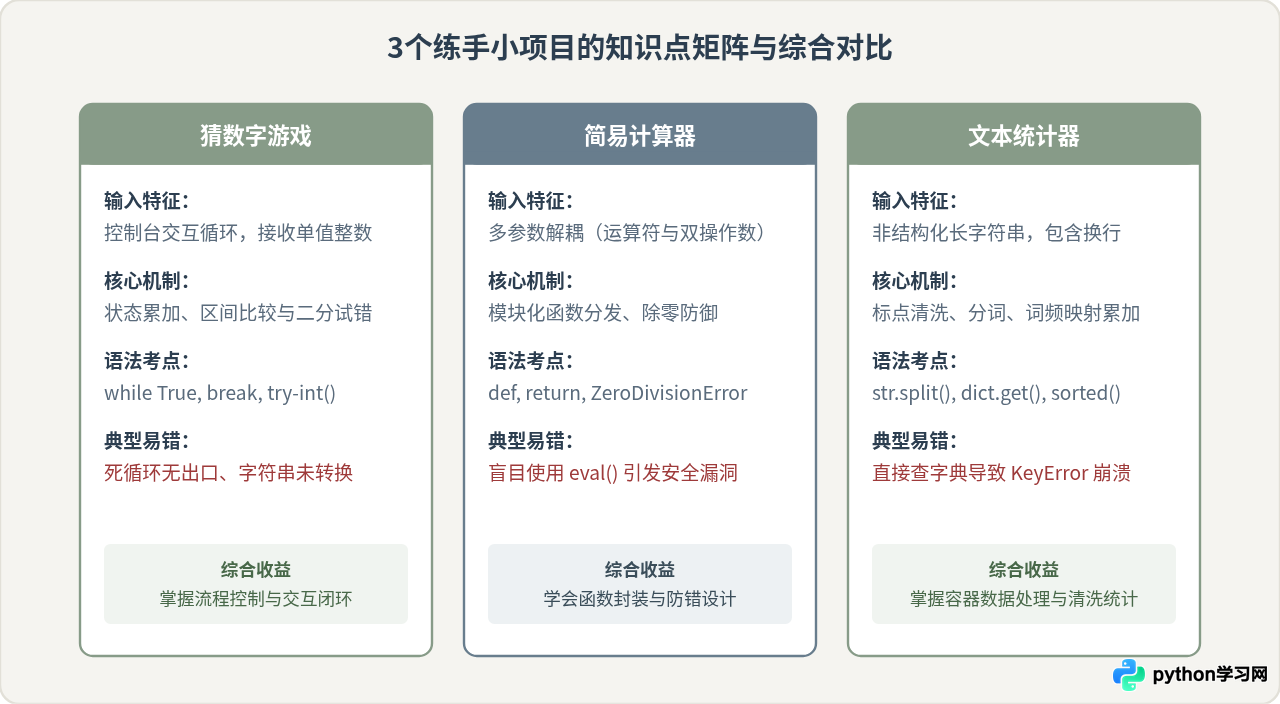
四、3个小项目的核心语法与技能维度总结
这 3 个练手项目虽然代码量均在 50 至 80 行之间,但各自承担了不同的能力训练任务。将它们横向对照,可以清晰看到编程能力的进阶层次:
3. 常见报错与实操排坑建议
- IndentationError(缩进错误):Python 依靠缩进来界定代码块。如果在
if、for或def下混用了空格和 Tab,程序会直接报错拒绝执行。建议统一在编辑器中设置 1 次 Tab 为 4 个空格。 - UnboundLocalError(局部变量未赋值):在函数内若试图修改外部全局变量,若未声明
global会报错。初学者应尽量通过函数形参传参、通过return返回结果,减少对全局变量的依赖。 - 控制流死循环:在写
while循环时,必须确保内部存在明确的break条件,或者循环所依赖的状态变量能在每轮迭代中发生改变,防止控制台进入假死卡顿。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









