

Python爬虫实现自动化资讯聚合与内容监控

假设你每天需要追踪十几个行业技术社区、官方公告栏和资讯网站,人工逐个刷新页面不仅耗时漫长,还极易遗漏关键更新。通过编写一套专用的 Python 爬虫管道,定时抓取目标站点、解析提取新增条目、通过特征哈希去重比对,并在检测到特定关键词或新发布内容时向协同软件推送消息,即可实现全自动化的资讯聚合与精准内容监控。
一、系统总体架构与运作流程
一套可稳定运行的资讯监控系统,不能只依赖单次脚本抓取,而需要拆分为采集、解析、去重、持久化与告警五个清晰独立的层级。这种松耦合设计使得新增监测源或更换推送渠道时无需改动核心调度逻辑。
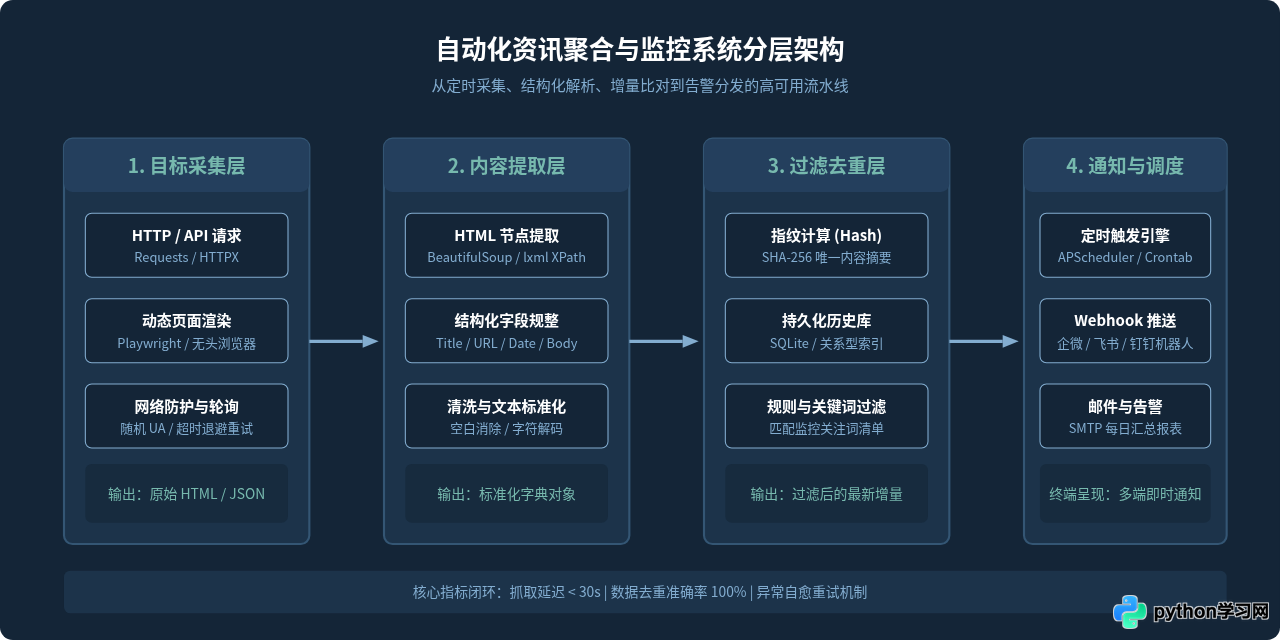
在上述架构中,数据沿着确定性的管道从左向右单向流动。每一轮调度启动时,采集器仅负责获取原始网络资源;解析器提取规范化的结构体;去重模块对条目进行哈希比对并写入本地持久化数据库;一旦判定存在符合监控条件的新条目,立即打包并经由 Webhook 接口投递到即时通讯群组。
二、目标站点请求与结构化解析
构建采集模块的核心原则是“轻量、稳定、低侵入”。多数资讯站点的列表页直接包含标题、超链接和发布时间,因此使用标准的 HTTP 客户端搭配 HTML 解析库即可高效提取所需字段。
1. 网络请求与异常重试封装
网络环境存在偶发波动,爬虫在请求外部站点时必须设置严格的超时阈值并配置合理的重试机制,避免因单个站点挂起导致整个监控任务阻塞。
import time
import requests
from typing import Optional

def fetch_html(url: str, timeout: int = 10, max_retries: int = 3) -> Optional[str]:
    """
    抓取指定 URL 的 HTML 源码,具备请求头伪装与失败退避重试能力
    """
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                      "(KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
    }

    for attempt in range(1, max_retries + 1):
        try:
            response = requests.get(url, headers=headers, timeout=timeout)
            if response.status_code == 200:
                response.encoding = response.apparent_encoding or "utf-8"
                return response.text
            elif response.status_code in (403, 404):
                # 客户端权限或路径错误,重试无意义
                return None
        except requests.RequestException:
            if attempt == max_retries:
                return None
            time.sleep(attempt * 2)  # 指数退避等待
    return None
2. 结构化字段解析
获取到 HTML 文本后,使用 BeautifulSoup 定位列表条目并提取元数据。为了保证数据后续处理的规范性,提取到的结果统一封装为包含 title、url、published_at 和 source 的标准字典列表。
from bs4 import BeautifulSoup
from urllib.parse import urljoin
from typing import List, Dict

def parse_news_items(html_content: str, base_url: str) -> List[Dict[str, str]]:
    """
    解析列表页中的文章条目,提取标准字段
    """
    soup = BeautifulSoup(html_content, "html.parser")
    news_list = []

    # 针对目标列表容器进行选择(实际项目中替换为对应站点的 CSS 选择器)
    articles = soup.select("article.post-item, div.news-card, li.article-item")

    for article in articles:
        title_tag = article.select_one("h2 a, .title a, a.news-link")
        time_tag = article.select_one("time, span.pub-date, .date")

        if not title_tag:
            continue

        title = title_tag.get_text(strip=True)
        link = title_tag.get("href", "").strip()
        pub_time = time_tag.get_text(strip=True) if time_tag else "未知时间"

        if title and link:
            # 补全相对路径为完整绝对 URL
            full_url = urljoin(base_url, link)
            news_list.append({
                "title": title,
                "url": full_url,
                "published_at": pub_time,
                "source": base_url
            })

    return news_list
三、增量比对与内容指纹去重机制
自动化资讯监控的核心难点不在于“抓取”,而在于“去重”。如果每次轮询都把抓取到的所有条目全部处理一遍,会导致严重的重复推送。因此,系统必须建立一套可靠的去重机制。
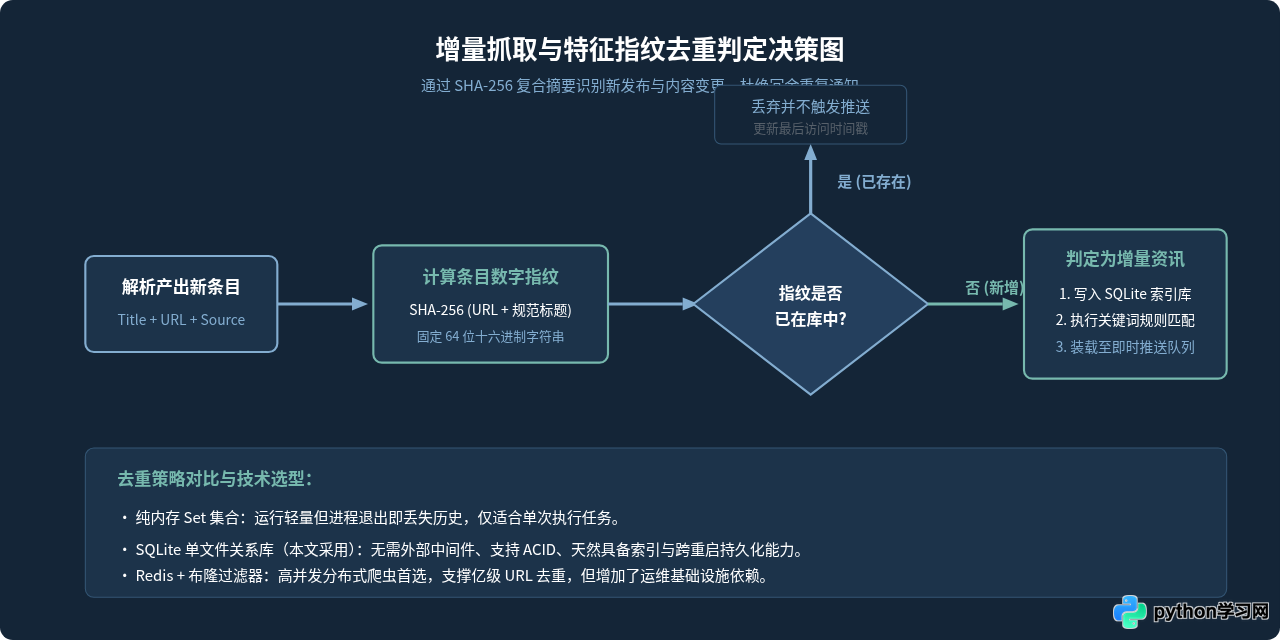
为了让系统在重启后仍能保持去重状态,推荐使用内置的 SQLite 数据库。每个条目的 URL 结合标题经过 SHA-256 计算后作为主键保存:
import hashlib
import sqlite3
from typing import Dict, Tuple

class NewsStorage:
    def __init__(self, db_path: str = "news_monitor.db"):
        self.db_path = db_path
        self._init_db()

    def _init_db(self):
        with sqlite3.connect(self.db_path) as conn:
            conn.execute("""
                CREATE TABLE IF NOT EXISTS processed_news (
                    hash_id TEXT PRIMARY KEY,
                    title TEXT NOT NULL,
                    url TEXT NOT NULL,
                    source TEXT,
                    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
                )
            """)
            conn.commit()

    @staticmethod
    def calculate_hash(url: str, title: str) -> str:
        """根据 URL 与标题生成唯一的 SHA-256 指纹"""
        raw = f"{url.strip()}::{title.strip()}"
        return hashlib.sha256(raw.encode("utf-8")).hexdigest()

    def is_new_item(self, item: Dict[str, str]) -> Tuple[bool, str]:
        """
        检查条目是否为新内容;若为新条目则记录指纹并返回 True
        """
        h_id = self.calculate_hash(item["url"], item["title"])
        with sqlite3.connect(self.db_path) as conn:
            cursor = conn.cursor()
            cursor.execute("SELECT 1 FROM processed_news WHERE hash_id = ?", (h_id,))
            exists = cursor.fetchone()
            if exists:
                return False, h_id

            cursor.execute(
                "INSERT INTO processed_news (hash_id, title, url, source) VALUES (?, ?, ?, ?)",
                (h_id, item["title"], item["url"], item.get("source", ""))
            )
            conn.commit()
            return True, h_id
四、自动化定时调度与告警推送实现
完成抓取与去重后,最后一步是将任务周期性调度起来,并在过滤出目标资讯时实时分发。我们使用轻量且强大的 APScheduler 库实现后台定时轮询,并通过企业微信或飞书 Webhook 机器人实现零延迟推送。
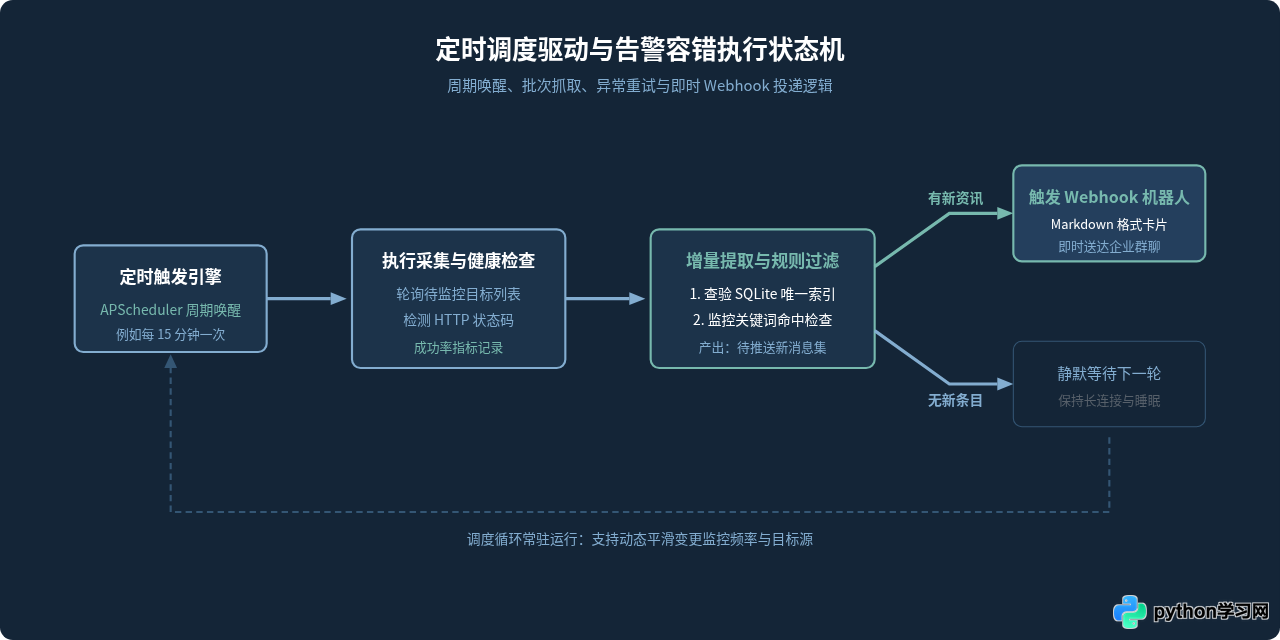
1. Webhook 消息通知模块
以下代码以企业微信机器人为例,演示如何将结构化资讯拼接为 Markdown 格式并执行推送:
def send_webhook_alert(webhook_url: str, title: str, url: str, source: str) -> bool:
    """
    通过企业微信 Webhook 发送 Markdown 格式的新闻卡片
    """
    markdown_content = (
        f"### 🔔 监测到关注资讯更新\n"
        f"**标题:** [{title}]({url})\n"
        f"**来源站点:** {source}\n"
        f"**发现时间:** {time.strftime('%Y-%m-%d %H:%M:%S')}\n\n"
        f"> 请及时查阅相关动态"
    )

    payload = {
        "msgtype": "markdown",
        "markdown": {
            "content": markdown_content
        }
    }

    try:
        res = requests.post(webhook_url, json=payload, timeout=8)
        return res.status_code == 200 and res.json().get("errcode") == 0
    except requests.RequestException:
        return False
2. 整合定时监控主程序
将上述所有组件拼装为完整的巡检服务,监控程序将按指定间隔持续在后台运行:
from apscheduler.schedulers.blocking import BlockingScheduler

def monitor_job():
    """单次监控巡检任务"""
    target_urls = [
        "https://example.com/tech-news",
        "https://example.com/sec-bulletin"
    ]
    webhook_url = "https://qyapi.weixin.qq.com/cgi-bin/webhook/send?key=YOUR_KEY"
    keywords = ["安全", "更新", "Python", "发布", "漏洞"]

    storage = NewsStorage()

    for url in target_urls:
        html = fetch_html(url)
        if not html:
            continue

        items = parse_news_items(html, base_url=url)
        for item in items:
            # 关键词前置过滤(若无需关键词匹配,可移除该判断)
            if not any(kw in item["title"] for kw in keywords):
                continue

            # 去重判断
            is_new, _ = storage.is_new_item(item)
            if is_new:
                # 触发告警通知
                send_webhook_alert(
                    webhook_url=webhook_url,
                    title=item["title"],
                    url=item["url"],
                    source=item["source"]
                )
                time.sleep(1)  # 避免瞬间触发群机器人频率限制

if __name__ == "__main__":
    scheduler = BlockingScheduler()
    # 每 10 分钟自动执行一次全量巡检
    scheduler.add_job(monitor_job, "interval", minutes=10, next_run_time=None)

    # 立即先执行一次初始化巡检
    monitor_job()

    try:
        scheduler.start()
    except (KeyboardInterrupt, SystemExit):
        pass
五、生产环境部署与稳定性保障
在将监控系统部署至服务器长期驻留运行前,需要针对反爬策略、解析鲁棒性和存储维护做好防护设计,确保脚本在无人值守时持续可用。
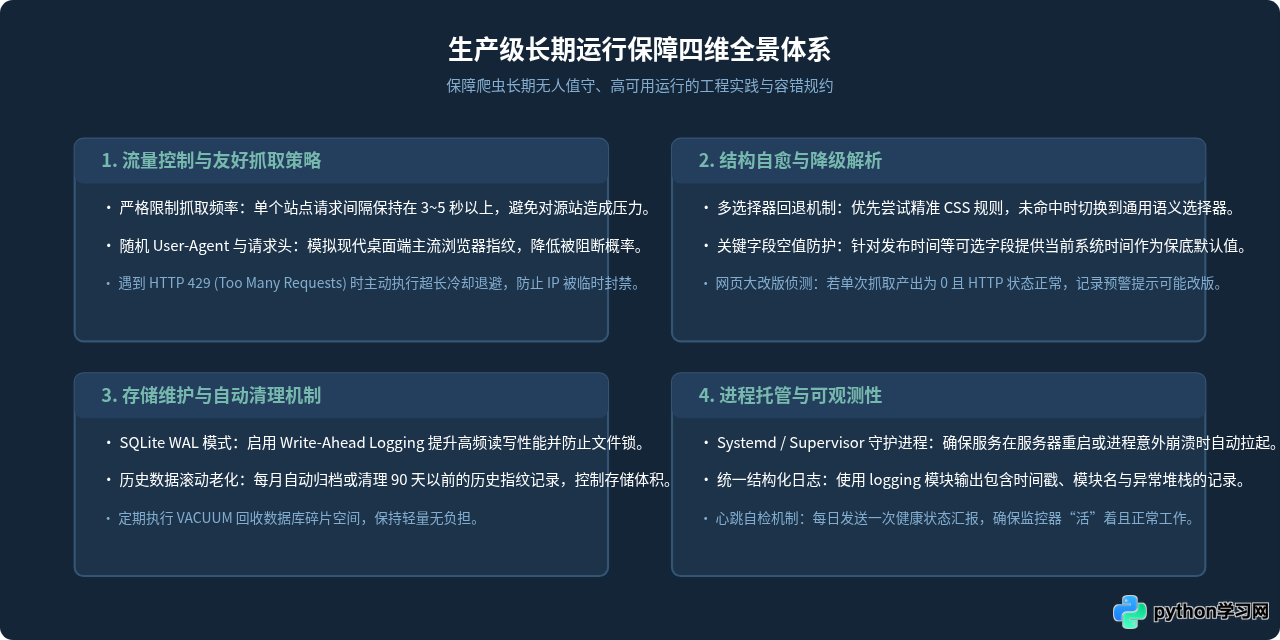
feedparser 库解析标准订阅源,这比直接爬取解析 HTML 具备更高的稳定性和抗改版能力;当目标源没有提供 RSS 时,再使用上述针对性的网页爬虫方案。
六、常见问题排查与验证
- 问题 1:新发布的文章没有收到推送?
排查顺序:首先检查processed_news数据库中是否已存在该条目的哈希指纹;其次确认是否设置了过于苛刻的关键词过滤规则;最后测试 Webhook 地址是否因频控限制(如单分钟超过 20 条)被服务端拒绝。 - 问题 2:每次轮询都重复推送相同的文章?
原因通常出在指纹计算逻辑中混入了动态变化的字段(例如包含了带时间戳的推荐参数 URL 或相对时间的字符串)。解决方案是将 URL 中的查询参数(如?from=timeline等追踪参数)去除,仅使用规范化后的原始路径与静态标题进行哈希计算。 - 问题 3:目标网站内容由 JavaScript 异步加载,BeautifulSoup 抓取为空?
打开浏览器开发者工具的 Network 面板,查看页面渲染时请求的 Fetch/XHR 接口,往往能直接找到返回 JSON 数据的后端 API;如果目标接口有高强度动态签名验证,可改用Playwright无头浏览器等待内容渲染完毕后再提取 HTML 节点。
通过本文介绍的系统方案,我们可以用百余行简洁可靠的 Python 代码构建起一个功能齐备的资讯聚合与内容监控引擎。它不仅能帮助个人或团队高效追踪关键技术前沿和行业变动,更具备清晰的架构扩展性,能够平滑接入更多的监控源与通知渠道。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









