

Python用字典构建API请求参数的正确写法

在调用外部 HTTP API 时,你可能遇到过这样的情景:为了传递过滤条件或分页信息,随手写了 f"https://api.example.com/items?status={status}&page={page}",结果当用户输入的变量包含空格、中文字符或符号时,URL 无法正常解析;又或者某个可选参数为 None,直接拼进 URL 变成了 status=None,导致接口返回 400 校验错误。在 Python 中,构建 API 请求参数最可靠、最标准的方式是使用字典(dict)配合专业的 HTTP 客户端库(如 requests 或 httpx)。本文将详细讲解如何正确使用字典组织、清洗和提交请求参数,帮助你避开类型转换与编码陷阱。
一、理清参数传递位置:Query 参数与 Request Body
使用字典构建参数前,必须首先明确参数应该放在 HTTP 协议的哪个位置。许多接口调用失败并非字典写错了,而是将字典传给了错误的请求参数槽位。在主流库 requests 中,常见的传参方式有三种:
params=param_dict(查询字符串 / Query String):参数会被自动转义并拼接到 URL 问号后面,通常用于GET、DELETE请求,用于筛选、分页和排序。json=payload_dict(JSON 格式请求体):请求头会自动附带Content-Type: application/json,字典会被自动序列化为 JSON 字符串,常用于POST、PUT、PATCH请求提交结构化业务数据。data=payload_dict(表单编码请求体):请求头默认为application/x-www-form-urlencoded,字典会被编码为键值对表单数据,常用于传统 Web 表单提交或文件上传附属字段。
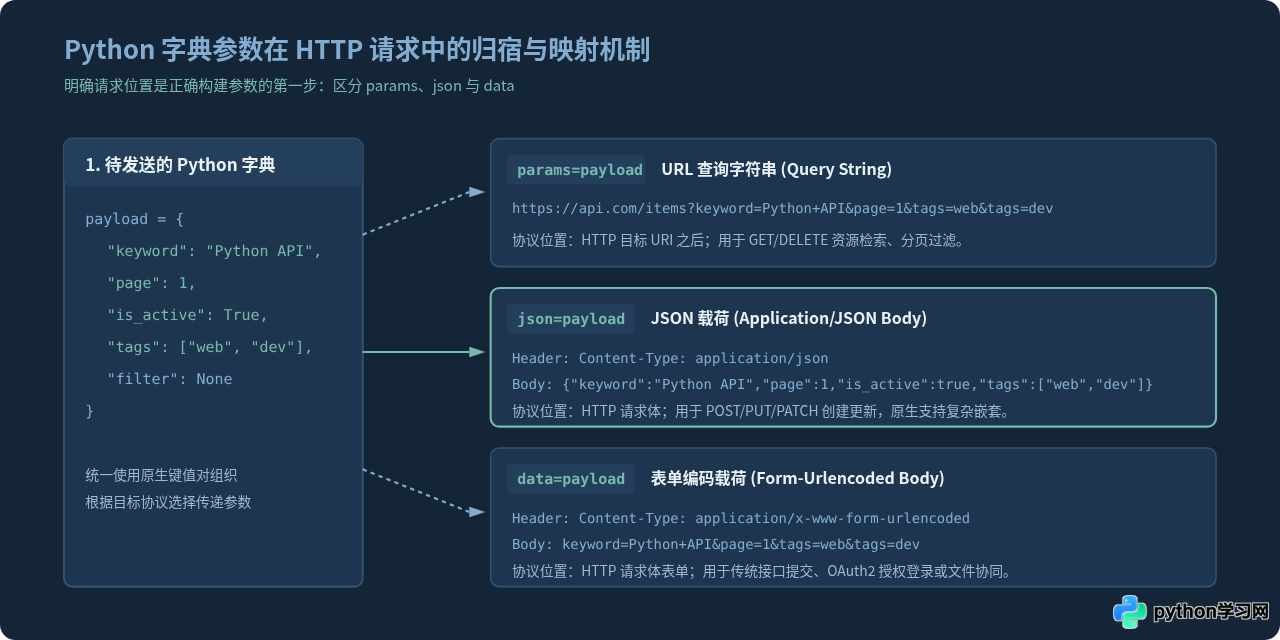
在实际开发中,最核心的一条规则是:绝不要手动拼接查询字符串,始终将字典传给客户端的专有参数槽位。当传给 params 时,库会自动根据 RFC 3986 规范执行百分号编码(Percent-Encoding),将空格转为 + 或 %20,特殊字符转为安全字节,从根本上杜绝 URL 格式错误。
二、用字典构建 Query 参数的规范步骤与清洗
在面向搜索、列表拉取等场景时,查询参数往往是动态多变的。有的条件有输入才查,没输入则不传。如果把带有空值的字典直接传给接口,很容易产生意外行为。
1. 动态装配参数字典
规范的做法是先初始化必要的基础参数(如固定版本号、鉴权 app_id、默认分页大小),然后根据业务变量按需挂载条件:
# 推荐做法:动态组装
params = {
    "page": 1,
    "page_size": 20,
}

if keyword:
    params["q"] = keyword.strip()
if category_id is not None:
    params["category_id"] = category_id
2. 空值与 None 的安全过滤
很多开发者习惯一次性定义包含全部字段的字典模板。当部分变量为 None 时,必须进行清洗。虽然 requests 在序列化 params 时会自动跳过值为 None 的键,但在调用自定义序列化方法或转换其他结构时,显式清洗能避免混淆并确保逻辑确定性:
raw_params = {
    "search": user_input_search,    # 可能为 None 或 ""
    "status": selected_status,      # 可能为 None
    "limit": 10
}

# 过滤掉所有值为 None 的键
clean_params = {k: v for k, v in raw_params.items() if v is not None}

# 若业务要求同时剔除空字符串:
clean_params = {k: v for k, v in raw_params.items() if v not in (None, "")}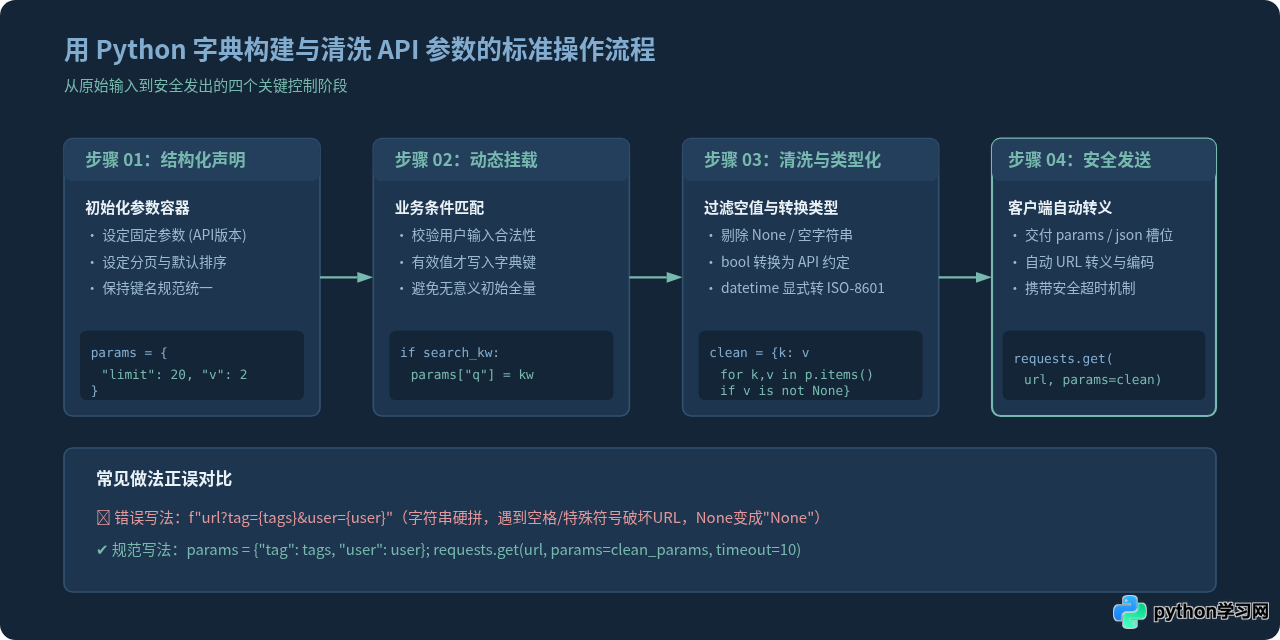
三、核心数据类型的转换陷阱与避坑准则
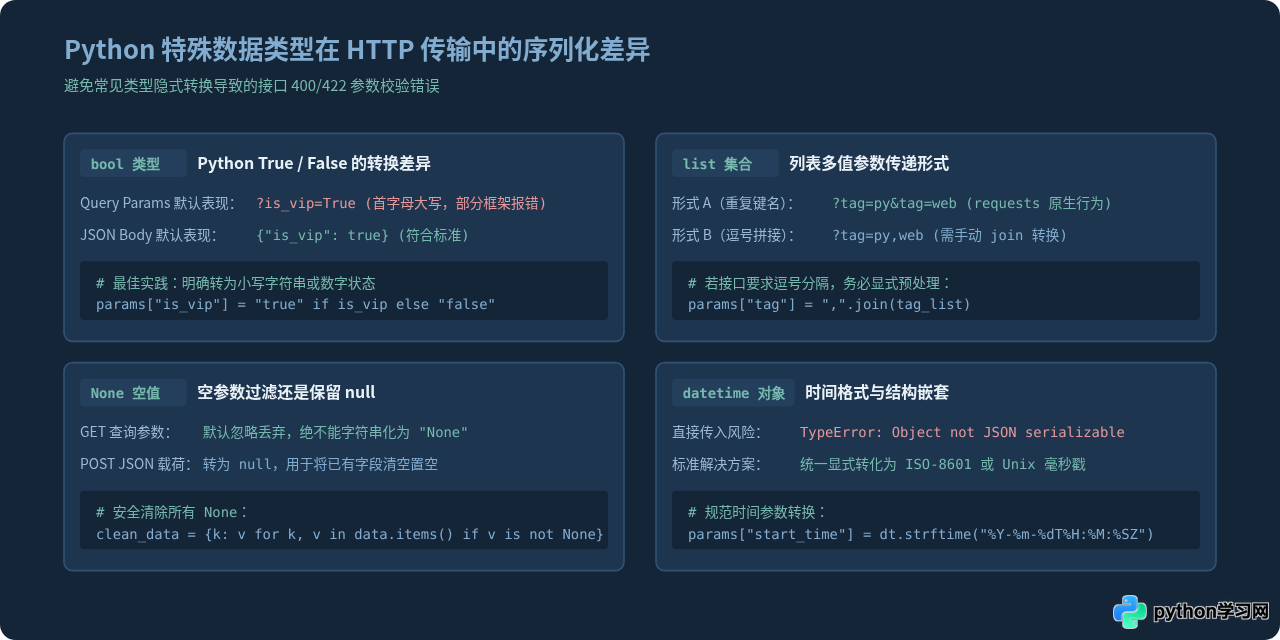
在 Python 字典中,数据通常包含字符串、数值、布尔值(bool)、空值(None)、列表(list)以及时间对象(datetime)。当这些类型经由 HTTP 传输时,不同接口规范对此有截然不同的要求。
在 Python 中布尔值为 True 和 False。若将 {"active": True} 直接放入 params,requests 会将其转换为字符串 active=True。然而,大部分后端(如 Go、Spring Boot、Node.js、FastAPI)默认只接受小写 true 或 false,甚至将大写 True 判定为校验错误。在放入 params 前,应显式转为小写字符串或整数 1/0。
| Python 字典类型 | 作为 Query Params (GET) 的默认行为 | 作为 JSON Body (POST) 的行为 | 工程化推荐正确写法 |
|---|---|---|---|
None |
requests 自动剔除该键,不拼接 |
序列化为 JSON 规范的 null |
提前使用推导式过滤,或根据文档保留 |
bool (True/False) |
转为字符串 "True" / "False" |
序列化为原生布尔 true / false |
Query 时显式写为 str(val).lower() 或 int(val) |
list ["a", "b"] |
默认拆分成多键 tag=a&tag=b |
序列化为 JSON 数组 ["a", "b"] |
确认接口是要求多键还是逗号拼接 ",".join(list) |
datetime 对象 |
直接报错 TypeError 或转为不可读字符串 |
无法被默认 json.dumps 序列化抛出异常 |
统一转为 dt.isoformat() 或时间戳数字 |
四、工程化完整示例:参数构建、签名与请求发送
在企业级开发中,我们往往需要实现更严谨的流程:校验入参结构、过滤无用键、进行 API 签名(很多金融或开放平台要求对所有 Query 参数按照键名 ASCII 升序排序并计算 HMAC/MD5 摘要)。
下面是一个经过工程检验的完整封装示例:
import hashlib
import time
from typing import Any, Dict
import requests


def build_safe_api_params(
    raw_params: Dict[str, Any],
    api_secret: str = None
) -> Dict[str, Any]:
    """
    清洗并构建 API 请求参数字典:
    1. 过滤 None 与空字符串
    2. 统一布尔值及常用类型
    3. 可选:按字典序对参数进行 Hash 签名
    """
    clean_params: Dict[str, Any] = {}

    for key, value in raw_params.items():
        if value is None or value == "":
            continue

        # 布尔类型转为小写字符串
        if isinstance(value, bool):
            clean_params[key] = "true" if value else "false"
        # 列表若需逗号连接可在此统一处理
        elif isinstance(value, (list, tuple)):
            clean_params[key] = ",".join(str(item) for item in value)
        else:
            clean_params[key] = value

    # 若需要 API 签名校验(常见防篡改机制)
    if api_secret:
        clean_params["timestamp"] = int(time.time())
        # 按照 key 的 ASCII 顺序排序
        sorted_items = sorted(clean_params.items(), key=lambda x: x[0])
        # 拼接签名原文字符串: key1=val1&key2=val2...
        sign_str = "&".join(f"{k}={v}" for k, v in sorted_items) + api_secret
        clean_params["sign"] = hashlib.sha256(sign_str.encode("utf-8")).hexdigest()

    return clean_params


# 调用示例
if __name__ == "__main__":
    target_url = "https://api.example.com/v1/search"

    # 用户给出的原始参数(包含各种边界类型)
    user_inputs = {
        "keyword": "Python 教程",
        "category": "backend",
        "tags": ["web", "network"],
        "is_archived": False,
        "author": None,       # 应当被过滤
        "extra_info": "",     # 应当被过滤
    }

    # 1. 规整字典
    final_params = build_safe_api_params(user_inputs, api_secret="SECRET_KEY_123")

    # 2. 安全发出请求(自带连接与读取超时)
    try:
        response = requests.get(
            url=target_url,
            params=final_params,
            headers={"User-Agent": "MyApiClient/1.0"},
            timeout=(3.05, 10)  # 连接超时3.05秒,读取超时10秒
        )
        response.raise_for_status()
        result_data = response.json()
        print("请求成功,状态码:", response.status_code)
    except requests.exceptions.RequestException as err:
        print("API 请求异常:", err)
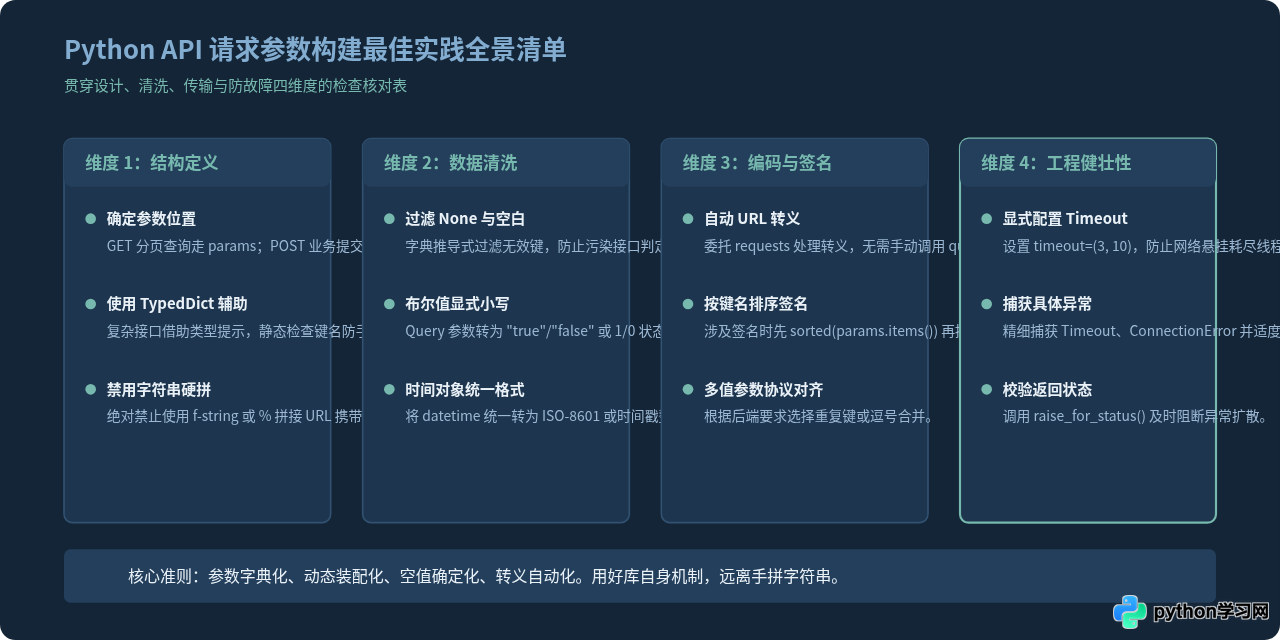
五、构建 API 请求参数的全局检查清单
为了保证每次写出健壮、可维护的 API 调用代码,建议在提交代码前比照以下四层检查模型:
六、高频常见问题解答(FAQ)
Q1: 字典中包含中文或特殊字符(如 @、#、&),需要自己调用 urllib.parse.quote 吗?
不需要。 如果将字典传递给 requests.get(url, params=my_dict),requests 内部会自动调用标准编码器处理所有的特殊字符。如果你提前手动调用了 quote(),库在二次处理时会将 % 转义为 %25,从而导致“双重转义(Double Encoding)”,使服务端拿到错误的乱码内容。
Q2: 如果后端接口要求同名参数重复出现(如 ?status=1&status=2&status=3),字典该如何表示?
Python 字典的键是唯一的,不能直接写相同的 Key。但 requests 深度支持列表作为字典的值:只需要写成 params = {"status": [1, 2, 3]},库在构建 URL 时就会自动将其展开为 status=1&status=2&status=3。
Q3: 如果请求体(Request Body)需要复杂的嵌套列表和多层字典,该用 data 还是 json?
必须使用 json=my_dict。因为 data=my_dict 执行的是表单编码,无法正确表达多层嵌套的复杂层级;而 json=my_dict 会递归序列化整棵数据树,并自动附带 application/json 请求头,这正是现代化微服务与 RESTful API 的推荐交互标准。
七、总结
在 Python 中用字典构建 API 请求参数,是编写高可用、高扩展网络调用代码的基础。牢记三个核心动作:一选准槽位(params 还是 json)、二推导清洗(过滤 None 与规范布尔值)、三委托转义(交由请求库处理 URL 编码与超时)。遵循这套规范,就能写出结构清晰、无惧特殊字符且健壮优雅的 API 请求逻辑。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









