

学习Python爬虫对职业发展有帮助吗?数据分析师技能需求解析

一、数据分析师的真实岗位技能图谱
评估一项技能是否值得投入,首先需要明确目标岗位的评价标准。在绝大多数企业中,数据分析师的核心考核指标是“能否利用数据解决业务问题并推动决策”,而非“能否编写高并发的数据采集系统”。
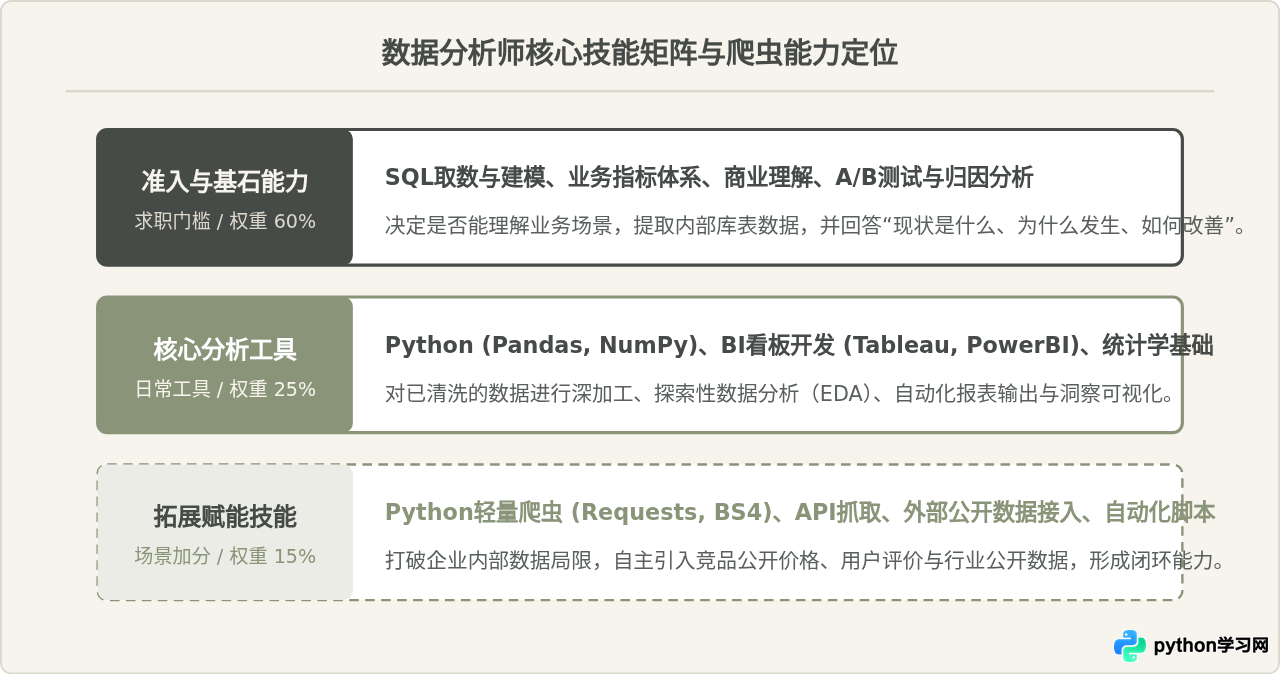
企业现存的数据体系通常由数据工程团队搭建,通过数据湖、数据仓库(如 Hive、ClickHouse、Snowflake)完成沉淀。数据分析师的日常操作是在这些库表中完成关联提取、统计指标计算与趋势分析。因此,核心技能栈呈明显的层级结构:
二、关于“爬虫与数据分析”的常见认知辨析
初学者和转行人员常常听到两极分化的言论。厘清这些说法的成立条件,有助于准确定位学习时间:
1. 误区一:“掌握爬虫才算精通Python数据分析”
辨析:这种观点混淆了“数据采集工程”与“数据分析挖掘”。在数据分析岗位面试中,考官考察Python时,主要考察能否使用Pandas熟练处理缺失值、分组聚合、时序转换和多表关联。爬虫技术(如Scrapy框架、IP池调度)属于网络爬虫开发工程师的专项领域。如果你能爬取海量页面,却无法解释数据的业务异常原因,无法算作合格的数据分析师。
2. 误区二:“公司都有现成数据,学爬虫毫无用处”
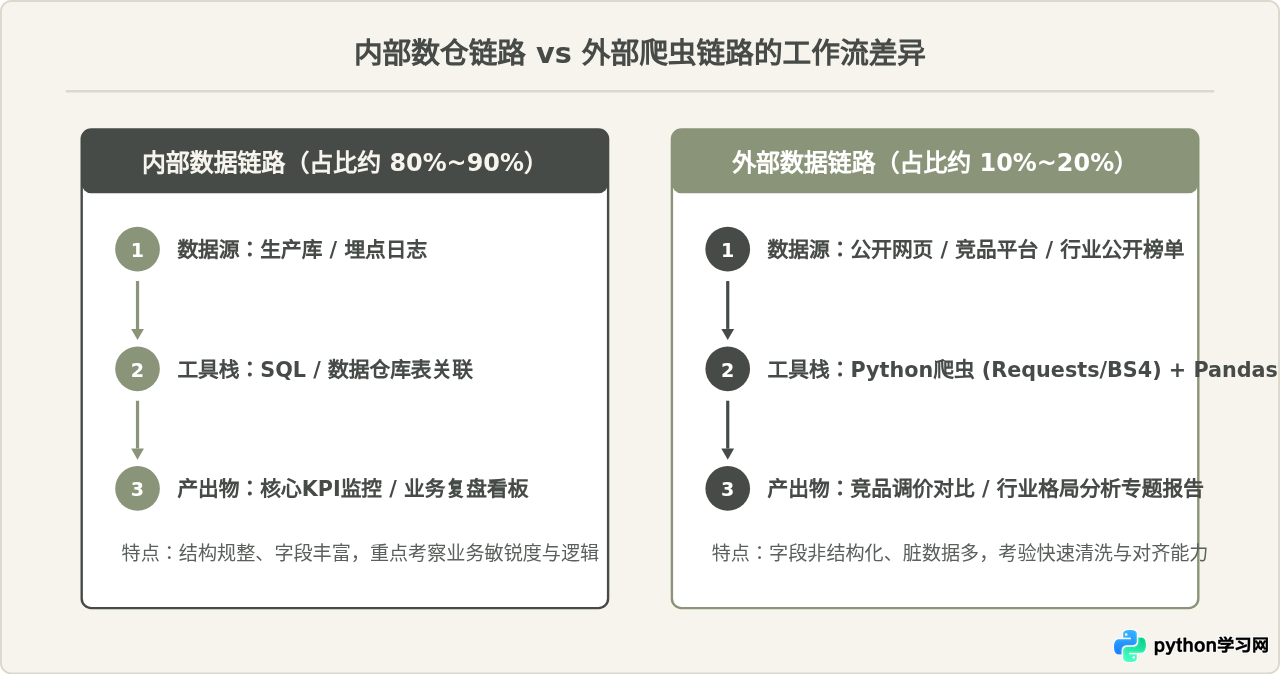
辨析:这种说法只在大厂极其成熟的内部业务线才完全成立。当分析师需要回答“竞争对手近期是否调整了商品SKU价格策略?”、“行业近期热门社交话题走势如何?”等外部市场问题时,企业内部数据仓库是不存在这些外部事实的。此时若具备轻量采集能力,分析师无需排期等待工程开发,当天即可采集样本展开分析,这就是显著的个人竞争壁垒。
三、爬虫技能对数据分析师的四大实用价值
在以下具体业务环境中,掌握基础爬虫能显著提升分析师的独立交付能力:
- 竞品动态监测与定价策略:在电商、消费品与OTA行业,分析师可以通过定时获取竞对公开售价、促销机制与好评标签,为业务部门提供实时的动态调价建议。
- 舆情分析与自然语言文本获取:在品牌营销分析中,内部只有订单转化数据,缺乏消费者真实心声。抓取社交平台、垂直论坛的公开讨论文本,能为NLP情感分析与主题词提取提供原始素材。
- 初创团队与中小企业破局:创业公司尚未建立完善的数据工程体系,也缺乏采购昂贵第三方行业数据库的预算。具备采集能力的分析师能够一人搞定“抓取-清洗-建模-汇报”,性价比优势明显。
- 求职面试中的项目差异化:招聘者看惯了公开数据集(如泰坦尼克号生存预测、波士顿房价),如果求职者能展示一份“自主采集某行业公开数据、完成数据清洗并得出商业洞察”的完整项目,往往能直观证明其实践动手能力。
四、分析师该掌握怎样的爬虫?操作步骤与代码示例
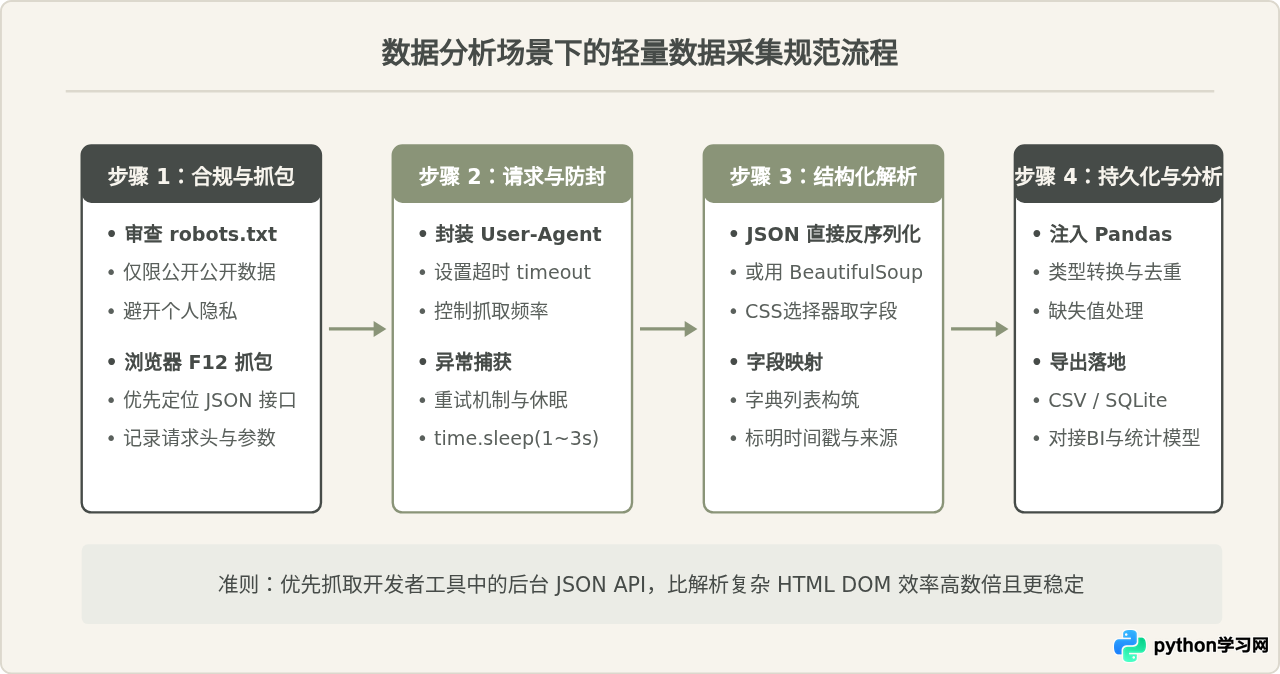
数据分析师学习爬虫的目标是“以最低成本获取结构化数据”,而非设计高防风控对抗系统。通常掌握 requests(发送网络请求)、BeautifulSoup 或直接解析 JSON API,配合 pandas 即可满足90%的需求。
标准采集与入库示例代码
以下代码演示了分析师抓取公开行业价格行情、提取字段并快速转为 Pandas DataFrame 进行清洗的标准过程:
import time
import requests
from bs4 import BeautifulSoup
import pandas as pd

def fetch_market_quotes():
    # 模拟目标公开行情页面
    target_url = "https://example-quotes.local/commodities"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept-Language": "zh-CN,zh;q=0.9"
    }

    try:
        response = requests.get(target_url, headers=headers, timeout=10)
        response.raise_for_status()
    except requests.exceptions.RequestException as error:
        print(f"网络请求失败: {error}")
        return pd.DataFrame()

    soup = BeautifulSoup(response.text, "html.parser")
    rows = soup.select("table.market-table tbody tr")

    extracted_records = []
    for row in rows:
        cells = row.find_all("td")
        if len(cells) >= 4:
            item_name = cells[0].get_text(strip=True)
            price_str = cells[1].get_text(strip=True).replace("¥", "").replace(",", "")
            change_str = cells[2].get_text(strip=True).replace("%", "")
            update_date = cells[3].get_text(strip=True)

            extracted_records.append({
                "product_name": item_name,
                "price": price_str,
                "change_percent": change_str,
                "record_date": update_date
            })

    # 转化为分析所需的数据结构
    df = pd.DataFrame(extracted_records)
    if not df.empty:
        # 数据类型清洗与转换
        df["price"] = pd.to_numeric(df["price"], errors="coerce")
        df["change_percent"] = pd.to_numeric(df["change_percent"], errors="coerce")
        df["record_date"] = pd.to_datetime(df["record_date"], errors="coerce")
        # 过滤掉价格为空的无效记录
        df = df.dropna(subset=["price"])

    return df

if __name__ == "__main__":
    df_result = fetch_market_quotes()
    print("示例数据预览:")
    print(df_result.head())
    # 落地存储,便于后续与内部业务表进行JOIN关联
    # df_result.to_csv("external_quotes.csv", index=False)
1. 合规底线:爬虫只能用于抓取公开可见、非用户隐私且非商业机密的信息,严格遵守 robots.txt,禁止抓取验证码后的个人账户信息或未授权接口。
2. 请求频率克制:每次请求之间务必添加 time.sleep() 延时(通常1~3秒),切勿无节制高并发请求,避免对目标服务器造成负载压力。
五、技能投入与学习决策指南
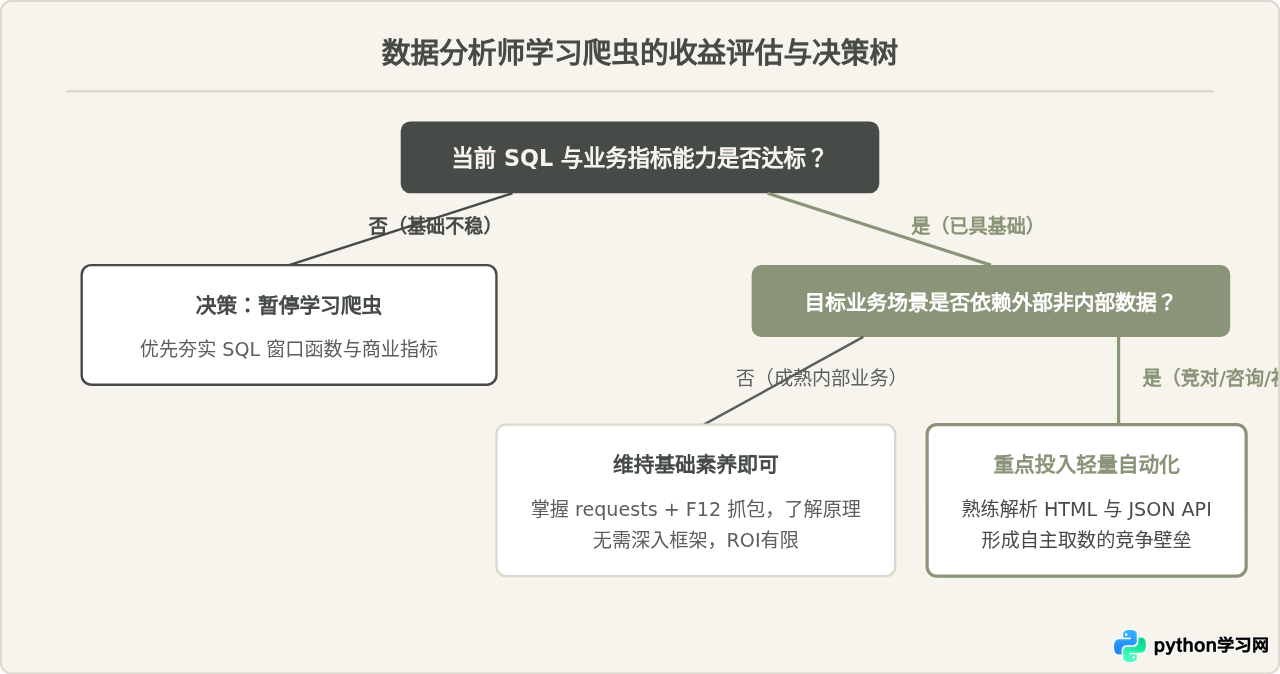
学习任何技术都存在机会成本。将过多的精力投入在与高级反爬机制(如验证码滑块破解、JS混淆逆向、移动端Hook)的对抗中,会直接挤占学习核心统计推断、实验设计与商业分析的时间。
不同发展方向的建议对比
| 分析师定位 | 对爬虫技能的需求程度 | 建议掌握的技术范围 | 精力分配优先级 |
|---|---|---|---|
| 业务运营分析师(成熟电商/互联网大厂) | 较低(数仓已覆盖95%以上字段) | 了解 HTTP 协议与网页基础结构,能阅读公开 API 文档 | SQL > 业务逻辑 > 指标拆解 > 爬虫 |
| 市场与竞品分析师(咨询/零售/出海业务) | 较高(需高频监控外部竞对变动) | Requests、BeautifulSoup、Selenium 轻量自动化操作 | 市场认知 > 爬虫采集 > 文本挖掘 > SQL |
| 初创团队全栈分析师(中小企业/早期项目) | 极高(无专职数仓团队支持) | 端到端采集、定时任务调度、清洗后入 SQLite/Postgres | 全链路交付能力 > 爬虫采集 > BI看板 |
六、总结与落地建议
回到核心问题:“学习Python爬虫对职业发展有帮助吗?”
答案是肯定的,但它的价值取决于你所处的阶段:
- 初学者与求职转行者:不要将爬虫作为核心卖点。企业招聘初级分析师,考察的是 SQL 查询编写、指标异动排查和业务归因能力。过早投入大量时间研究反爬反作弊,属于典型的投入产出比错位。
- 进阶与资深分析师:当你的内部数据分析能力遇到天花板时,爬虫是一把打开外部数据世界的钥匙。掌握轻量级的网络采集,能帮助你跳出“内部自嗨”的局限,用竞品与全行业的一手客观数据支撑更宏观的商业洞察。
理性的技术成长路径应当是:“以 SQL 和商业逻辑为根基,以 Python 和统计方法为工具,以轻量爬虫为延伸触手”。在明确边界的前提下掌握它,方能发挥其最大的职业杠杆价值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









