

Python splitlines()与split('\n')处理换行符有何不同

在 Python 文本处理中,str.splitlines() 与 str.split('\n') 最核心的区别在于语义模型与换行符识别范围的不同:split('\n') 是严格基于单字符定界的机械切分操作,将 \n 视为两个独立数据片段之间的连字符,一旦文本末尾带有换行符,其右侧就会被判定为一个独立的空字符串 "",且它完全无法识别 Windows 的 \r\n 或老旧系统的 \r;而 splitlines() 是专门面向行语义设计的解析器,原生将末尾换行符视作该行的闭合标记而非产生新行,同时支持通用换行符协议(Universal Newlines),并允许通过参数保留原始换行符。
一、从一个隐蔽现象切入:末尾换行引发的“空行幽灵”
在日常解析配置文件、网络日志或用户提交的表单时,最常见的一类细微异常便是多出一个空白行。观察以下看似等价的切分代码:
raw_text = "第一行\n第二行\n"

result_split = raw_text.split('\n')
result_splitlines = raw_text.splitlines()

print("split('\\n') 结果:", result_split)
# 示例输出: ['第一行', '第二行', ''] (列表长度为 3)

print("splitlines() 结果:", result_splitlines)
# 示例输出: ['第一行', '第二行'] (列表长度为 2)当文本末尾包含标准换行符时,split('\n') 生成了 3 个元素,末尾携带一个空字符串 "";而 splitlines() 则得到 2 个有效行。如果后续逻辑依赖行数统计或遍历每一行执行数据库写入,这个由 split('\n') 带来的空白元素常常会导致格式校验失败或引发越界错误。
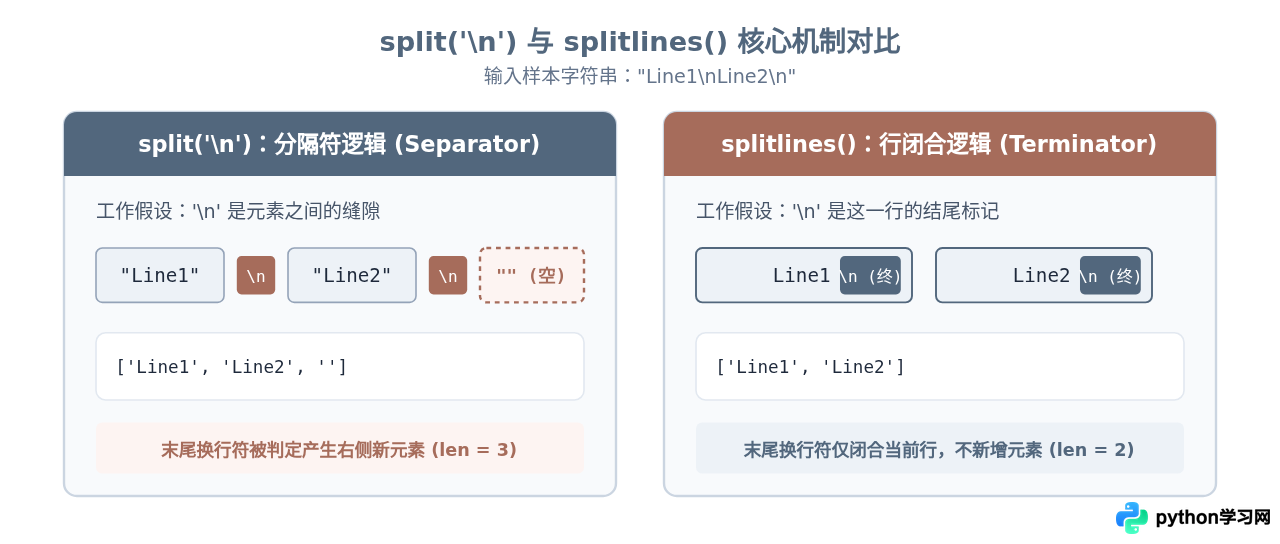
二、底层原理解析:分隔符模型 vs 行终止符模型
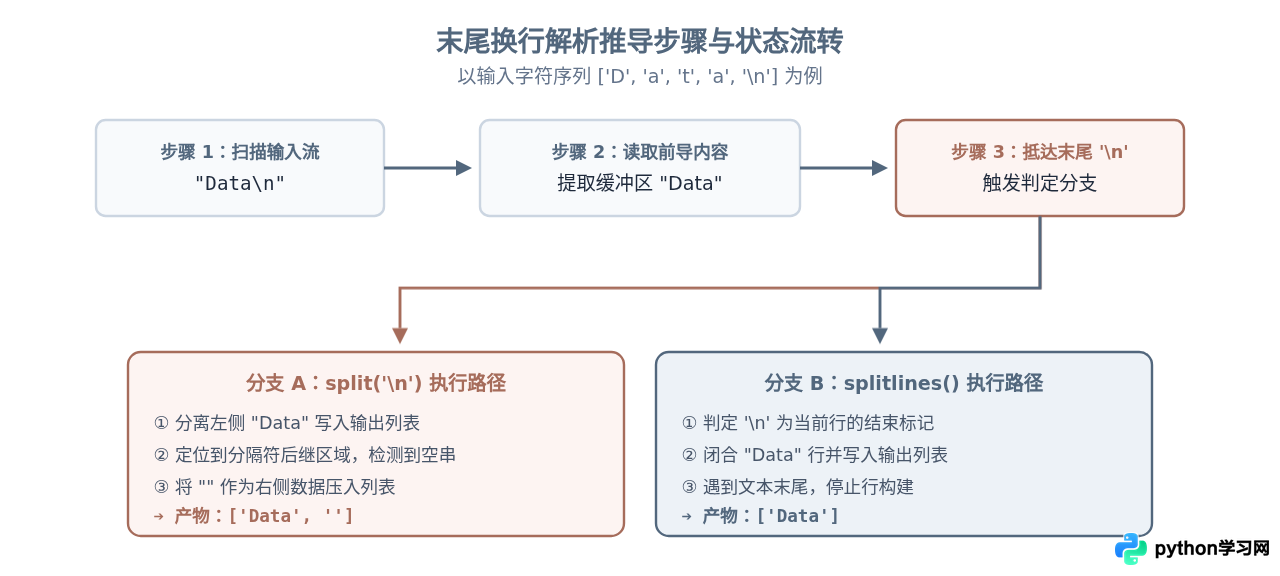
要理解这种行为差异,必须明确计算机科学中对文本结构的两种抽象视角:
- 分隔符模型(Delimiter Pattern):
split(sep)的通用定义是“寻找分隔标记并分离两端内容”。例如在"apple,banana,".split(',')中,逗号右侧存在空数据区,因此输出['apple', 'banana', '']。对于split('\n')来说,\n没有任何文本行上的特权,它只是一个普通的字符分隔符。 - 行终止符模型(Line Terminator Pattern):在 POSIX 和标准文本排版规范中,换行符是行结尾的标志,一个规范的文件最后应当有一个换行符用以标记末行的完结。
splitlines()遵循这一规范:遇到换行符时,它闭合前一段文本作为一行;当扫描到字符串末尾且恰好是一个换行符时,解析器认为最后一行已经完结,而不会无中生有地新建一个空白行。
另一个边界情况是空字符串 "" 的处理:
empty_str = ""

print(empty_str.split('\n'))
# 示例输出: [''] (含有一个空字符串的列表)

print(empty_str.splitlines())
# 示例输出: [] (真正的空列表)对于完全没有任何内容的空字符串,split('\n') 仍然会返回一个包含 "" 的列表,而 splitlines() 能够正确判断出没有任何文本行,直接返回空列表 []。
三、跨平台兼容性:通用换行符(Universal Newlines)
在跨平台项目开发中,另一个致命问题源自操作系统换行约定的历史差异:
- Linux / macOS:采用
\n(LF,Line Feed,0x0A)。 - Windows:采用
\r\n(CRLF,Carriage Return + Line Feed,0x0D 0x0A)。 - 经典 Mac OS(OS 9 及更早):采用
\r(CR,Carriage Return,0x0D)。
如果使用 split('\n') 去处理一份在 Windows 环境下生成的文本,代码会把 \r\n 拆解成包含 \r 的字符串:
win_text = "Alice\r\nBob\r\nCharlie"

# 错误实践:仅按 \n 切分
broken_lines = win_text.split('\n')
print("split('\\n') 包含回车符:", repr(broken_lines))
# 示例输出: ['Alice\r', 'Bob\r', 'Charlie']

# 正确实践:使用 splitlines()
clean_lines = win_text.splitlines()
print("splitlines() 原生干净处理:", repr(clean_lines))
# 示例输出: ['Alice', 'Bob', 'Charlie']在上述结果中,broken_lines 里的 'Alice\r' 尾部残留了 \r。当你在终端输出、做字符串判等(如 line == 'Alice')或转为 JSON 时,这个不可见的 \r 就会直接破坏逻辑。splitlines() 支持完整的通用换行符协议,能将 \r\n 作为一个不可分割的整体换行边界进行识别与剔除。
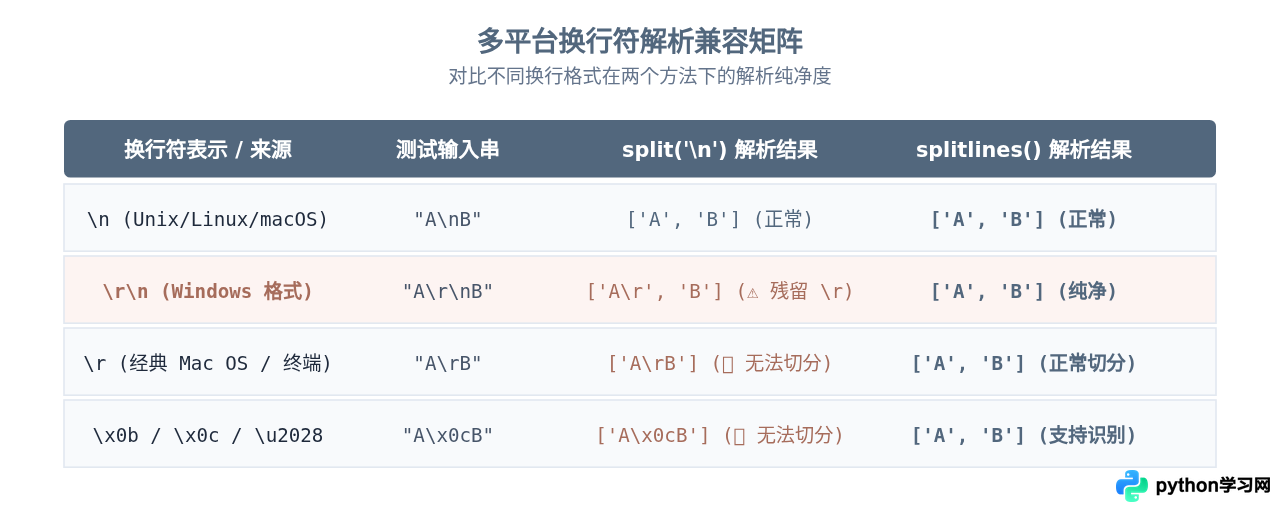
根据 Python 官方规范,splitlines() 能够识别的换行符边界不仅包含常规的 \n、\r、\r\n,还涵盖了行制表符 \v(\x0b)、换页符 \f(\x0c)、文件分隔符 \x1c、组分隔符 \x1d、记录分隔符 \x1e、下一行字符 \x85(NEL)以及 Unicode 行分隔符 \u2028 和段落分隔符 \u2029。
四、高级参数特性对比:keepends 与 maxsplit
除了基本切分逻辑外,两者提供的控制参数也服务于截然不同的业务需求:
1. splitlines(keepends=True):保留换行符本身
当你需要对文本逐行修改并重新写回文件、或者需要计算每一行原始精确字节偏移时,往往需要保留换行符。splitlines() 原生提供了 keepends 布尔参数:
multiline_text = "First\r\nSecond\nThird"

lines_with_breaks = multiline_text.splitlines(keepends=True)
print(repr(lines_with_breaks))
# 示例输出: ['First\r\n', 'Second\n', 'Third']
它会精确保留每一行所使用的原始换行序列(即使不同行混合了 \r\n 和 \n)。相比之下,split('\n') 在切分时会无条件抹除定界符,若想还原换行符只能后续手动拼凑,而且会丢失原本的跨平台混用特征。
2. split(sep, maxsplit=N):限制切分次数
split() 具备 maxsplit 参数,允许开发者只切分前 N 次:
log_record = "INFO\n2026-10-21\nDatabase connected successfully\nextra data..."

parts = log_record.split('\n', maxsplit=2)
print("切分前两项:", parts)
# 示例输出: ['INFO', '2026-10-21', 'Database connected successfully\nextra data...']需要注意:splitlines() 并不支持 maxsplit 参数。它只接受 keepends 这一个可选参数。如果你需要限制切分行数,通常需要结合生成器、itertools.islice 或先用 split('\n', maxsplit=N) 处理。
五、工程选型指南与决策总结
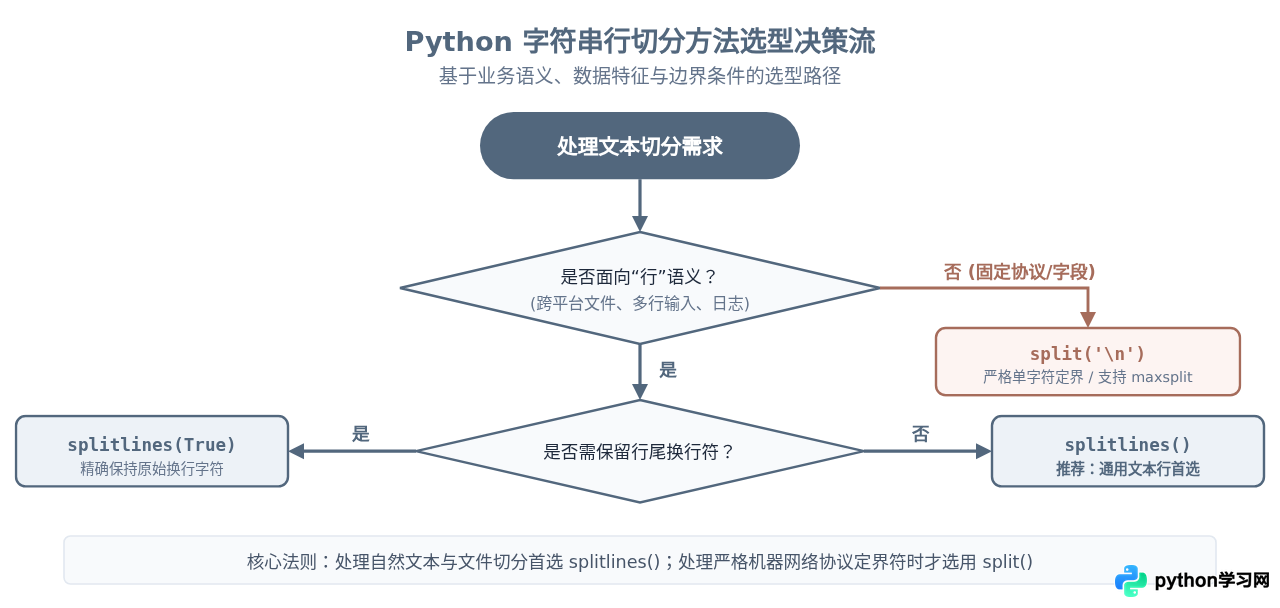
在实际编码中,应当如何在这两者之间作出明确选择?下方的决策流给出了清晰的判断路径:
| 对比维度 | str.splitlines() |
str.split('\n') |
|---|---|---|
| 抽象语义 | 行终止符模型(Line Terminator) | 定界分隔符模型(Delimiter) |
| 末尾换行符表现 | 仅闭合当前行,不追加空元素 | 视作分隔符,末尾追加空字符串 "" |
空字符串 "" |
返回 [](符合直觉) |
返回 [''](产生虚假项) |
| 跨平台换行兼容 | 全自动适配 \r\n、\r、\n 等全系换行符 |
仅严格匹配 \n,Windows 文本会残留 \r |
| 保留换行符 | 原生支持 keepends=True |
不支持,分隔符会被彻底丢弃 |
| 切分限制 (maxsplit) | 不支持(不可指定切分次数) | 支持 split('\n', maxsplit=N) |
掌握这两种切分方式的本质差异,能够彻底杜绝因尾部空行引发的数组越界、统计偏差,以及因 \r 残留导致的跨平台不可见格式错误。在涉及人类可读文本、脚本输出与多行文档处理时,优先使用 splitlines() 是编写健壮 Python 代码的标准实践。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









