

ComfyUI工作流搭建:怎么实现高效的批量AI提示词反推?

面对硬盘里堆积如山的参考图或训练素材,最让人头大的往往不是生成新图,而是给旧图打标。一张张打开图片,盯着画面里的发色、服饰、背景,再手动敲入“1girl, white hair, school uniform”,这种重复劳动不仅枯燥,还容易因为疲劳导致标签遗漏或格式不统一。
其实,只要把ComfyUI的工作流稍微调整一下,就能让AI自己“看”图说话。我们不需要复杂的编程知识,只需理清数据流向,就能搭建一个自动化的提示词反推流水线,把几个小时的工作压缩到几分钟。
核心组件:选对反推模型是关键
在ComfyUI中实现提示词反推,核心在于使用专门的图像识别节点。目前社区中最主流且效果均衡的选择是WD14 Tagger系列。它基于Waifu Diffusion的数据集训练,对动漫风格的人物特征识别极其精准,同时对写实风格也有不错的泛化能力。
你需要确保已安装ComfyUI-WD14-Tagger自定义节点。如果还没安装,可以通过ComfyUI Manager搜索并一键部署。这个节点的优势在于它能输出标准的Danbooru格式标签,并且支持置信度阈值调整,这意味着你可以过滤掉那些AI“不太确定”的干扰项。
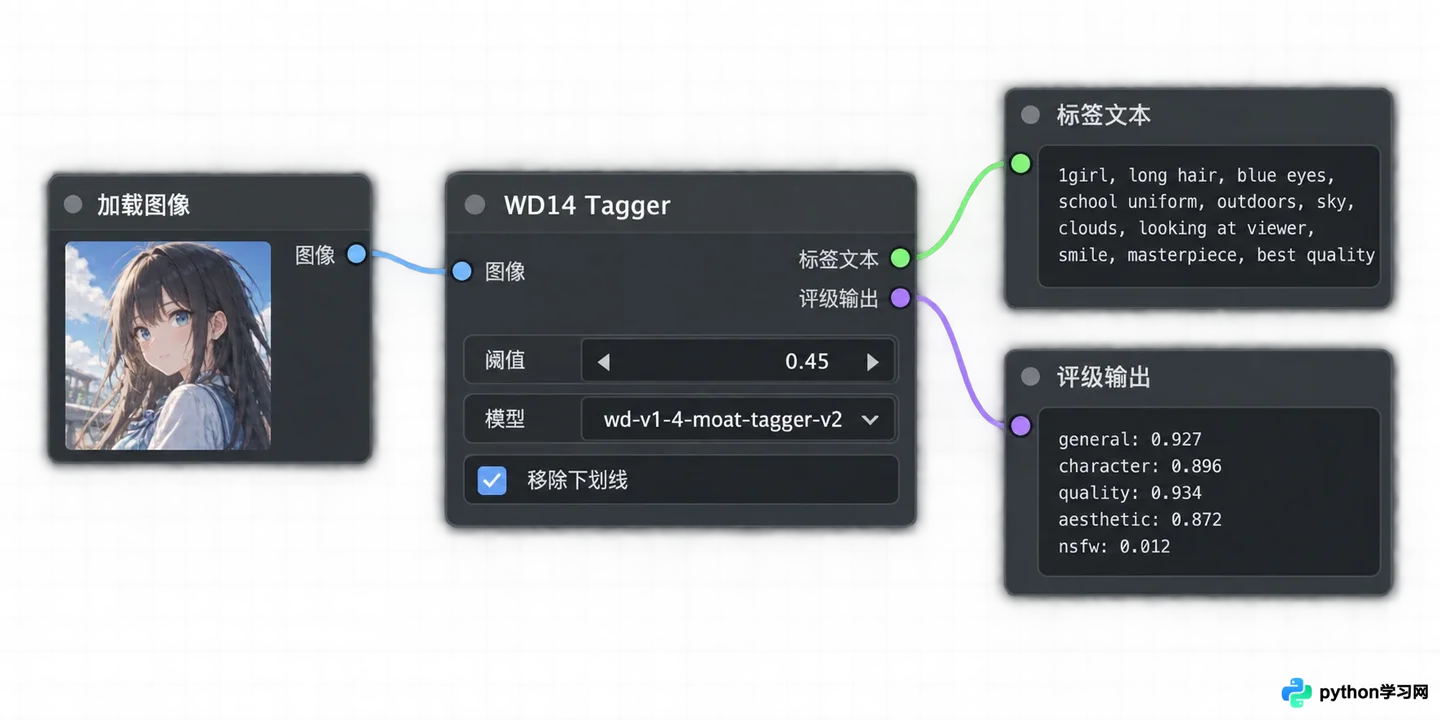
WD14 Tagger节点参数设置,重点展示阈值调整和模型选择
除了WD14,如果你主要处理写实照片,也可以考虑CLIP Interrogator节点,但它速度较慢且输出的是自然语言句子而非标签列表,对于需要结构化数据的批量处理来说,WD14通常是更高效的首选。
搭建批量读取与处理链路
单个图片的反推很简单,但批量的关键在于“输入端”和“循环逻辑”。不要使用普通的Load Image节点,那是为单张调试设计的。
首先,放置一个Load Images (Path)节点(通常来自ComfyUI Essentials或类似工具包)。在这个节点中,指定你存放待处理图片的文件夹路径。注意,确保文件夹内只包含需要处理的图片,避免混入txt或json文件导致报错。
接下来,将图片输出连接到WD14 Tagger节点的image输入端。这里有一个细节需要注意:WD14 Tagger通常一次只处理一张图,因此我们需要依靠ComfyUI内部的批次处理机制,或者使用简单的迭代逻辑。在大多数现代版本的ComfyUI中,直接将Load Images的输出连入Tagger,系统会自动按顺序逐张处理,但这取决于具体的节点实现。
为了更稳妥地控制流程,建议使用Image Batch To List和List Iterate这样的组合(如果安装了相应的高级控制节点),或者直接使用支持批处理的WD14变种节点。对于初学者,最简单的方案是使用支持文件夹读取的WD14节点,它内部已经封装了循环逻辑。
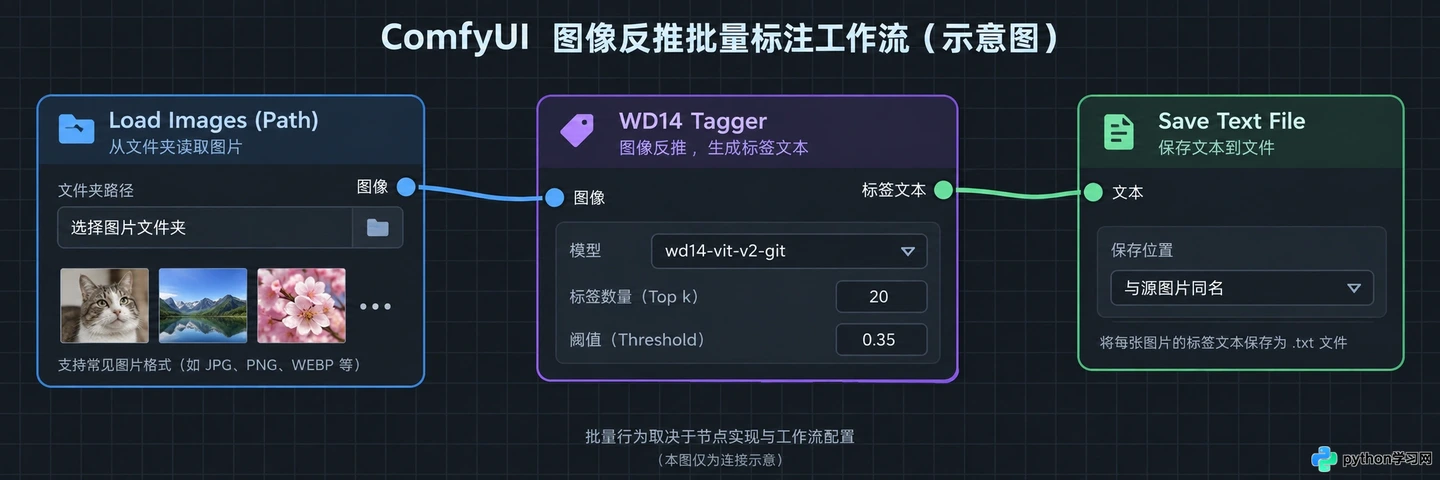
从文件夹加载图片并连接到反推节点的连线逻辑
在连接好线路后,观察WD14节点的设置面板。重点关注threshold(阈值)参数,默认通常在0.35到0.5之间。调高这个值,得到的标签会更少但更精准;调低则会更丰富但可能包含噪声。对于批量反推,建议先设为0.45,后续再根据结果微调。
优化输出:从标签到可用文本
反推出来的标签如果不加整理,直接拿来用可能会显得杂乱。WD14 Tagger通常会输出两个主要信息:一是评级(rating),二是标签字符串(tags)。
我们需要将这些数据保存下来。连接一个Save Text File或String to File节点。将WD14输出的tags连接到文本保存节点的输入。关键点在于文件名的命名规则:务必选择“与源图片同名”的选项。这样,每张jpg/png都会对应生成一个同名的txt文件,方便后续在Stable Diffusion WebUI或其他工具中直接调用。
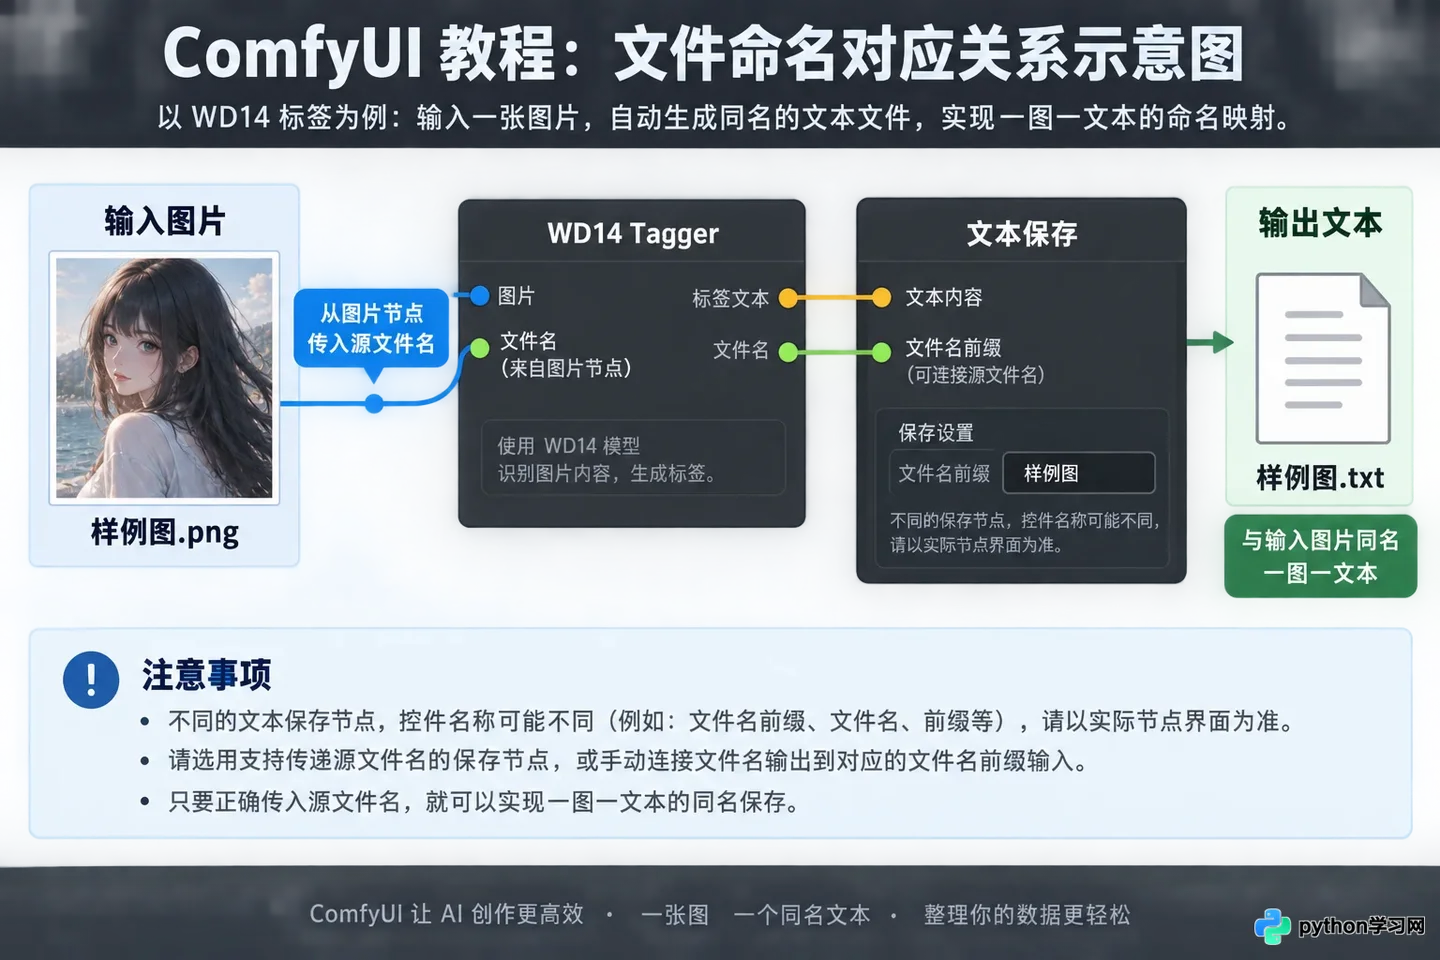
设置保存文件名与源图片一致的选项界面
此外,你可能希望去除一些通用且无意义的标签,比如“solo”、“highres”等。可以在WD14节点和保存节点之间插入一个Replace Text或Filter Tags节点。预设一个黑名单,将这些高频无效词替换为空,这样生成的提示词库会更加干净实用。
运行监控与结果校验
点击队列提示后,不要立刻离开屏幕。观察控制台日志或ComfyUI界面上的进度条。批量处理的速度取决于你的显卡性能和图片分辨率。如果显存爆满,可以尝试在加载图片节点中增加一个Resize Image步骤,将长边限制在1024像素以内,这能显著提升反推速度且不影响标签准确性。
处理完成后,随机抽取几张图片,对比原图和生成的txt文件。检查是否有明显的误识,比如把“猫”识别成“狗”,或者漏掉了显著的背景元素。如果误差较大,回到WD14节点调整阈值,或者尝试更换模型版本(如wd-v1-4-moat-tagger-v2)。
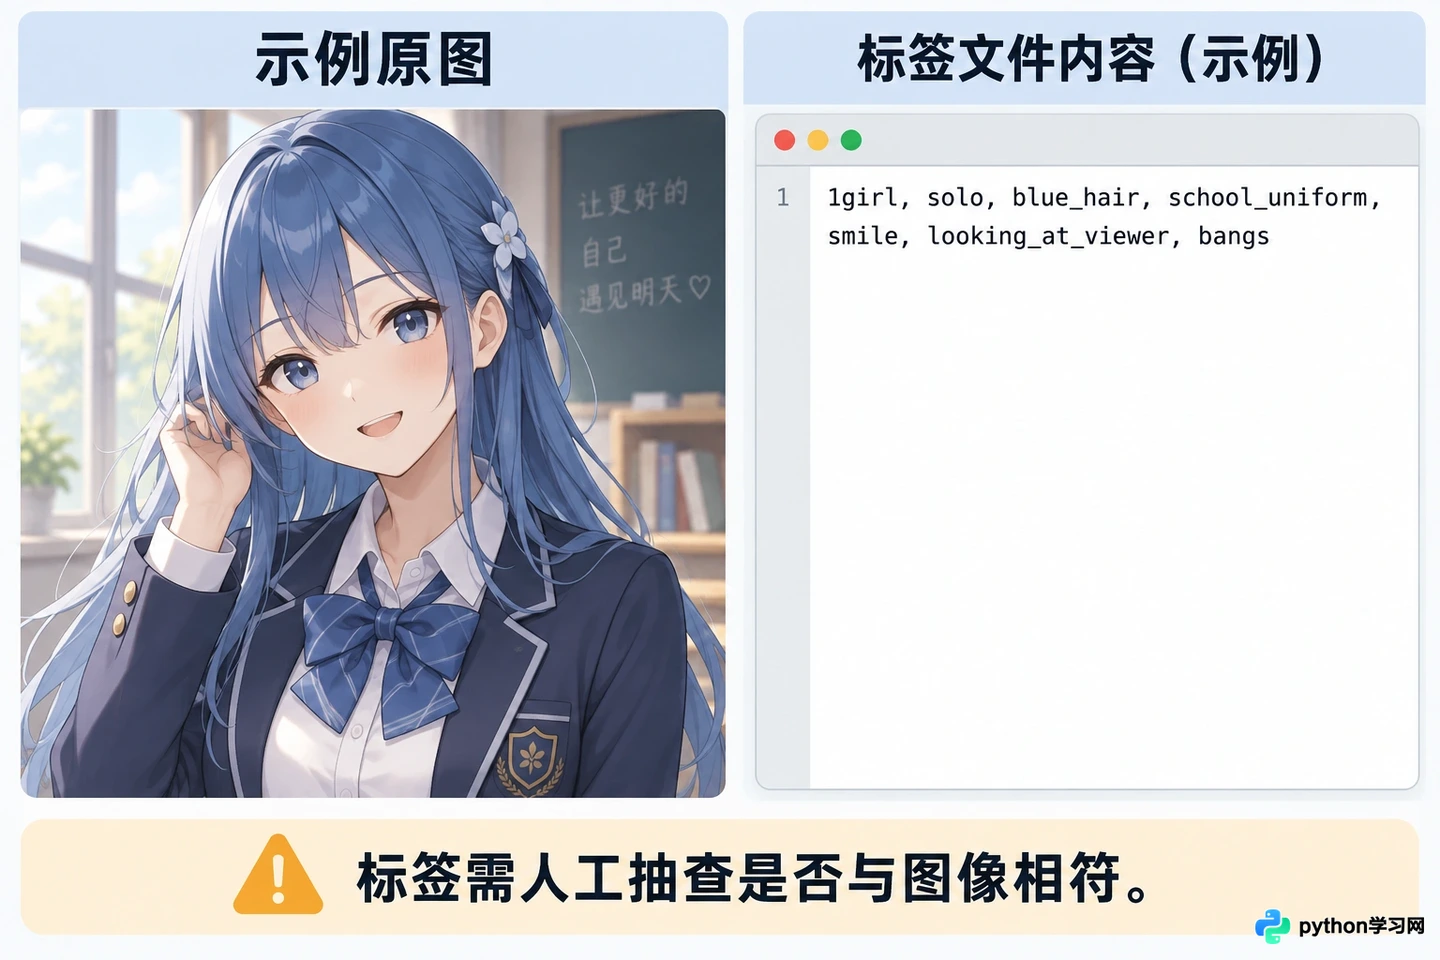
左侧为动漫角色原图,右侧为对应的txt标签文件内容
这套工作流的价值不仅在于节省时间,更在于标准化。当你拥有了一整套风格统一的标签数据,无论是用于训练LoRA,还是作为灵感库检索,效率都会有质的飞跃。与其在单张图片上纠结措辞,不如让机器先跑一遍初稿,你再在此基础上进行精修,这才是AI辅助创作的正确打开方式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









