

使用@property优化Python类接口设计的最佳实践

在 Python 面向对象设计中,优化类接口的核心目标是让调用方获得直观、稳定且符合直觉的访问方式,同时允许类内部在未来自由演进业务规则。通过内置的 @property 装饰器,开发者可以在保持普通属性访问语法的同时,按需将数据校验、惰性计算和只读保护无缝织入接口中。本文将从设计哲学、重构步骤、实战模式、底层机制及决策模型展开,提供一份清晰、可直接落地的接口设计实践指南。
一、Python 属性接口的设计哲学:统一访问原则
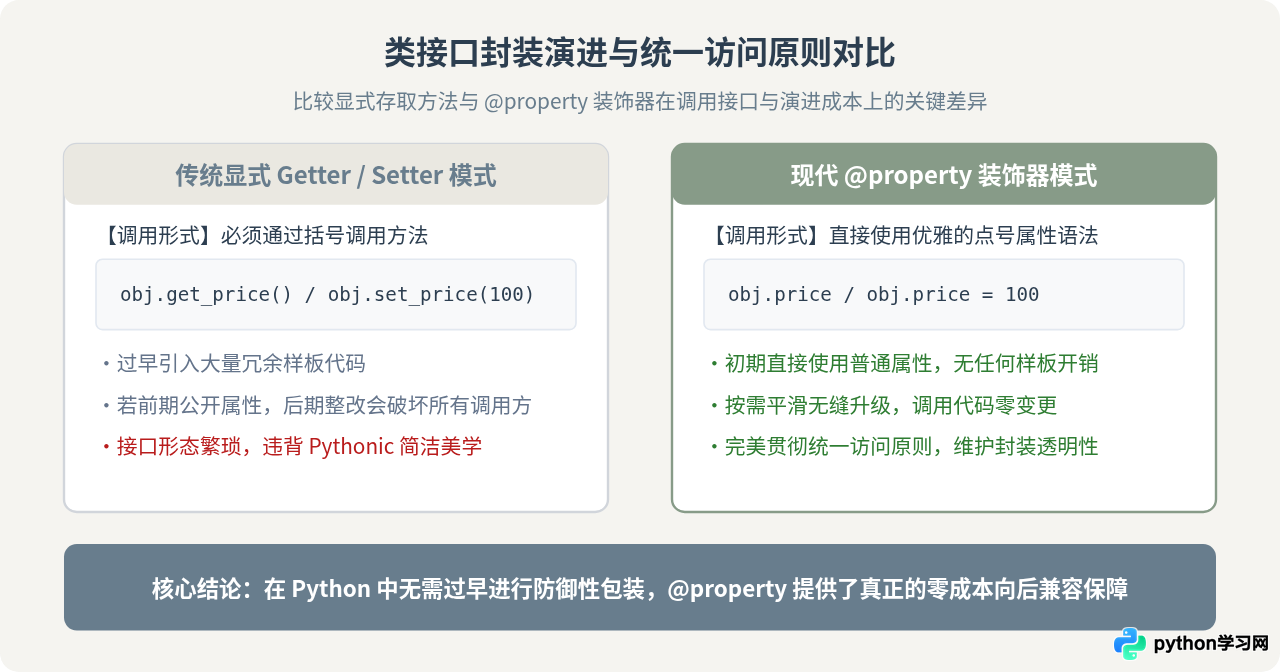
许多习惯了 Java、C++ 等静态语言的开发者,在编写 Python 类时往往会不自觉地定义大量的 get_x() 和 set_x() 样板方法。在这些静态语言中,过早编写访问器是为了防止未来在属性赋值时追加校验逻辑而迫使所有调用方修改调用代码。
然而在 Python 中,语言深度贯彻了统一访问原则(Uniform Access Principle):模块向外部提供的服务,无论是由直接存储的数据提供,还是由背后的计算过程提供,都应该使用完全一致的语法。Python 允许你在一开始将属性直接暴露为公开字段;一旦未来需要增加边界校验或计算联动,直接使用 @property 将其包装为受控属性,外界的调用语法无需发生任何改变。
二、两种封装方式的关键差异与影响
为了直观评估接口设计的差异,我们可以把“显式方法(get/set)”与“@property 属性”置于同一个演进场景下进行对比:假设业务初期有一个代表商品信息的类,其中包含单价 price。
| 考量维度 | 显式 Getter / Setter 方案 | @property 属性方案 | 差异影响与决策依据 |
|---|---|---|---|
| 调用语法 | product.set_price(100) |
product.price = 100 |
属性赋值符合人类对“状态数据”的直觉预期;方法调用更适合表示“动作”。 |
| 向后兼容性 | 若早期为直接属性,升级为方法会直接打崩旧有调用方。 | 从普通属性升级为 property,调用方完全无感知,字节级兼容。 | @property 赋予类设计者在不发布破坏性变更的前提下修复数据缺陷的能力。 |
| 运算符支持 | 复合赋值困难:p.set_price(p.get_price() + 10) |
直接支持就地修改:p.price += 10 |
@property 完全支持 +=、-= 等 Python 表达式语法糖。 |
| 样板代码量 | 成对出现,即使没有任何校验逻辑也必须机械书写。 | 按需引入。无校验时写普通字段,有校验时仅为该字段修饰。 | 极大精简类体行数,避免大量冗余存取器掩盖真正的核心领域逻辑。 |
三、规范重构四步法:将公开字段升级为受控属性
当现有类的某个公开属性随着业务发展需要增加合法性校验(例如价格必须大于 0)时,应遵循规范的四步重构流程完成升级,避免破坏下游客户端。
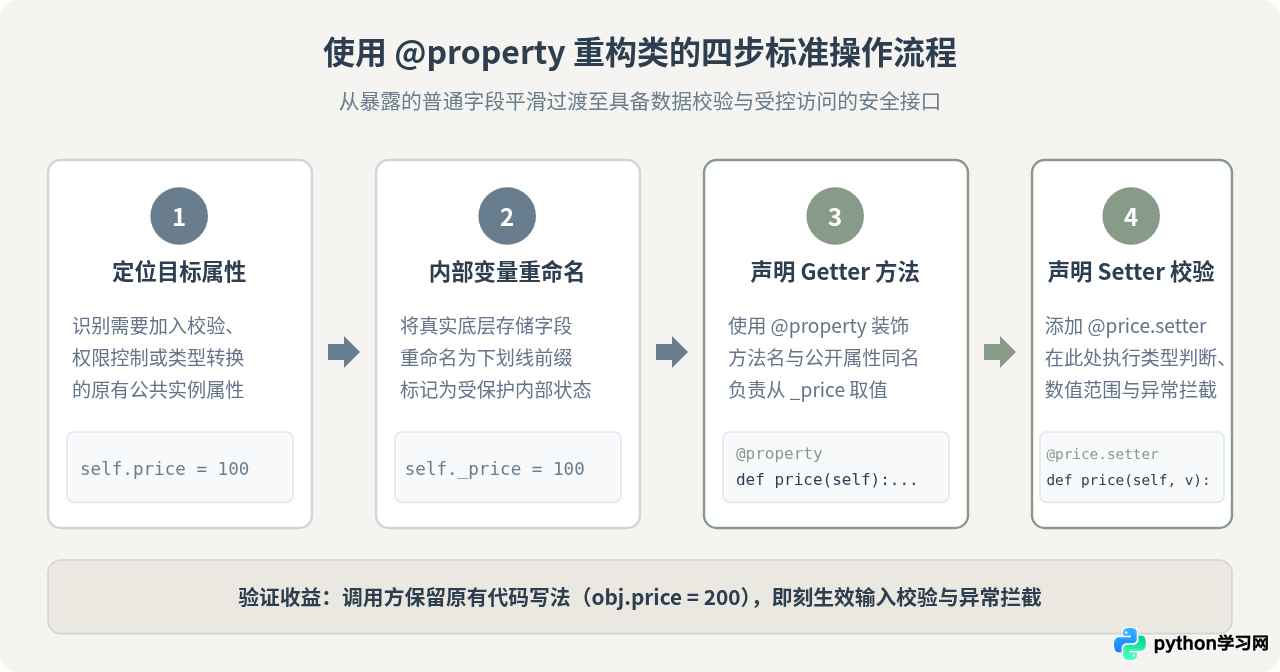
以下是完成上述四步重构的完整代码实现。请注意,在类的 __init__ 构造函数中,建议直接对 self.price 赋值,这样实例化时的初始值同样能够经过 setter 的严格校验:
class Product:
    def __init__(self, name: str, price: float):
        self.name = name
        # 步骤 2 与步骤 4 联动:通过公开属性赋值,确保初始化也触发合法性校验
        self.price = price

    # 步骤 3:定义与公开属性同名的 getter
    @property
    def price(self) -> float:
        """获取商品单价"""
        return self._price

    # 步骤 4:定义 setter 实现边界约束
    @price.setter
    def price(self, value: float) -> None:
        """设置商品单价,包含类型与范围校验"""
        if not isinstance(value, (int, float)):
            raise TypeError(f"价格必须为数值类型,当前传入为 {type(value).__name__}")
        if value <= 0:
            raise ValueError(f"价格必须大于零,当前传入值为 {value}")
        # 真实状态存入底层的受保护属性
        self._price = float(value)

# 调用方代码完全保持自然风格:
item = Product("键盘", 299.0)
print(item.price)        # 输出:299.0
item.price = 399.0       # 正常更新价格
item.price += 10.0       # 支持原位自增运算符

# 非法赋值会被立刻拦截:
try:
    item.price = -50
except ValueError as e:
    print(f"赋值拦截成功: {e}")  # 触发异常,数据未被破坏
四、实战设计模式与进阶用法
1. 打造只读属性(Read-Only Property)
如果类中的某个属性在初始化后不应该被外部任意覆写(例如对象的唯一标识符、数据库连接配置),只需声明 @property 的 getter 方法,而不提供对应的 setter 即可。任何外部对该属性的直接赋值都会在运行时抛出 AttributeError。
class UserAccount:
    def __init__(self, user_id: str, username: str):
        self._user_id = user_id
        self.username = username

    @property
    def user_id(self) -> str:
        """外部仅可读取,不可修改"""
        return self._user_id

user = UserAccount("UID_10086", "alice")
print(user.user_id)  # 输出:UID_10086
# user.user_id = "UID_99999"  # 抛出 AttributeError: can't set attribute
2. 动态衍生计算属性(Derived Property)
当类的某些状态可以通过其他基础字段直接推导得出时,不要单独维护一份冗余的字段(因为字段同步往往极易产生不一致 Bug)。利用 @property 将其设计为计算属性:
class Rectangle:
    def __init__(self, width: float, height: float):
        self.width = width
        self.height = height

    @property
    def area(self) -> float:
        """面积由宽和高即时计算得出,无需单独存储,永远保持一致"""
        return self.width * self.height

rect = Rectangle(10, 20)
print(rect.area)  # 200
rect.width = 15
print(rect.area)  # 300,即时保持同步
3. 高耗时计算的缓存利器:@functools.cached_property
如果计算属性的逻辑涉及复杂算法、本地文件解析或大矩阵运算,每次使用 @property 访问都会重复执行高昂计算。在 Python 3.8 及以上版本中,内置的 functools.cached_property 是最佳解决方案。它只在首次访问时执行计算,并将结果直接缓存在实例字典 __dict__ 中,后续访问即刻返回,且允许通过 del obj.attr 清除缓存:
import time
from functools import cached_property

class ReportDataset:
    def __init__(self, filepath: str):
        self.filepath = filepath

    @cached_property
    def parsed_records(self) -> list:
        """仅在首次被读取时执行耗时解析,后续直接从缓存返回"""
        print("正在从磁盘解析大容量数据集...")
        time.sleep(1)  # 模拟耗时 I/O 或复杂解析
        return ["record_1", "record_2", "record_3"]

report = ReportDataset("data.csv")
# 首次访问触发实际解析:
print(report.parsed_records)
# 再次访问无需耗时,直接读取实例字典内部缓存:
print(report.parsed_records)
# 清理缓存:如果底层文件更新,删除属性后下次访问自动重新计算
del report.parsed_records
4. 拦截删除操作:@attr.deleter
除了获取和赋值,Python 还允许通过 @property_name.deleter 自定义外部执行 del obj.prop 时的拦截逻辑,常用于关联资源释放、重置默认值或阻止关键属性被物理删除:
class ManagedCache:
    def __init__(self, key: str, value: str):
        self.key = key
        self._value = value

    @property
    def value(self) -> str:
        return self._value

    @value.deleter
    def value(self) -> None:
        print(f"正在清理键 [{self.key}] 的底层存储资源...")
        self._value = None

cache_item = ManagedCache("session_token", "abc123xyz")
del cache_item.value  # 触发 deleter 逻辑,优雅完成资源回收与状态置空
五、底层机制与必须规避的陷阱
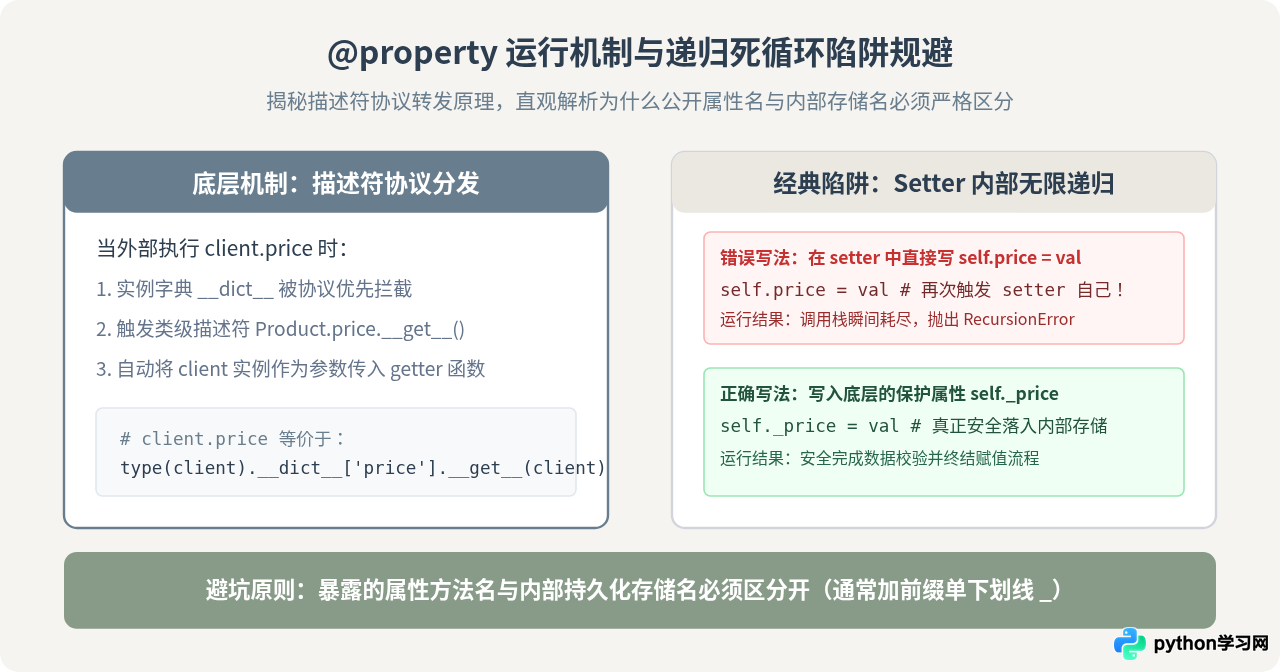
1. 陷阱一:命名混淆导致的递归死循环(RecursionError)
这是初学者使用 @property 时最容易踩中的错误。@property 本质上是 Python 的描述符(Descriptor)对象。当类定义中存在 price 的 property 时,所有对 self.price = value 的赋值都会被 Python 解释器重定向至 setter 方法。如果在 setter 方法内部仍然写 self.price = value,就会无限次重复调用自身,迅速导致调用栈溢出并报错:RecursionError: maximum recursion depth exceeded。
避坑指南:在 setter 与 getter 内部操作真实数据时,必须使用带有前导下划线的底层变量(如 self._price),该变量才是存储在对象 __dict__ 中的物理实体。
2. 陷阱二:在 Property 中塞入隐蔽副作用或重度 I/O
属性访问在程序员的普遍心智模型中被假定为低成本、即时且幂等的操作。如果你在一个 @property 中执行了发送 HTTP 请求、查询大型数据库或向文件系统写日志的操作:
- 调用方可能在循环中毫无戒心地频繁调用
obj.status,无意中触发成百上千次网络阻塞。 - 调试器(如 VS Code、PyCharm)在悬停检查变量状态时会自动触发 property 的求值,从而在开发者不知情的情况下执行了网络请求或修改了系统状态。
最佳实践:凡是伴随网络/磁盘 I/O、需要较长耗时或具备显著破坏性副作用的操作,必须显式定义为动词函数(例如 fetch_remote_status()、save_to_disk()),而不是伪装为属性。
3. 陷阱三:继承子类中重写 Property 时的上下文丢失
当子类需要重写父类的某个 property 时,如果直接在子类中使用 @property def attr(self): ...,子类会创建一个全新的 property 实例,从而丢失父类原本定义好的 setter 和 deleter。在子类中重写时,若想保留父类的 setter,应通过父类引用进行继承扩展,或者显式同时重写 getter 与 setter。
六、接口设计决策指南与最佳实践清单
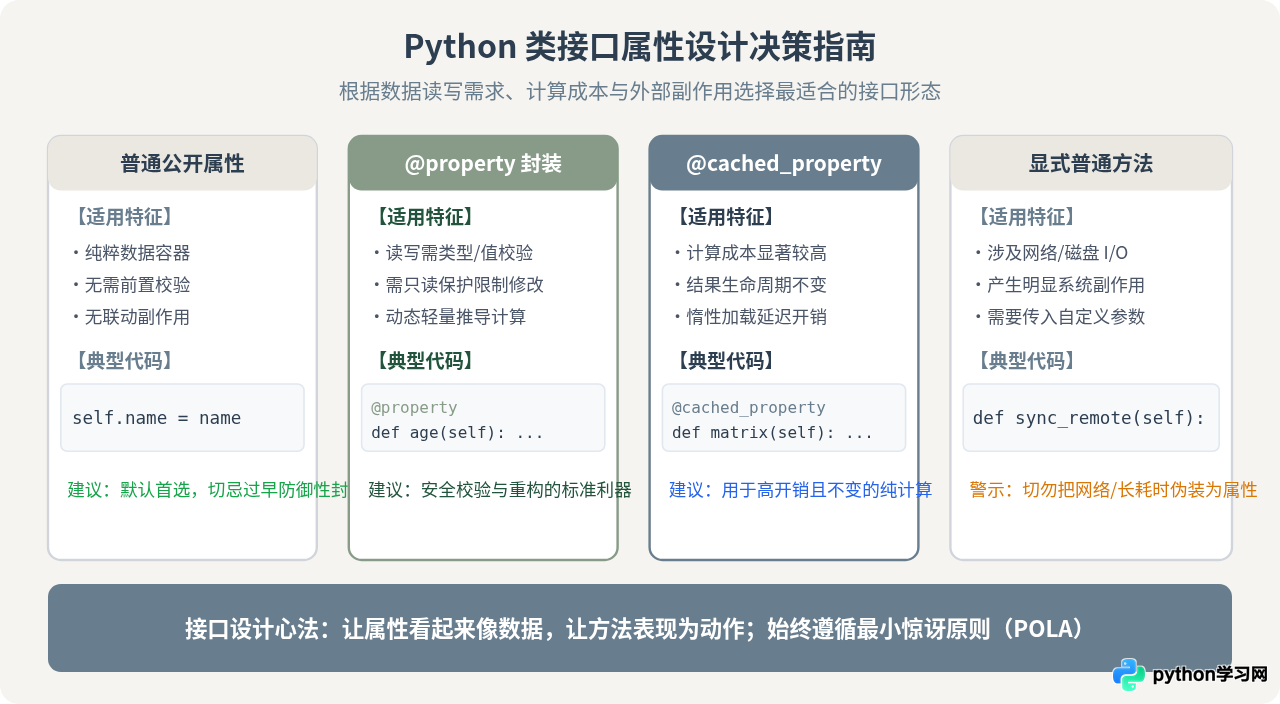
实践检验清单(Checklist)
- 保持极简起步:初版代码仅暴露普通属性,不要在没有校验或转换需求时凭空添加
@property。 - 命名严格隔离:底层承载数据的私有变量务必添加前缀(如
_attr),严防 setter 内部递归死循环。 - 异常类型准确:在 setter 中拦截非法输入时,严格按照 Python 标准抛出
TypeError或ValueError,并附带清晰的错误描述。 - 杜绝耗时副作用:属性求值必须极其迅速,凡是涉及外部系统交互或长耗时计算的操作,坚决采用普通显式方法。
- 善用缓存机制:对于纯计算且结果在对象生命期内不可变的大型只读属性,优先采用
@functools.cached_property。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









