

Python学习遇到瓶颈怎么办?突破中级水平的建议

一、认识瓶颈的本质:脚本思维与工程思维的断层
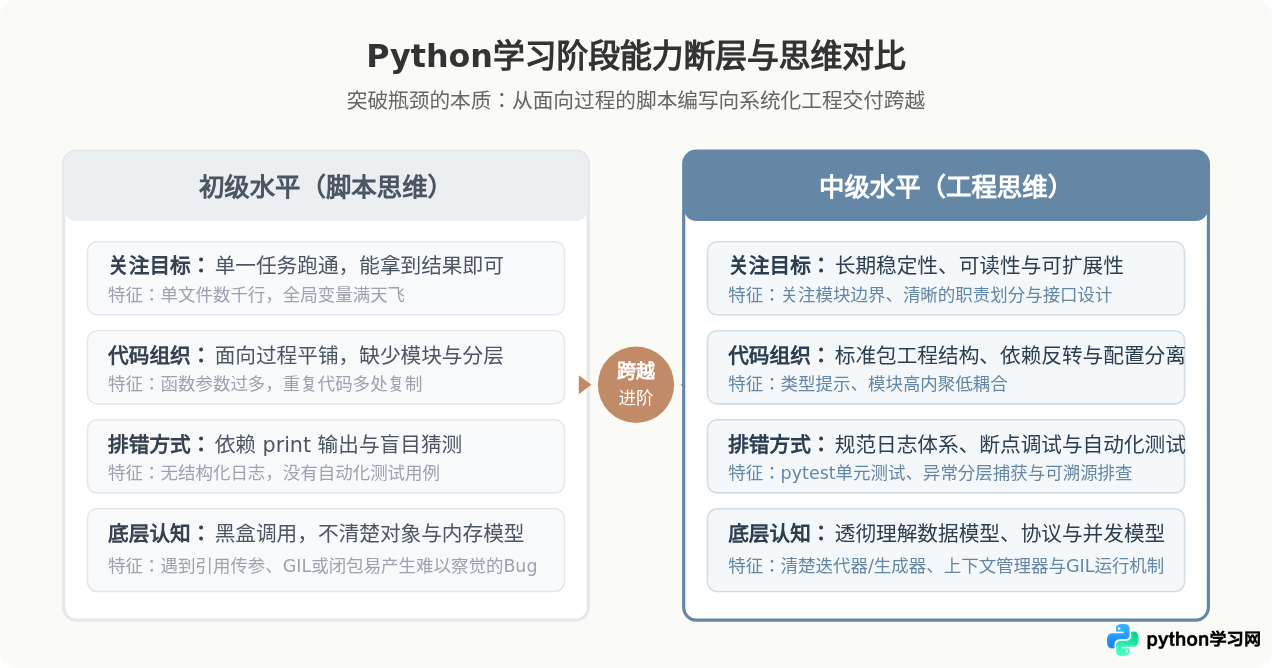
初学阶段的反馈周期通常很短:学习一条for循环语句、调用一个外部库的API,就能立即在终端看到输出结果。这种以“实现单一功能”为导向的学习方式,在代码量扩大到几千行、模块数量增加后就会迅速失效。
中级瓶颈并非意味着记忆的内置函数不够多,而是思维模式存在断层。初学者往往依靠线性堆砌逻辑解决问题,而中级水平要求对代码的组织形态、抽象复用、异常边界及内存运行机制有明确的预判。下表和图示展示了这一关键断层:
二、突破建议一:深入Python数据模型与底层机制
很多处于瓶颈期的开发者把Python仅仅当成“简化的C语言”或“带语法的Shell脚本”来写。要突破到中级水平,首先必须掌握Python官方文档中称之为“数据模型(Data Model)”的核心协议。
Python的核心哲学是协议导向(Protocol-oriented)。Python通过双下划线方法(特殊方法/魔术方法)统一了对象行为。当你理解了数据模型,你就能编写出地道的Pythonic代码,而不是生硬地把其它语言的设计强行塞入Python。
1. 理解序列、迭代器与生成器协议
在处理数据列表时,初学者常常一次性把全部数据加载进内存,导致处理大文件或大集合时内存爆炸。中级水平必须熟练使用惰性求值(Lazy Evaluation)。
# 脚本级写法:一次性加载全部数据,极度占用内存
def read_all_lines(filepath):
    results = []
    with open(filepath, 'r', encoding='utf-8') as f:
        for line in f:
            if line.strip():
                results.append(line.strip())
    return results

# 中级工程化写法:利用生成器实现流式管线,内存占用恒定在常数级
from typing import Iterator

def stream_cleaned_lines(filepath: str) -> Iterator[str]:
    with open(filepath, 'r', encoding='utf-8') as f:
        for line in f:
            cleaned = line.strip()
            if cleaned:
                yield cleaned
2. 掌握上下文管理器与资源安全保障
掌握with语句不仅仅局限于打开文件。在中级项目中,无论是数据库事务、多线程互斥锁、网络连接还是性能计时器,都应当使用上下文管理器来保证资源的确定性释放。
import time
from contextlib import contextmanager

@contextmanager
def timer_scope(task_name: str):
    start = time.perf_counter()
    try:
        yield
    finally:
        elapsed = time.perf_counter() - start
        print(f"[{task_name}] 执行耗时: {elapsed:.4f} 秒")

# 使用示例
with timer_scope("批量特征计算"):
    total = sum(i * i for i in range(1_000_000))
在函数定义中切勿使用可变对象(如 def add_item(val, container=[]))作为默认参数。默认参数在模块加载时被求值一次,并在后续调用中被共享。始终使用 container=None 并在函数内部初始化,这是中级开发者的基本规范。
三、突破建议二:遵循渐进式工程化落地步骤
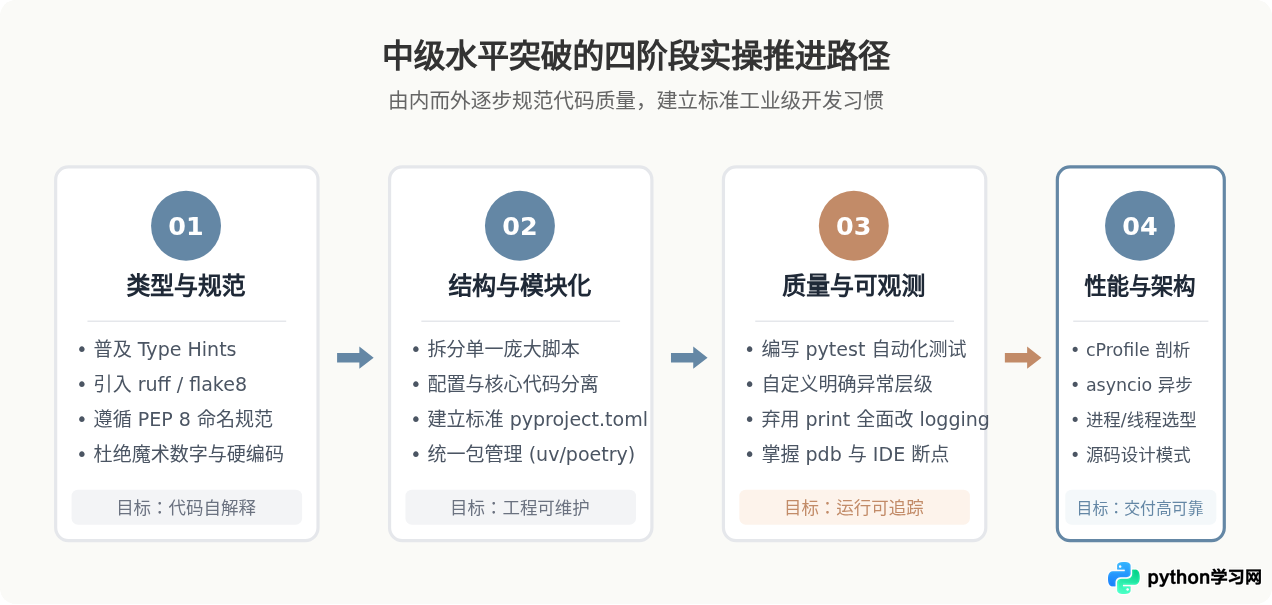
从“写散装脚本”到“交付可靠项目”,需要经历明确的演进步骤。建议遵循四个具体阶段,逐步重塑自己的编码习惯。
1. 强制使用类型提示(Type Hints)与静态检查
Python是动态类型语言,但在中大型项目中,缺少类型约束是代码腐烂的主要原因。从Python 3.5引入并在3.9+全面完善的类型提示不仅能让IDE提供极其精准的补全,还能借助静态分析工具(如 mypy 或 pyright)在运行之前捕获诸如参数传错、None未检查等隐藏问题。
2. 建立标准的包工程结构与依赖隔离
摒弃把所有逻辑堆在一个main.py或test.py中的习惯。一个标准的Python工程应具备清晰的目录层次,例如:
my_project/
├── pyproject.toml        # 项目元数据、依赖管理与工具配置
├── src/
│   └── my_project/
│       ├── __init__.py
│       ├── core/         # 核心业务逻辑与领域模型
│       ├── service/      # 对外接口或流程编排
│       ├── utils/        # 通用工具函数
│       └── exceptions.py # 自定义异常体系
├── tests/                # 自动化单元测试与集成测试
│   ├── conftest.py
│   └── test_core.py
└── README.md
四、突破建议三:掌握中级技术栈与架构全景
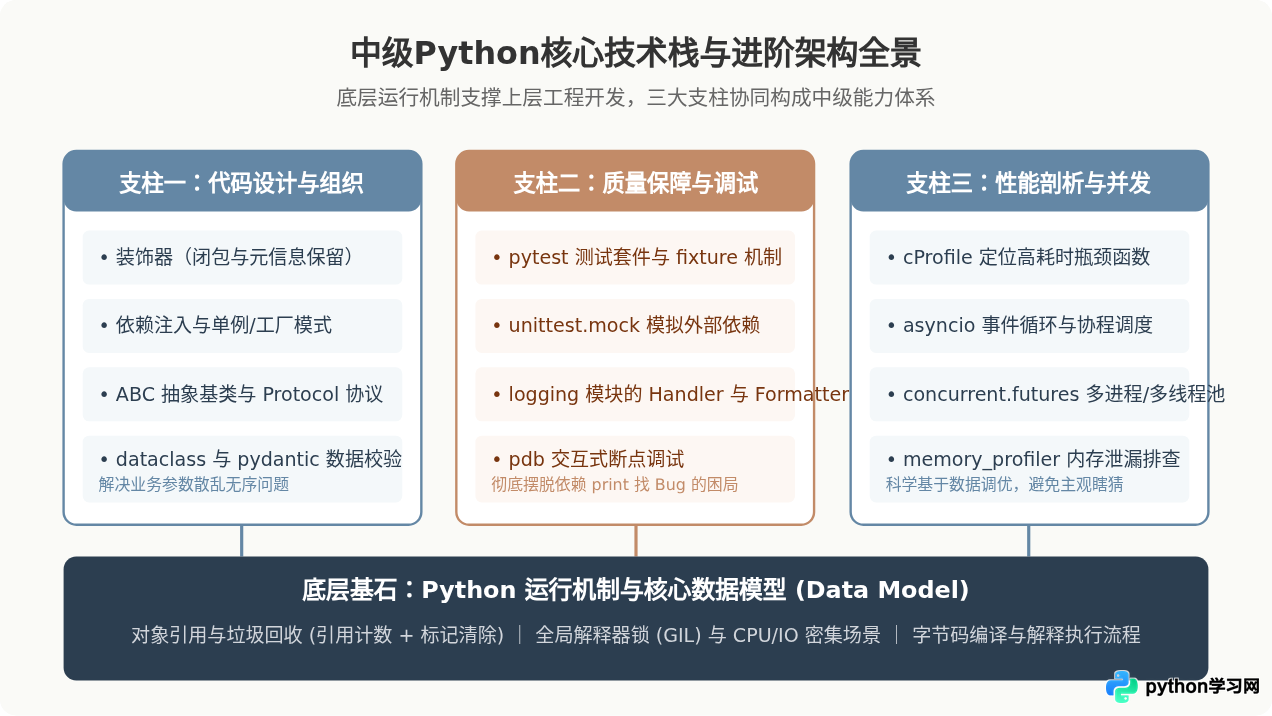
很多中级学习者的困惑在于:“基础学完了,接下来到底该学哪些技术才能拼出完整版图?”如果零散地学各种库,容易东拼西凑、只见树木不见森林。必须从底层机制、代码组织、质量保障与并发性能四个支柱建立立体的技术栈认知。
1. 掌握真实场景下的性能剖析(Profiling)
初学者遇到性能问题往往凭直觉乱改代码,甚至将原本简洁的逻辑改成复杂的底层操作。中级开发者的准则只有一条:没有量化数据,就没有优化。
Python标准库内置了强大的cProfile模块。在终端中只需一条命令即可完成剖析:
# 示例命令:使用 cProfile 按照累计耗时排序列出性能瓶颈
python -m cProfile -s cumulative main.py
根据输出的ncalls(调用次数)、tottime(自身耗时)与cumtime(累计耗时),你可以精确找出占用CPU时间最多的函数究竟是正则匹配、JSON序列化还是不恰当的嵌套循环。
2. 明确并发模型的选择依据:IO密集与CPU密集
受限于全局解释器锁(GIL),在默认的CPython实现中,原生多线程无法实现真正的多核CPU并行。因此在并发选型上有明确的边界:
- 网络IO密集型(如高频API请求、爬虫、Web服务):优先使用
asyncio事件循环或ThreadPoolExecutor。 - CPU密集型(如图像处理、大数据矩阵计算、加解密):必须使用
ProcessPoolExecutor(多进程)绕过GIL,或调用底层由C/C++/Rust编写的高性能库(如NumPy、Polars)。
五、突破建议四:日常刻意练习的有效方法
脱离了实际项目,单纯看书或刷语法题无法打破中级瓶颈。以下三种刻意练习方式能够直接带来工程能力的质变:
1. 深入阅读优秀的成熟开源库源码
选择代码风格优雅、规模适中的Python开源项目进行“庖丁解牛”。推荐从以下项目开始:
requests:学习如何将底层复杂、混乱的urllib3封装成极其符合人类直觉的优雅API,学习其异常层级与会话管理设计。click或typer:学习高级装饰器的运用、命令行上下文的参数绑定机制。starlette:阅读轻量ASGI框架的核心调度代码,深入掌握异步请求流的处理方式。
2. 对自己过去的“散装脚本”进行工程化重构
拿出半年前写过的功能正常的脚本,设定重构目标:
- 消除所有全局变量,将配置项抽象到环境变量或
.env文件中; - 为所有公开函数和方法补齐Type Hints,并通过
mypy --strict无警告验证; - 使用
pytest编写覆盖率达到80%以上的单元测试,重点测试空输入、网络超时、畸形数据等边界异常; - 将所有
print替换为带有格式化时间戳和级别的logging记录。
六、中级水平突破自检清单与复盘总结
如何衡量自己是否已经成功迈过了中级门槛?可以对照以下能力自检矩阵进行评估。当你能够不仅“回答出来”,而且在日常开发中“自然遵循”这些标准时,就说明你已经牢固建立了中级工程能力。
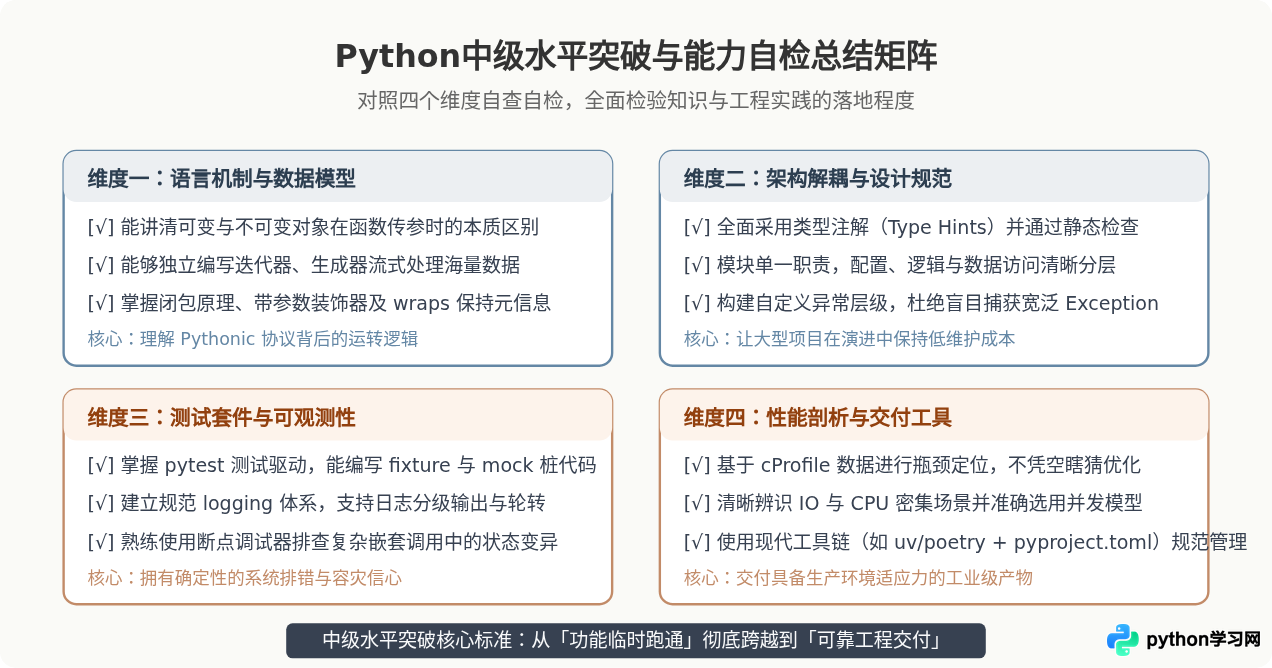
Python中级瓶颈是每个专业开发者必经的蜕变期。只要将精力从“广度刷库”转向“深度内功与工程化实践”,通过对底层数据模型的透彻掌握、严谨的代码结构规范、完善的自动化测试与科学的性能剖析,就能扎实完成从中级到高级开发者的稳步跃升。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









