

Python学习路线图:30个关键知识点拆解与练习

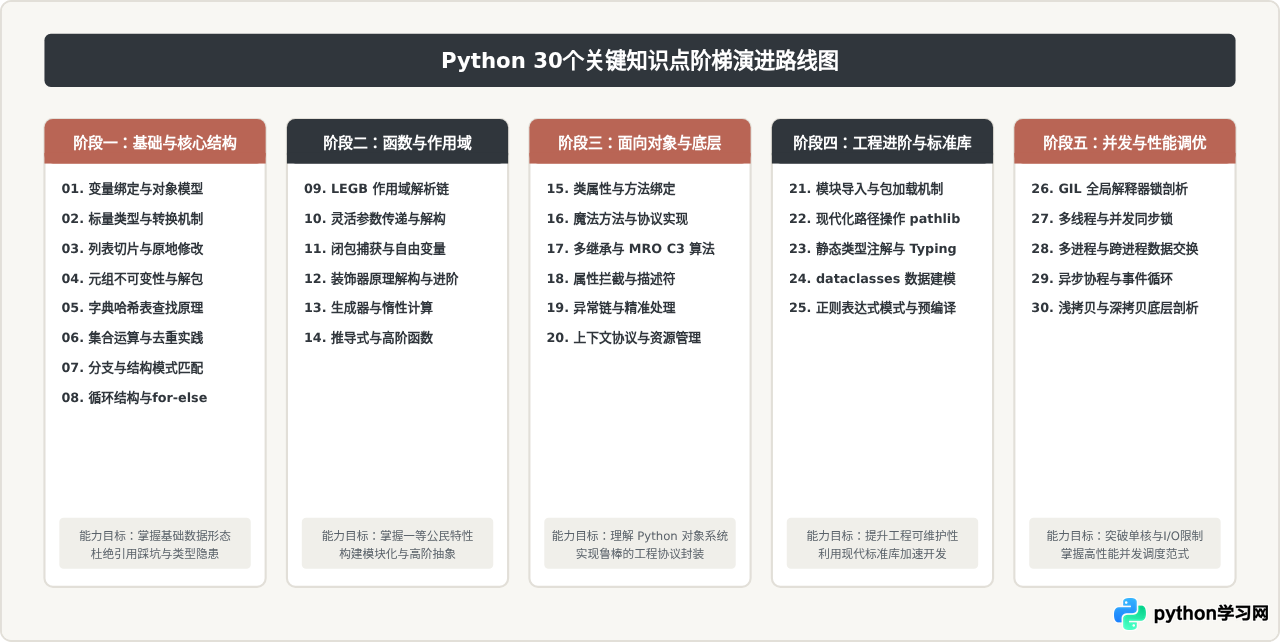
第一阶段:基础语法与核心数据结构(知识点 01 - 08)
掌握Python的第一步并非死记硬背语法糖,而是理解变量与内存数据的解耦关系,以及内置数据容器在底层性能特征上的差异。
在Python中,变量并不像C语言那样是分配固定大小的内存格子,而是指向对象地址的“标签”(Reference)。赋值操作本质是让名字与具体对象建立绑定关系。Python中每个对象包含三个核心要素:身份标识(id())、数据类型(type())和实际数值。
a = [1, 2, 3]
b = a          # 传递引用,并非创建新列表
b.append(4)
print(a) # 输出: [1, 2, 3, 4],a与b指向同一块内存声明 x = 256 和 y = 256,判断 x is y 的结果;随后声明 m = 1000 和 n = 1000,在交互式命令行中验证 m is n。观察并解释小整数对象池(-5 至 256)对内存绑定的影响。
Python的 bool 是 int 的直接子类,在算术计算中 True == 1 且 False == 0。而浮点数采用 IEEE 754 双精度标准,直接比较浮点数相等性会导致不可预期的逻辑漏洞。
import math

x = 0.1 + 0.2
print(x == 0.3)                  # 输出: False
print(math.isclose(x, 0.3)) # 输出: True,工程上的安全比较方案编写一段代码,分别测试 isinstance(True, int) 和 type(True) is int。说明为什么在类型严谨性校验时推荐使用后者或类型注解。
列表是动态连续指针数组。常见的 list.sort() 是原地快速排序(Timsort),返回值是 None;而 sorted(list) 则会构建一个全新列表。切片赋值(nums[1:3] = [8, 9, 10])可以直接在原数组上替换甚至插入不同长度的元素段,无需整体移动指针。
nums = [1, 2, 3, 4, 5]
nums[1:4] = [20, 30]  # 原地替换中间三个元素为两个新元素
print(nums) # 输出: [1, 20, 30, 5]给定列表 data = [1, 2, 3, 4, 5, 6],仅使用切片赋值语句 data[::2] = ...,将所有偶数索引位置的值置为 0,并验证 id(data) 是否未发生改变。
元组的不可变性仅指其存储的引用不可替换。如果元组内包含列表等可变对象,该内部列表的内容依然可以变动。解包语法(Extended Iterable Unpacking)能以声明式的方式快速拆分数据。
first, *middle, last = [10, 20, 30, 40, 50]
# first=10, middle=[20, 30, 40], last=50

t = (1, [2, 3])
t[1].append(4)  # 合法操作:元组指针未变,列表发生变化
print(t) # (1, [2, 3, 4])执行 t = (1, 2, [3, 4]),尝试运行 t[2] += [5]。观察抛出 TypeError 的同时列表内容是否被修改,解释这一经典 Python 陷阱的原因。
Python字典自 3.6 起保证键的插入顺序。作为键的对象必须是可哈希的(实现 __hash__ 与 __eq__,且生命周期内哈希值不变)。字典的查询、添加和删除平均时间复杂度为 O(1)。
# 字典 get 与 setdefault 的工程对比
counts = {}
words = ["apple", "banana", "apple"]
for w in words:
counts[w] = counts.get(w, 0) + 1定义一个自定义类 class Point: def __init__(self, x, y): self.x, self.y = x, y,将其作为字典的键。如果不实现 __hash__ 和 __eq__,观察两个属性相同但实例不同的对象在字典中的查找表现。
集合底层与字典类似,仅保存键而不保存值。集合提供原生的交集(&)、并集(|)、差集(-)和对称差(^)操作,在处理海量无序不重复元素筛选时比遍历列表快几个数量级。
active_users = {"Alice", "Bob", "Charlie"}
vip_users = {"Bob", "David"}
only_regular_active = active_users - vip_users # {'Alice', 'Charlie'}编写函数找出两个包含十万个随机数字的列表中相同的元素,分别对比使用 set(a) & set(b) 与双重 for 循环匹配的运行耗时差异。
自 Python 3.10 引入的结构模式匹配(Pattern Matching)不仅支持简单的常量等值判断,还可以解构复杂的数据字典、元组序列与自定义对象属性,同时支持守卫条件(Guard clauses)。
def handle_event(event):
    match event:
        case {"type": "click", "pos": (x, y)} if x >= 0:
            return f"有效点击坐标: {x}, {y}"
        case {"type": "keypress", "key": key}:
            return f"按键: {key}"
        case _:
return "未知事件"使用 match-case 语法编写一个网络报文协议解析器,匹配包含 {"status": 200, "data": [...]} 与 {"status": 404, "error": msg} 的响应体,提取关键字段。
Python 中 for 和 while 循环均支持 else 子句。其执行逻辑是:当且仅当循环正常遍历完毕、未被 break 中断时触发。该语法常用于无标志位搜索模式。
for n in range(2, 10):
    for x in range(2, n):
        if n % x == 0:
            break
    else:
        # 没有触发 break,说明 n 是质数
print(f"{n} 是质数")在一个任务列表 tasks = [{"id": 1, "done": True}, {"id": 2, "done": False}] 中查找是否存在未完成的任务。要求不使用布尔 flag 变量,仅通过 for-else 结构输出提示。
第二阶段:函数式思维与作用域规则(知识点 09 - 14)
掌握函数是一等公民(First-class citizen)的理念,是迈向模块化与抽象编程的关键跳板。本阶段重点攻克闭包、修饰器与惰性求值体系。
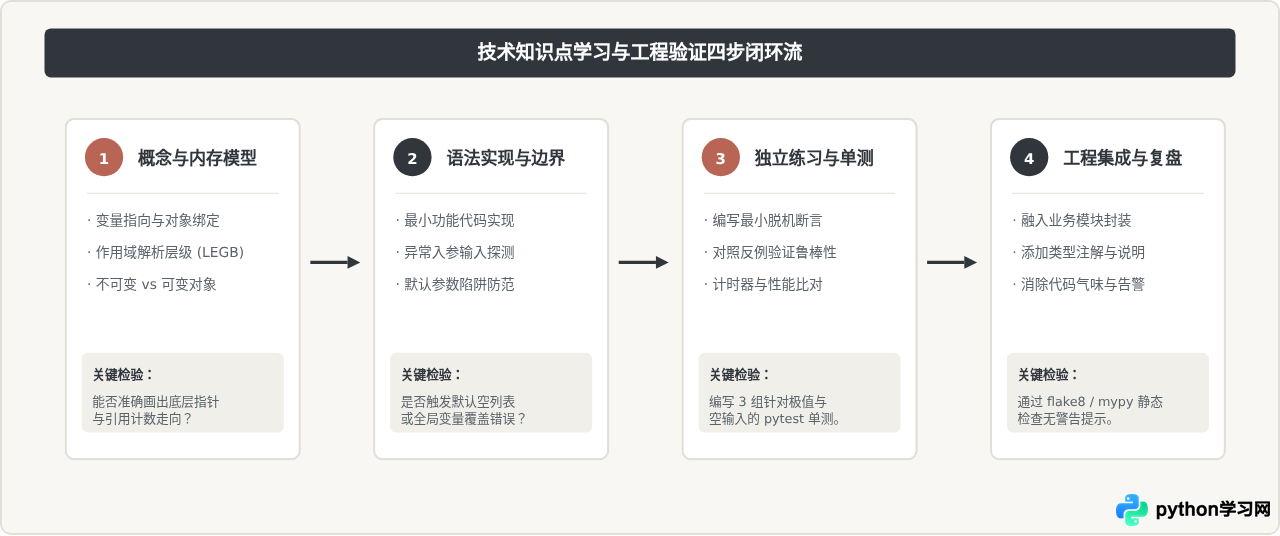
变量查找严格遵循从小到大的作用域搜索链。若在函数内对外部变量进行重新赋值,需要显式使用 global 或 nonlocal 关键字,否则 Python 编译器会在语法分析阶段直接将其标记为局部变量,导致未绑定前引用报错。
val = 10
def outer():
    val = 20
    def inner():
        nonlocal val
        val += 5
        return val
    return inner()
print(outer()) # 输出: 25在函数内部不加 global 关键字,先 print(count) 再执行 count = 1。运行后记录抛出的 UnboundLocalError,并在脑海中画出编译器如何判定该局部变量作用域。
Python 支持通过单星号 * 收集额外位置参数为元组,双星号 ** 收集额外关键字参数为字典。通过单独的 * 作为分隔符,可强制后续参数只能以关键字形式传递(Keyword-only arguments),极大提升接口自解释性。
def connect_db(host, port, *, timeout=30, retry=3):
    return f"连接至 {host}:{port}, 超时: {timeout}s"

# connect_db("localhost", 3306, 60)  # 报错:仅允许传2个位置参数
connect_db("localhost", 3306, timeout=60) # 正确用法设计一个计算数学统计量的函数,前两个参数为必需的数值列表,使用 * 强制要求后续配置项(如 precision=2、filter_nan=True)必须通过显式命名参数传递。
闭包是指一个函数连同其所引用的外部作用域中自由变量(Free Variable)的绑定集合。即便外部外部函数执行完毕退出栈帧,其闭包内部的 __closure__ 单元对象依然保持对该变量的存活引用。
def make_averager():
    series = []
    def averager(new_val):
        series.append(new_val)
        return sum(series) / len(series)
    return averager

avg = make_averager()
print(avg(10))  # 10.0
print(avg(20)) # 15.0检查上面 avg 实例对象的 avg.__closure__[0].cell_contents,查看其内部存储的数据内容,验证闭包持久化机制。
装饰器是高阶函数的语法糖,等价于 func = decorator(func)。在编写自定义装饰器时,必须使用 functools.wraps 修饰内部包装函数,以保留原函数的 __name__、__doc__ 与签名元数据,避免文档与调试工具失效。
from functools import wraps
import time

def timing_decorator(func):
    @wraps(func)
    def wrapper(*args, **kwargs):
        start = time.perf_counter()
        result = func(*args, **kwargs)
        duration = time.perf_counter() - start
        print(f"[{func.__name__}] 耗时: {duration:.5f}s")
        return result
return wrapper实现一个带参数的重试装饰器 @retry(max_attempts=3, delay=1),当被修饰的函数抛出特定网络异常时自动重试指定次数。
当函数内出现 yield 时,该函数转变为生成器工厂。生成器在被调用时不立即执行,而是在迭代调用 next() 时按需生成数据,执行现场保留在生成器帧中。这在处理数十GB的超大日志时具有 O(1) 的常数级内存占用优势。
def read_large_file(file_path):
    with open(file_path, "r", encoding="utf-8") as f:
        for line in f:
yield line.strip()编写一个生成斐波那契数列前 N 项的生成器,与一次性生成相同长度列表的函数进行 sys.getsizeof() 内存占用对比。
推导式不仅代码紧凑,底层通常比 Python 解释器直接运行显式 for-append 循环快 20%-30%,因为其在 CPython 虚拟机层直接调用专用的字节码指令 LIST_APPEND。但推导式嵌套不宜超过两层,以保持可读性。
raw_records = [("Alice", 85), ("Bob", 55), ("Charlie", 92)]
# 字典推导过滤及格名单
passed_map = {name: score for name, score in raw_records if score >= 60}使用单个字典推导式,将一个包含重复键值对的列表进行翻转(值作为键,键作为列表存储对应重复值)。
第三阶段:面向对象与高级语言特性(知识点 15 - 20)
Python的面向对象强调协议(Protocol)与鸭子类型(Duck Typing)。通过魔法方法与属性拦截,可以构建优雅且表现力极强的框架级API。
类属性由所有实例共享,定义在类体内部;实例属性通过 self.attr 挂载在具体实例的 __dict__ 上。类方法通过 @classmethod 接收 cls 参数,静态方法 @staticmethod 则脱离隐式绑定,类似放在类命名空间下的普通函数。
class Config:
    env = "production"  # 类属性

c1 = Config()
c2 = Config()
c1.env = "staging"      # 仅在 c1 实例字典中创建新键,不影响类属性
print(Config.env, c2.env, c1.env) # production production staging创建一个类,在类属性中定义一个空列表 items = [],通过两个不同实例向该属性调用 append。观察并说明为什么类级别的可变对象会导致跨实例数据污染。
Python一切自定义行为皆由协议驱动。重载 __repr__ 提供面向调试者的准确字符串表达;重载 __str__ 面向用户;实现 __add__、__eq__ 可以让自定义对象原生支持 + 和 ==。
class Vector:
    def __init__(self, x, y):
        self.x, self.y = x, y
    def __repr__(self):
        return f"Vector({self.x}, {self.y})"
    def __add__(self, other):
        return Vector(self.x + other.x, self.y + other.y)

v1 = Vector(1, 2)
v2 = Vector(3, 4)
print(v1 + v2) # Vector(4, 6)为 Vector 类实现 __len__(返回模长整数)和 __getitem__ 方法,使得该类支持下标访问 v[0] 以及 len(v) 运算。
Python使用 C3 线性化算法决定多继承中 super() 的调用路径。super() 并非寻找当前类的“直接父类”,而是在 MRO 顺序链上寻找“当前类的下一个类”。
class A:
    def ping(self): print("A")
class B(A):
    def ping(self): super().ping(); print("B")
class C(A):
    def ping(self): super().ping(); print("C")
class D(B, C):
    def ping(self): super().ping(); print("D")

# 查看 MRO: D -> B -> C -> A -> object
print(D.mro())实例化 d = D() 并调用 d.ping(),记录其完整打印顺序。观察 C 是否在 B 之后被触发,印证协同式多继承机制。
@property 将方法调用伪装为属性读写,可无缝嵌入数据校验逻辑。底层更通用的机制是描述符协议(实现 __get__、__set__、__delete__),ORM 框架(如 SQLAlchemy、Django ORM)的字段定义完全依赖描述符实现。
class NonNegative:
    def __set_name__(self, owner, name):
        self.name = name
    def __set__(self, instance, value):
        if value < 0:
            raise ValueError(f"{self.name} 不能为负数")
        instance.__dict__[self.name] = value

class Product:
price = NonNegative()编写一个类型限定描述符 Typed(expected_type),在设置属性时若传入类型不符合预期,主动抛出 TypeError。
精准捕获特定异常胜过泛泛捕获 Exception。else 块在无异常时执行,finally 无论是否报错均执行。使用 raise ... from e 显式挂载异常链,能够清晰追溯根本错误上下文。
def fetch_data(key):
    data_store = {"a": 1}
    try:
        val = data_store[key]
    except KeyError as exc:
        raise ValueError(f"无效的业务查询键: {key}") from exc
    else:
return val * 10编写一个自定义异常 DatabaseTimeoutError,在捕捉到原生 TimeoutError 时使用 from 重新抛出,并打印其 __cause__ 属性。
with 语句提供安全的资源释放屏障。当代码块执行退出或抛出异常时,__exit__(exc_type, exc_val, exc_tb) 会被确定性调用;返回 True 则可吞掉该异常。标准库 contextlib.contextmanager 装饰器可通过生成器快速定义上下文。
from contextlib import contextmanager

@contextmanager
def transaction():
    print("开启事务")
    try:
        yield
        print("提交事务")
    except Exception:
        print("回滚事务")
raise实现一个 Timer 上下文管理器类,使用 with Timer() as t: 自动统计并打印其包含代码段的纳秒级运行时间。
第四阶段:工程进阶与标准库利器(知识点 21 - 25)
摆脱玩具代码的关键在于理解工程规范、模块划分、静态类型体系以及利用成熟标准库提升生产力。
导入模块时,Python 按照 sys.path 列表中注册的目录依次检索。首个条目通常是当前运行主脚本所在的目录。理解相对导入(from .sub import util)要求当前文件必须作为包内模块运行,而非直接以主程序入口脚本运行。
import sys
from pathlib import Path

# 工程中动态规整搜索路径方案
project_root = Path(__file__).resolve().parent.parent
if str(project_root) not in sys.path:
sys.path.insert(0, str(project_root))创建一个包含 __init__.py 的子包,在其中尝试直接使用 from ..brother import test 相对导入,直接运行该文件,记录报错并在根目录下改用 python -m package.module 方式启动验证。
相比于陈旧且容易拼接错误的 os.path 字符串处理方式,pathlib.Path 提供了跨平台的纯面向对象路径语义,支持 / 运算符直接拼接路径,同时内建 read_text()、glob() 与文件属性查询。
from pathlib import Path

config_dir = Path.home() / ".myapp" / "config"
config_dir.mkdir(parents=True, exist_ok=True)
log_file = config_dir / "app.log"
log_file.write_text("服务启动记录", encoding="utf-8")使用 Path(".").rglob("*.py") 递归查找当前目录及其子目录下所有 Python 文件,并输出每个文件的大小和行数。
类型注解不会影响运行时性能,但它为 IDE 智能提示与 mypy 静态代码检查提供了关键依据。掌握 Union, Optional, Callable 以及泛型 TypeVar 是编写工业级库的基础。
from typing import TypeVar, Sequence

T = TypeVar("T")

def first_element(items: Sequence[T]) -> T | None:
return items[0] if items else None为一个接收回调函数 Callable[[int, str], bool] 的接口编写类型签名,使用 mypy 命令检测传入不合规入参时触发的错误提示。
@dataclass 装饰器能够自动生成 __init__、__repr__、__eq__ 等重复样板代码。配合 frozen=True 参数,可以快速声明具备哈希属性的只读领域模型。
from dataclasses import dataclass, field

@dataclass(frozen=True)
class UserProfile:
    uid: int
    username: str
    tags: tuple = field(default_factory=tuple)

u = UserProfile(1001, "dev_user", ("python", "backend"))
# u.uid = 1002 # 触发 FrozenInstanceError 异常声明一个 frozen=True 的 dataclass,验证其是否能作为字典的 Key;再声明一个默认可变的 dataclass,观察其是否可作为 Key。
处理重复文本过滤时,使用 re.compile() 将正则表达式编译为底层 C 状态机对象,避免在循环体内重复解析正则语法树。善用命名分组 (?P<name>...) 能大幅改善后处理可维护性。
import re

pattern = re.compile(r"(?P<year>\d{4})-(?P<month>\d{2})-(?P<day>\d{2})")
match = pattern.search("发布时间:2026-10-21")
if match:
print(match.groupdict()) # {'year': '2026', 'month': '10', 'day': '21'}编写一个预编译正则表达式,从一段混杂文本中精准抽取出符合 RFC 5322 规范的电子邮件地址,并捕获用户名与域名两部分。
第五阶段:并发编程与底层性能调优(知识点 26 - 30)
在涉及高频 I/O 读写或重度 CPU 计算时,必须认清 CPython 的底层线程机制与内存拷贝机制,合理选型并发方案。
CPython 解释器内建的全局解释器锁(GIL)确保同一进程中同一时刻只有一个操作系统原生线程在执行 Python 字节码。因此,多线程在处理 CPU 密集型计算(如大矩阵运算、哈希爆破)时无法利用多核,甚至因频繁的线程上下文切换导致耗时反增;但在 I/O 密集型任务(网络请求、磁盘文件读写)中,系统调用会主动释放 GIL,从而获得高并发加速。
# 场景选型决策依据
# CPU 密集型任务 -> 使用 multiprocessing (多进程)
# I/O 密集型网络高并发 -> 使用 asyncio (协程) 或 threading (多线程)编写一段进行 5000 万次累加运算的代码,分别使用单线程和两个 threading.Thread 并发执行,对比执行时间,验证多线程未能加速 CPU 密集任务的现象。
即使存在 GIL,Python 线程也不是绝对安全的。由于字节码指令间的调度不可预测,类似 n += 1 这种非原子操作在多线程下必定产生竞争条件(Race Condition)。必须使用互斥锁 threading.Lock 或可重入锁 threading.RLock 实施临界区防护。
import threading

counter = 0
lock = threading.Lock()

def safe_increment():
    global counter
    with lock:
counter += 1启动 10 个线程,每个线程对未加锁的全局变量 count 执行 100,000 次加一,观察最终 count 是否偏离 1,000,000;随后加入互斥锁消除偏差。
多进程通过创建独立的操作系统子进程绕过 GIL 限制,每个子进程独享独立的 Python 解释器与内存空间。跨进程传输数据必须经过序列化(Pickling),可通过 multiprocessing.Queue 或 Pipe 建立安全的通信管道。
from multiprocessing import Process, Queue

def worker(q):
    q.put("子进程计算结果: 42")

if __name__ == "__main__":
    queue = Queue()
    p = Process(target=worker, args=(queue,))
    p.start()
    print(queue.get())
p.join()使用 multiprocessing.Pool 的 map 方法,将一个包含多个计算任务的列表分配到所有 CPU 物理核心上并发处理,记录加速比。
协程是单线程架构下的协同式多任务调度机制。通过 async def 定义协程,在发生 I/O 阻塞处主动 await 让出控制权,由底层的 asyncio 事件循环调度其它任务,消除了线程创建与上下文切换的重度开销。
import asyncio

async def fetch_api(idx):
    print(f"请求发起: {idx}")
    await asyncio.sleep(1)  # 模拟非阻塞 I/O
    return f"结果 {idx}"

async def main():
    results = await asyncio.gather(*(fetch_api(i) for i in range(5)))
    print(results)

asyncio.run(main())编写一个包含 10 个并发网络爬虫任务的 asyncio 脚本,使用 asyncio.Semaphore(3) 限制同时处于活跃状态的最大请求数量不超过 3 个。
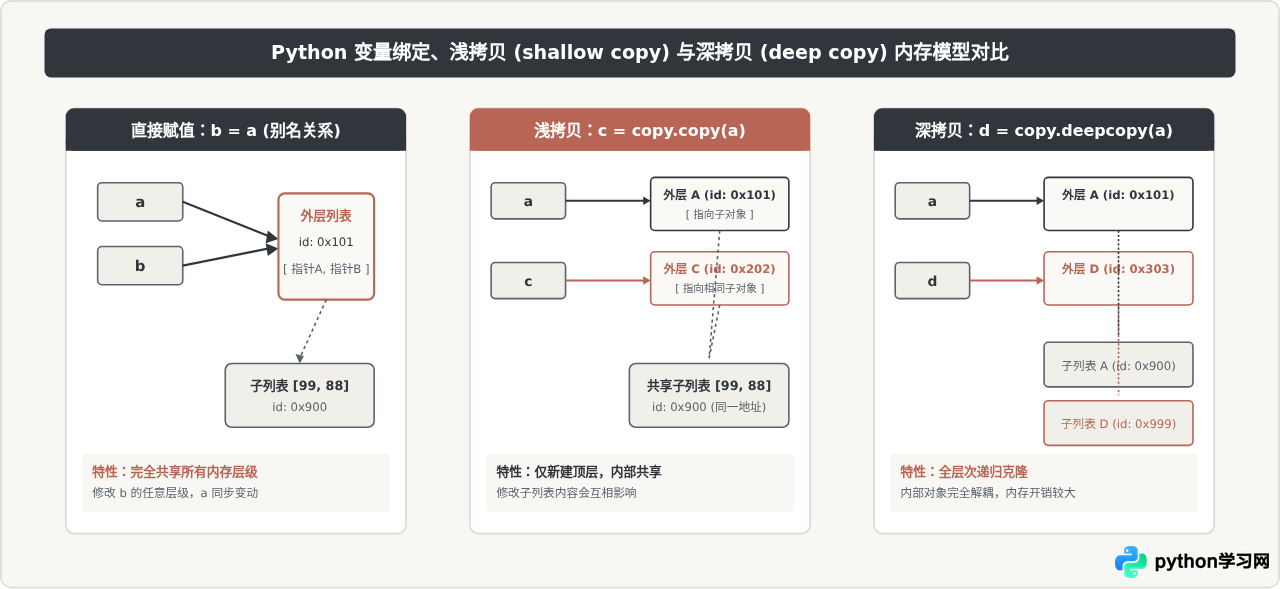
Python 中直接赋值仅创建别名;copy.copy() 创建顶层容器副本,但内部嵌套子对象依然引用原地址;copy.deepcopy() 递归遍历对象图并完整复制所有子对象。深拷贝具备备忘录机制(Memo 字典),可以妥善处理自循环引用死锁。
import copy

data = [1, [2, 3]]
shallow = copy.copy(data)
deep = copy.deepcopy(data)

data[1].append(4)
print(shallow)  # [1, [2, 3, 4]] -> 子列表受影响
print(deep) # [1, [2, 3]] -> 完全隔离不受影响构造一个具有自引用的复杂字典:a = {}; a['self'] = a。分别执行 copy.copy(a) 与 copy.deepcopy(a),验证深拷贝是否会发生无限递归栈溢出,并说明其背后的内部映射字典工作机制。
总结与技能自测矩阵
掌握这 30 个关键知识点并非一蹴而就。建议按照下图总结的能力矩阵逐阶段打卡验证。先在 REPL 交互式环境或 pytest 单测中证实底层原理,再将其引入工程业务重构,便能真正建立稳健的 Python 知识体系。
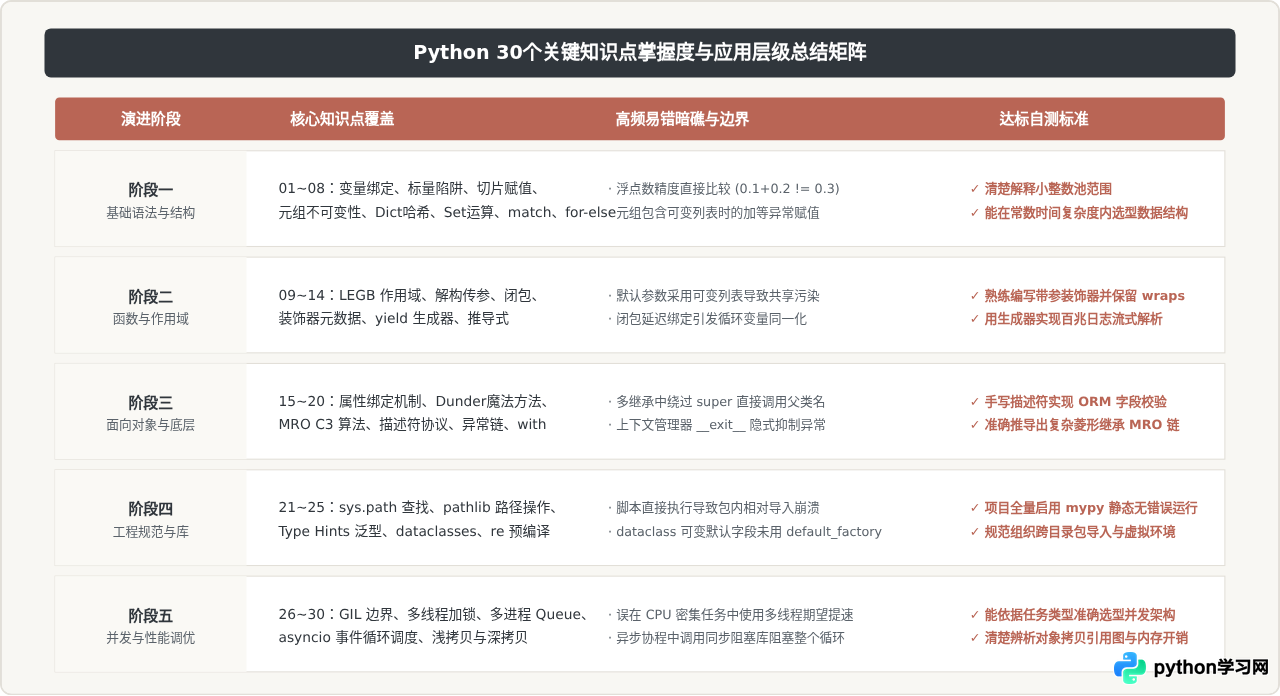
.py 练习脚本或使用 pytest 编写针对性的断言测试用例。只有当代码运行结果完全符合预期、反例报错清晰重现时,该知识点才算真正内化为可用的工程技能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









