

怎么用NumPy读取带表头或自定义分隔符的CSV文件

在 NumPy 中读取带表头或自定义分隔符的 CSV 文件,核心依赖两个底层函数:规则纯数值数据使用 numpy.loadtxt,配置 delimiter 明确指定分隔符,并通过 skiprows=1 跳过首行表头;若文件包含文本列、缺失值或需要直接将表头转化为字段名,则使用功能更全面的 numpy.genfromtxt,配合 skip_header=1(或 names=True)及 dtype=None 即可完成高容错解析。
一、核心选型:明确 np.loadtxt 与 np.genfromtxt 的分工
NumPy 本质上是面向多维稠密数组设计的计算库。标准的 CSV 文件默认使用半角逗号分隔数据,但真实工作环境中的文本格式千差万别,例如由欧洲区域设置导出的分号(;)分隔文件、数据库导出的制表符(\t)或竖线(|)对齐文件,且文件顶部往往附带一至多行字段名表头。
在开始调用之前,先理清 NumPy 提供的两款加载函数的定位差异至关重要:np.loadtxt 属于轻量级高效率方案,专为格式规整、行列齐整的纯数值矩阵打造;而 np.genfromtxt 引入了两遍读取机制(Two-pass generator),专为异构数据、表头提取及缺失值填补设计。
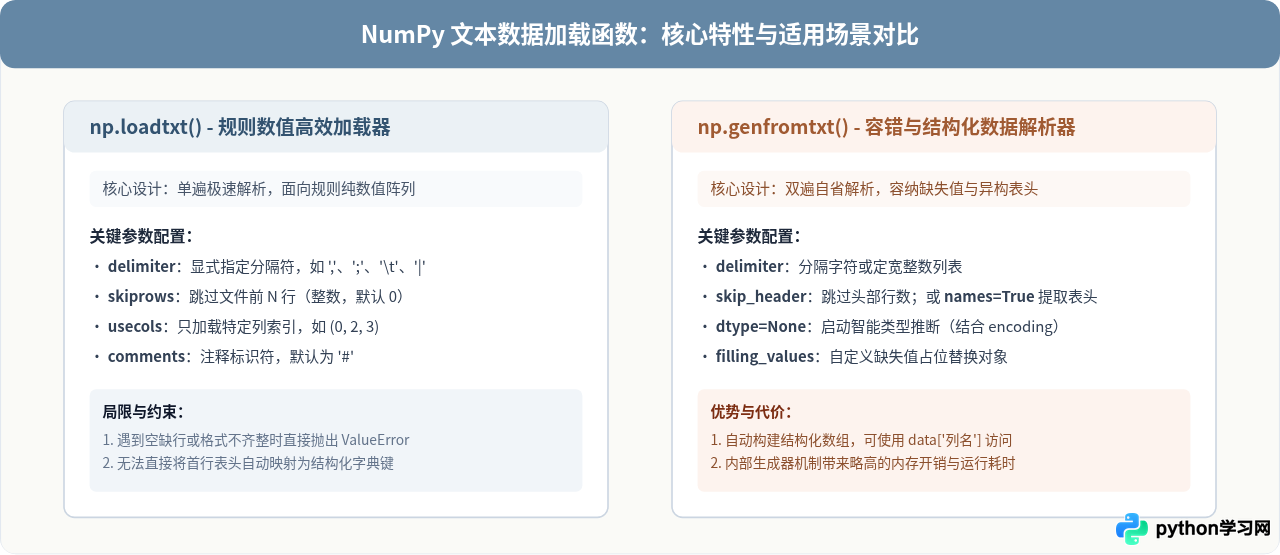
二、基础实践:用 np.loadtxt 处理规则数值型文件
当 CSV 文件由仪器、仿真脚本或纯数值计算程序生成,内容除表头外均为浮点数或整数,且分隔符为制表符(Tab)或分号时,np.loadtxt 是最直接高效的工具。
1. 典型数据与代码示例
假设存在一个以制表符分隔的传感器读数文件 sensors_tab.csv,内容如下:
# 示例文件:sensors_tab.csv
Timestamp	Voltage	Current	Resistance
1001	4.98	0.45	11.06
1002	5.01	0.46	10.89
1003	4.97	0.44	11.29
1004	5.02	0.47	10.68
使用 np.loadtxt 正确读取该文件的完整 Python 代码如下:
import numpy as np

# 通过 skiprows=1 避开首行英文字段名,delimiter='\t' 识别制表符
data = np.loadtxt(
    'sensors_tab.csv',
    delimiter='\t',
    skiprows=1,
    dtype=float
)

print("数据矩阵形状 (Shape):", data.shape)
print("第一行数据值:", data[0])
print("电压列平均值 (第2列):", np.mean(data[:, 1]))
终端示例输出:
数据矩阵形状 (Shape): (4, 4)
第一行数据值: [1.001e+03 4.980e+00 4.500e-01 1.106e+01]
电压列平均值 (第2列): 4.995
2. 关键参数行为解析
delimiter='\t':明确告诉解析器列与列之间由制表符分割。若分隔符是分号则传入delimiter=';',竖线传入delimiter='|'。若不配置该参数,默认按任意连续空白字符切割。skiprows=1:直接在文本行遍历的游标阶段跳过第 1 行。因为np.loadtxt默认尝试将读到的所有字符转为float,若不跳过包含英文字母的表头,程序会直接报错ValueError: could not convert string to float: 'Timestamp'。usecols=(1, 2):如果只需要特定的几列(例如只要电压和电流),可以通过此参数指定列索引元组,减少不必要的内存占用。
三、进阶方案:用 np.genfromtxt 灵活解析表头与非标准分隔符
现实中的数据往往更复杂:各列数据类型不一致(例如包含日期字符串、产品类别与浮点数),且我们希望保留表头文字,以便通过列名直接筛选数据。此时应采用 np.genfromtxt。
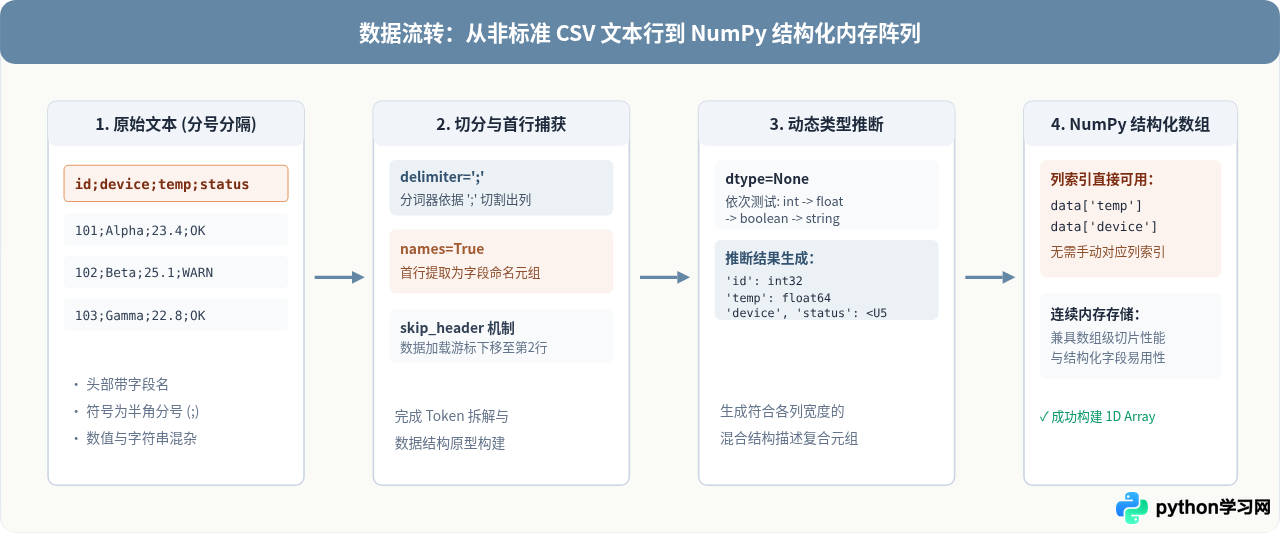
1. 自动提取表头为列名的代码实战
假设存在一个以分号分隔的业务文件 orders_semicolon.csv:
order_id;customer;amount;status
202401;Acme Corp;1580.50;Shipped
202402;Globex Inc;230.00;Pending
202403;Soylent LLC;890.20;Shipped
202404;Initech;450.75;Delivered
利用 names=True 和 dtype=None 自动读取该文件的 Python 代码:
import numpy as np

# names=True 表示使用第一行作为字段名
# dtype=None 表示自动识别各列的最佳数据类型
# encoding='utf-8' 确保文本解码一致
data = np.genfromtxt(
    'orders_semicolon.csv',
    delimiter=';',
    names=True,
    dtype=None,
    encoding='utf-8'
)

print("提取出的字段名称:", data.dtype.names)
print("订单金额列 (amount):", data['amount'])
print("金额总和:", np.sum(data['amount']))
print("已发货客户:", data['customer'][data['status'] == 'Shipped'])
终端示例输出:
提取出的字段名称: ('order_id', 'customer', 'amount', 'status')
订单金额列 (amount): [1580.5   230.    890.2   450.75]
金额总和: 3151.45
已发货客户: ['Acme Corp' 'Soylent LLC']避坑提示:在 Python 3 中使用 dtype=None 时,务必同时显式声明 encoding='utf-8'(或文件对应的实际编码如 gbk)。如果不传 encoding 参数,字符串列在 NumPy 中会被默认解码为字节串(形如 b'Acme Corp'),后续用普通字符串做等值匹配时将无法命中。
四、操作步骤:排查与读取非标准 CSV 的 4 步规范流程
在面对未知格式的文本数据时,切忌盲目直接运行 np.loadtxt,否则极易因未预料的字符、行尾多余分隔符或编码差异引发崩溃。建议按照以下 4 步标准化流程推进:
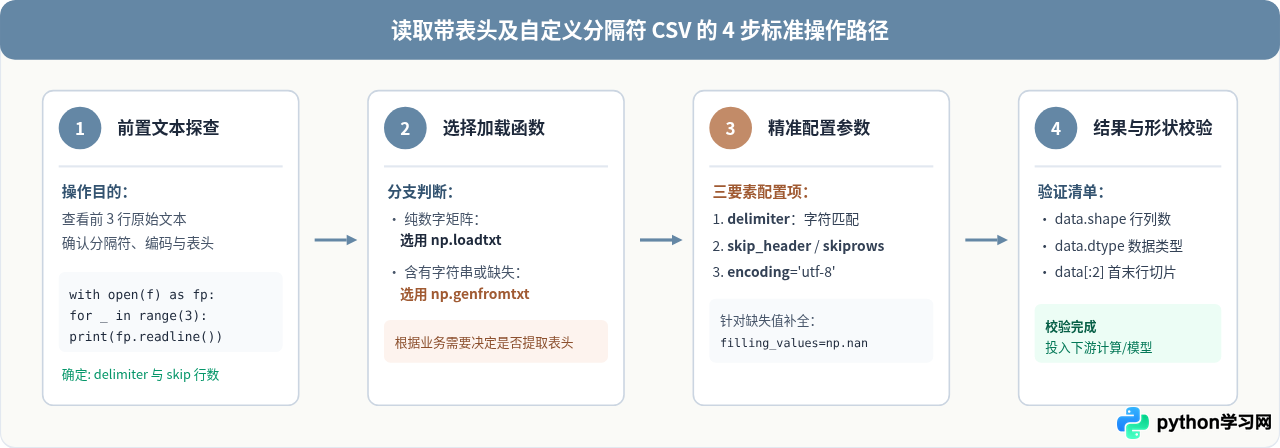
步骤 1:探查样本文本(避免盲目调用)
在 Python 中利用内置模块快速预览目标文件的前 2 行,获取分隔符形态与表头行数:
# 探查脚本
with open('data_sample.csv', 'r', encoding='utf-8') as f:
    for idx in range(2):
        print(f"Line {idx}: {repr(f.readline())}")
通过输出内容观察:分隔符是逗号、分号、制表符还是竖线?首行是否为列名文字?第二行是否出现缺失字段(如 ;; 或两个连续分隔符)?这一步可以彻底避免后续参数配置错误。
步骤 2 与 3:针对性设置加载参数
根据探查结果选择参数:
- 跳过多行表头:部分科研仪器导出的文件前几行是元数据(如实验编号、采样率、时间),真实数据从第 5 行开始。此时只需在
np.loadtxt中指定skiprows=4,或在np.genfromtxt中指定skip_header=4。 - 使用竖线或特殊分隔符:例如日志文件常用
delimiter='|'。 - 处理末尾多余分隔符:如果某些软件导出的 CSV 每行末尾都多打了一个分隔符(如
1;2;3;),NumPy 会误认为末尾存在一列空数据。此时若用np.loadtxt会报列数不匹配错误,而使用np.genfromtxt(..., usecols=(0, 1, 2))明确指定只提取前三列即可完美解决。
步骤 4:数据验证与结构确认
读取后应立即打印 data.shape 与 data.dtype。对于使用 names=True 得到的结构化数组,其 shape 是一维的(每个元素是一个包含各字段的 record),若需要传统的二维纯数值矩阵进行矩阵乘法等线性代数运算,可以使用以下方式转换:
# 如果读取时指定了 names=True,但后续算法需要 2D ndarray:
# 方式 A:在读取阶段就明确只读数值列且不使用 names=True
pure_matrix = np.genfromtxt(
    'orders_semicolon.csv',
    delimiter=';',
    skip_header=1,
    usecols=(0, 2), # 仅提取数值索引列
    dtype=float
)
print("数值矩阵维度:", pure_matrix.shape)  # 输出 (4, 2)
五、常见报错排查与决策指南
在实际操作中,读者最常遇到的两类异常及其成因如下:
| 报错信息 | 根本原因 | 针对性解决方案 |
|---|---|---|
ValueError: could not convert string to float: '...' |
使用 np.loadtxt 时未跳过文本表头,或某列包含非数值字符。 |
检查首行,添加 skiprows=1;或改用 np.genfromtxt(..., dtype=None, encoding='utf-8')。 |
Line # could not be parsed / Wrong number of columns |
某一行缺失值、行尾有多余分隔符,或文件中包含未注释的说明文字。 | 1. 使用 usecols 显式固定列索引;2. 改用 genfromtxt 并设置 invalid_raise=False 忽略异常行。 |
字符匹配失败或包含 b'...' 前缀 |
未显式指定文本编码,字符串被解析为原生字节串(bytes)。 | 在 np.genfromtxt 中增加 encoding='utf-8' 或 encoding='gbk'。 |
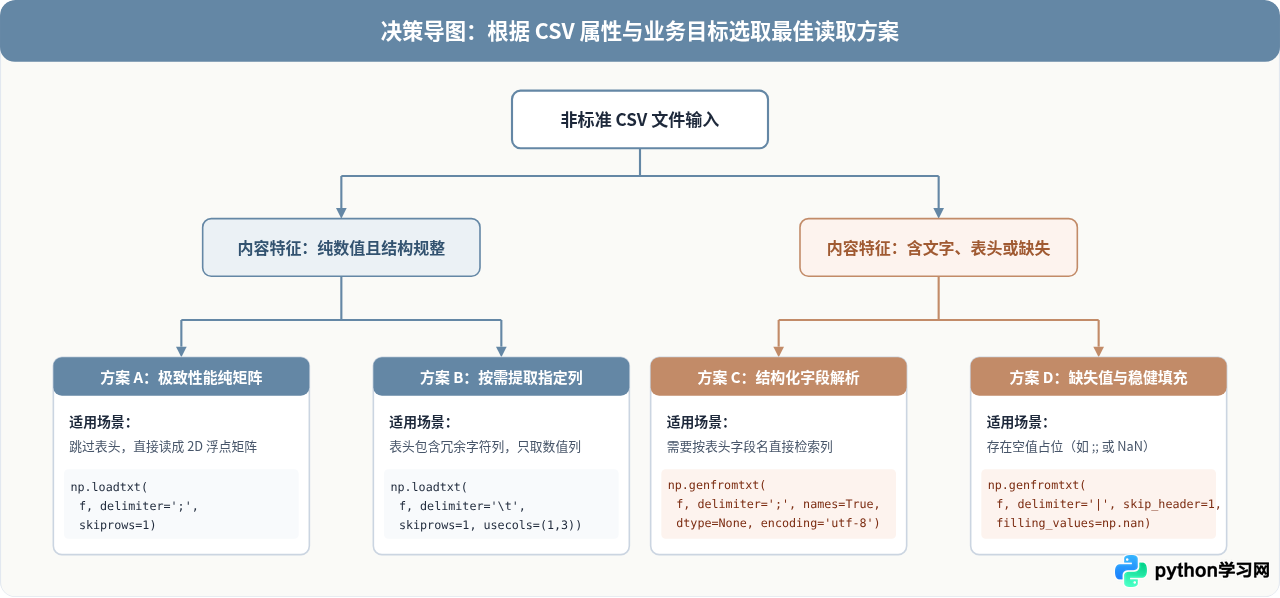
六、总结与使用建议
掌握 NumPy 读取带表头与自定义分隔符 CSV 文件的关键,在于精准把握数据规整度与解析开销之间的平衡:
- 对于算法训练、数值模拟或大体量网格数据,使用
np.loadtxt(filename, delimiter='...', skiprows=N)能够获得最高的执行速度与最低的内存占用。 - 对于含有文本标识、多类型混合字段或需要借助字段名进行切片的场景,优先使用
np.genfromtxt(filename, delimiter='...', names=True, dtype=None, encoding='utf-8')。 - 在编写生产环境脚本时,养成先探查前两行字符特征的习惯,显式配置
encoding与delimiter,能够有效阻断绝大多数潜在的数据解析异常。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









